


Python实现电脑壁纸批量爬取:从环境配置到完整代码解析

本文详细介绍如何使用Python编写一个简单的爬虫程序,批量下载电脑壁纸。通过结合Requests进行HTTP请求、XPath解析HTML结构以及Pinyin库处理中文路径,实现从指定类型和页码中自动抓取高清壁纸。文章涵盖工具准备、核心代码逻辑解析及完整可运行代码,旨在提供技术交流参考,非商业用途。
前言
良好的编程习惯往往始于撰写技术文章与编写示例代码。本文将演示一个简易的Python图片爬取流程,虽然步骤基础,但有助于梳理爬虫的基本逻辑。请注意,本文内容仅用于技术交流,严禁用于任何商业用途。
一、用到的工具
进行Python爬虫开发,主要依赖以下工具:PyCharm作为集成开发环境,Chrome浏览器用于查看网页源码及调试(也可使用其他浏览器),以及Windows系统自带的浏览器辅助操作。
二、爬取步骤与过程
1.用到的库
本案例主要使用requests库发起网络请求,利用lxml库中的xpath模块快速定位图片链接与路径(也可选用re正则表达式或Beautiful Soup模块)。time库用于在下载间隔添加延时,以尊重服务器负载;pinyin库用于将中文图片类型转换为拼音,便于构建合法的URL路径。
import time
import pinyin
import requests
from lxml import etree    #这是导入xpath模块
2.解析代码
首先,程序提示用户输入图片类型及起始页码。由于单一页面无法展示所有图片,通过指定页码可实现多页数据的抓取。
type=input("请输入图片的类型:")
type=pinyin.get(f"{type}",format="strip")   #这是将输入的中文转成拼音,format是为了去掉拼音的声标
m=input("请输入图片的页码:")        #图片类型所在网页的页码
随后,程序向目标网址发起请求,获取网页源代码。利用xpath提取小尺寸图片的链接及文件名。选择小图链接是因为大图通常单独展示,而列表页多显示缩略图,通过小图链接可进一步解析出大图地址。
url=f"https://pic.netbian.com/4k{type}/index_{m}.html"
header={
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/98.0.4758.82 Safari/537.36"
}
resp=requests.get(url=url,headers=header)
resp.encoding="gbk"
tree=etree.HTML(resp.text)
tu_links=tree.xpath('//*[@id="main"]/div[3]/ul/li/a/@href')    #小图片的链接
tu_names=tree.xpath('//*[@id="main"]/div[3]/ul/li/a/b/text()')  #图片的名字
接下来,程序通过循环逐层解析:先获取列表页中小图的链接,拼接成详情页URL;再请求详情页,从中提取高清大图的真实下载地址。
    tu_link.split()
    child_url = url.split(f'/4k{type}/')[0] + tu_link       #将小图片的部分链接和主链接拼接起来
    resp1 = requests.get(url=child_url, headers=header)     #打开小图片的网址
    resp1.encoding = 'gbk'
    tree1 = etree.HTML(resp1.text)
    child_tu_link= tree1.xpath('/html/body/div[2]/div[1]/div[2]/div[1]/div[2]/a/img/@src')     #获取大图片的部分链接
    child_tu_link=child_tu_link[0]
    child_tu_link_over=url.split(f'/4k{type}/')[0]+child_tu_link        #将大图片链接拼接起来
    resp2=requests.get(child_tu_link_over,headers=header)       #获取大图片
最后一步是将获取到的图片二进制内容写入本地文件,完成下载。
    with open(f"壁纸图片/{name}.jpg",mode="wb") as f:           #接下来就是下载了
        f.write(resp2.content)
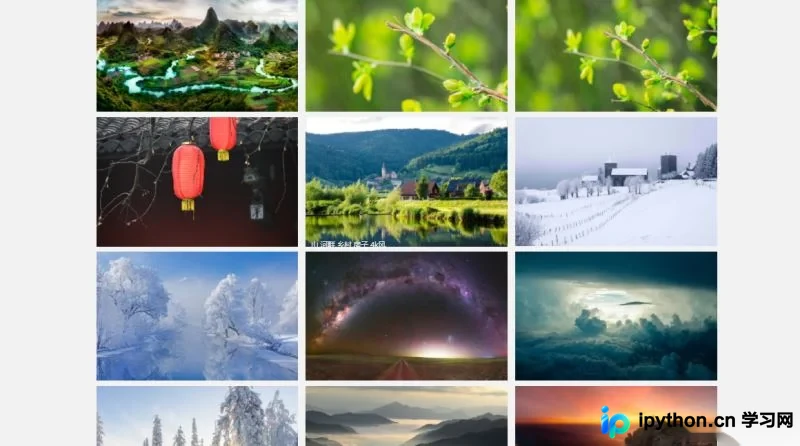
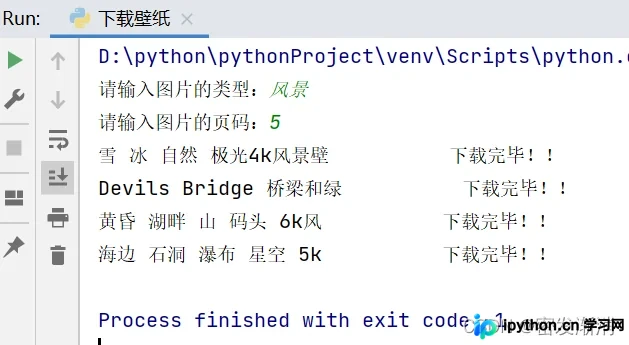
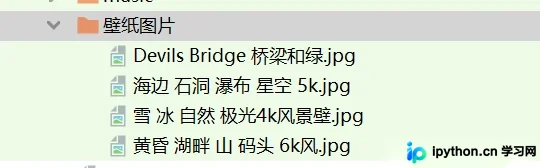
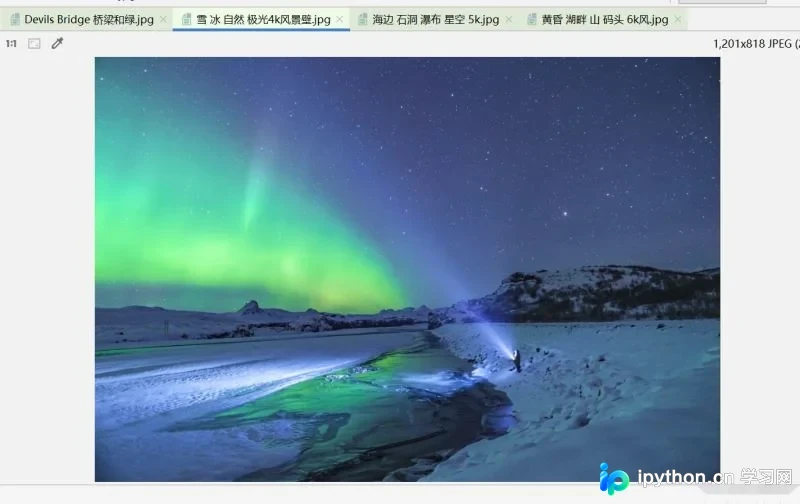
以下是运行后的效果展示。
3.最后上全部的代码啦
上述代码逻辑简单,未涉及复杂算法,适合初学者参考学习。
import time
import pinyin
import requests
from lxml import etree    #这是导入xpath模块
type=input("请输入图片的类型:")
type=pinyin.get(f"{type}",format="strip")   #这是将输入的中文转成拼音,format是为了去掉拼音的声标
m=input("请输入图片的页码:")        #图片类型所在网页的页码
url=f"https://pic.netbian.com/4k{type}/index_{m}.html"
header={
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/98.0.4758.82 Safari/537.36"
}
resp=requests.get(url=url,headers=header)
resp.encoding="gbk"
tree=etree.HTML(resp.text)
tu_links=tree.xpath('//*[@id="main"]/div[3]/ul/li/a/@href')    #小图片的部分链接
tu_names=tree.xpath('//*[@id="main"]/div[3]/ul/li/a/b/text()')  #图片的名字
n=0
for tu_link in tu_links:
    tu_link.split()
    child_url = url.split(f'/4k{type}/')[0] + tu_link       #将小图片的部分链接和主链接拼接起来
    resp1 = requests.get(url=child_url, headers=header)     #打开小图片的网址
    resp1.encoding = 'gbk'
    tree1 = etree.HTML(resp1.text)
    child_tu_link= tree1.xpath('/html/body/div[2]/div[1]/div[2]/div[1]/div[2]/a/img/@src')     #获取大图片的部分链接
    child_tu_link=child_tu_link[0]
    child_tu_link_over=url.split(f'/4k{type}/')[0]+child_tu_link        #将大图片链接拼接起来
    resp2=requests.get(child_tu_link_over,headers=header)       #获取大图片
    name=tu_names[n]
    with open(f"壁纸图片/{name}.jpg",mode="wb") as f:           #接下来就是下载了
        f.write(resp2.content)
        print(f"{name}          下载完毕!!")
        n+=1        #每下载一张图片n就加1
        time.sleep(1.5)
        resp1.close()
print("全部下载完毕!!")       #over!over!
resp.close()        #最后记得要把所有请求的响应关闭
重要提示:本文仅用于技术交流,严禁用于商业用途。如有违规使用,作者概不负责。
总结
至此,关于使用Python爬取电脑壁纸的实例代码介绍完毕。如需了解更多相关技术,请查阅本站往期文章或继续浏览后续内容。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















