



复杂图表在实时交互时,最容易出现的问题不是“功能做不出来”,而是鼠标一动、滚轮一转,主线程就被频繁重绘拖慢。要把 CPU 占用压下来,重点不在于机械地给事件监听器套一个节流函数,而是先分清哪些交互可以合并、哪些必须即时响应,再按渲染层拆分更新路径,最后用缓存和局部绘制减少根本不必要的重绘。
为什么复杂图表里的节流不能只停留在事件层
在 Canvas 或 SVG 场景里,节流如果只加在 mousemove、wheel 这类事件入口,通常只能减少“回调触发次数”,却不一定减少“真正昂贵的绘制成本”。真正有效的做法,是把“重绘触发”和“重绘执行”解耦:事件可以高频到来,但执行端需要有自己的合并、跳过和分层更新策略。
换句话说,节流的目标不是单纯少执行几次函数,而是避免 CPU 被高频事件反复打断。尤其图表交互里常见的缩放、平移、悬停提示,本身就带有连续输入特征,如果不做执行层的合并,主线程仍然会在布局计算、样式更新和绘制之间来回消耗。
先区分哪些交互可以节流,哪些必须保真
不是所有用户操作都适合统一节流。图表交互里,应该先按响应要求做分类:
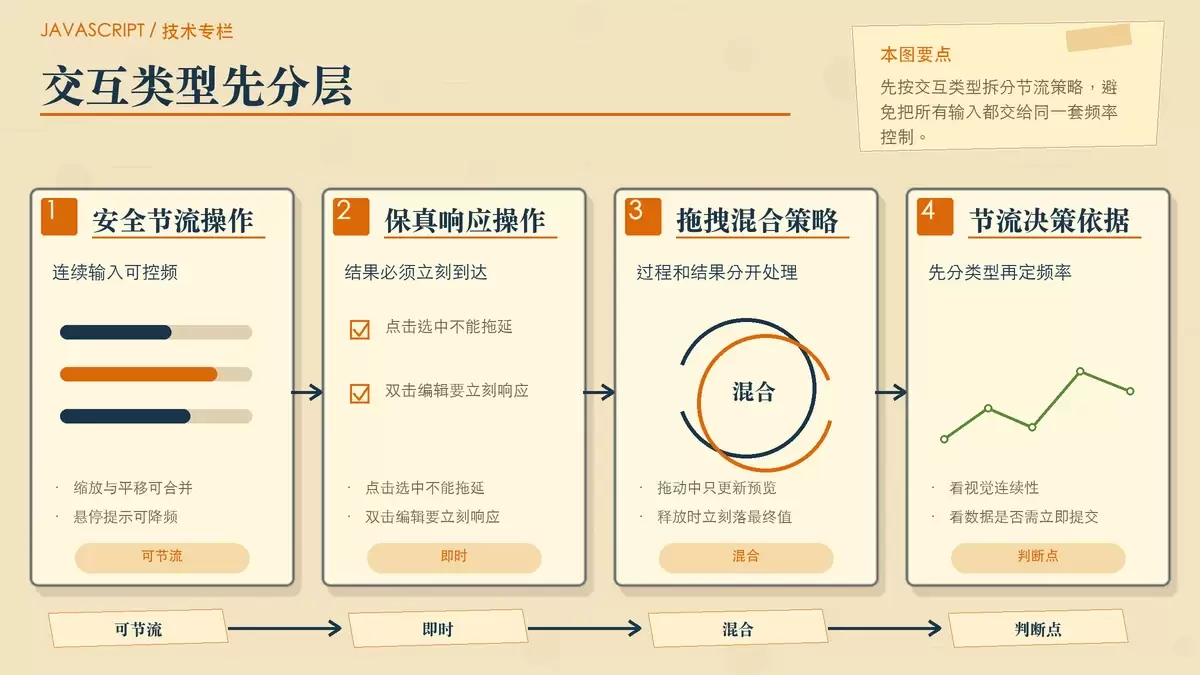
- 可安全节流:缩放(
wheel)、平移(drag move)、鼠标悬停坐标提示、视口边界计算。这类操作往往是连续输入,适合合并更新。 - 需保真响应:点击选中节点、双击编辑、拖拽释放瞬间(
onmouseup)、键盘快捷键如Delete删除。这些操作如果被延迟,用户会直接感知到“没点上”或“反应慢”。 - 混合策略:例如拖拽过程中用节流更新预览位置,但释放时立刻执行最终坐标校准和数据同步。
这里的关键不是把所有交互都压到同一个频率,而是按“视觉连续性”和“数据正确性”分别处理。预览状态允许被合并,但最终提交状态必须立即落地,否则界面看似流畅,业务状态却可能不一致。
按渲染层级设置节流粒度,别把所有更新绑在一起
复杂图表通常不是单层渲染。无论是 Canvas 还是 SVG,常见都会拆成背景网格、静态标签、动态连线、节点、高亮浮层等几个部分。节流粒度应该跟着渲染层级走,而不是只盯着事件监听器。
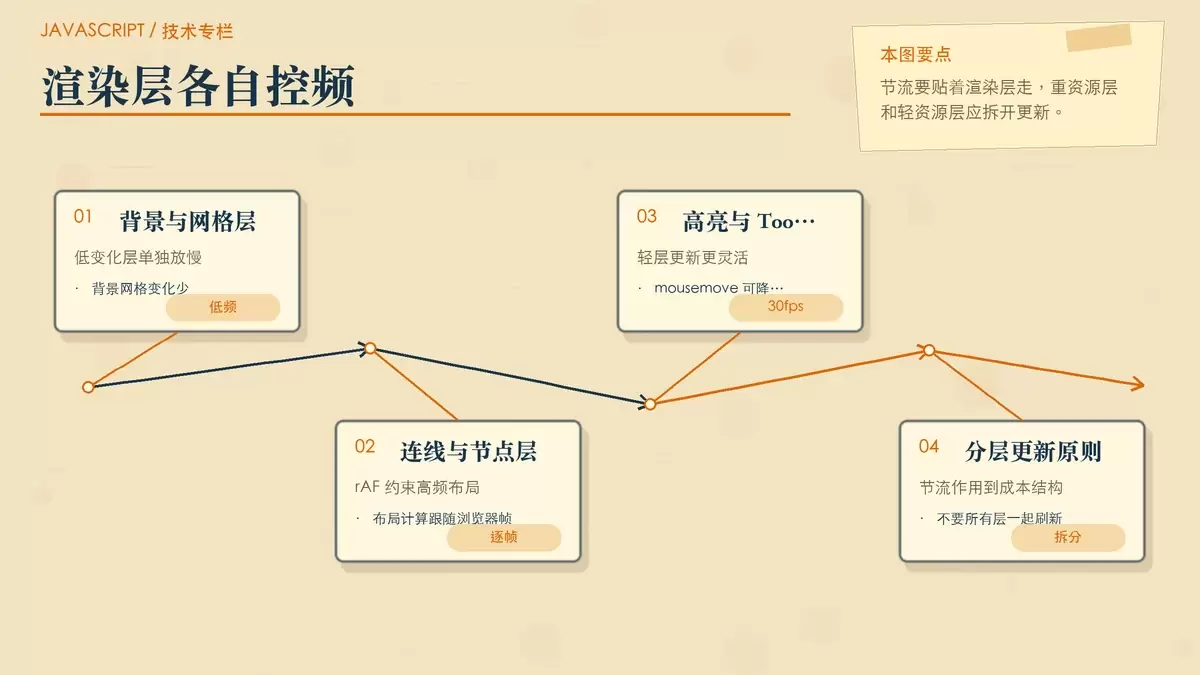
- 背景/网格层:变化频率很低,可以设为
500ms节流,甚至只在resize或zoom改变后重绘。 - 连线/节点位置:适合用
requestAnimationFrame包裹,再结合时间戳判断,保证每帧最多执行一次布局计算,例如 force-graph 的 tick 更新。 - 高亮/Tooltip 层:可对
mousemove节流到30fps(~33ms),再配合IntersectionObserver判断元素是否在视口内,视口外直接跳过。
这样处理的好处是,重资源层和轻资源层不会互相拖累。背景层不需要跟着每次鼠标移动都刷新,Tooltip 层也没必要触发整张图重新布局。把不同层拆开以后,节流才真正开始作用于“成本结构”,而不是只作用于函数调用次数。
为什么 requestAnimationFrame 比单纯时间节流更合适
对节点、连线这类与视觉帧同步关系很强的层,requestAnimationFrame 通常比固定毫秒节流更自然。它能把绘制安排到浏览器准备渲染的时机,避免在一帧内多次重复计算;再结合时间戳判断,还可以防止某些高频输入在单帧内重复触发布局。
这类做法的重点不是追求“每 16ms 必执行一次”,而是确保“每帧最多执行一次、且只执行有意义的更新”。
节流之后还高占用,说明瓶颈不在频率
节流能缓解卡顿,但它不是性能问题的终点。如果加了节流后 CPU 仍持续高于 70%,那通常说明问题不只是事件太密,而是单次重绘本身就太重。
- 如果每次节流回调里都在全量重绘 Canvas,就算次数下降了,单次成本仍然很高。此时应优先改成局部
clearRect+ 增量绘制。 - 在 SVG 场景下,如果节流回调里反复调用
getBBox()或getCTM(),会触发强制同步布局计算,主线程照样会被卡住。 - 可以用 Chrome DevTools 的 Performance 面板录制节流后的火焰图。如果
Layout或Paint占比依旧很高,说明瓶颈还在 CSS 层叠、SVG DOM 操作或绘制管线,需要考虑离屏 canvas 或<use>复用,而不是继续加大节流间隔。
这一步非常重要,因为很多看似“节流无效”的场景,本质上是把一个 30ms 的重绘任务,从每秒执行 100 次改成每秒执行 30 次,虽然有所改善,但仍然足够把交互拖慢。此时继续调节流参数,收益通常很有限。
结合状态缓存做智能节流,核心是直接跳过无效重绘
真正能明显降低 CPU 的方案,往往不是“少触发几次”,而是“很多次根本不画”。这就需要在执行端增加状态缓存和脏检查。
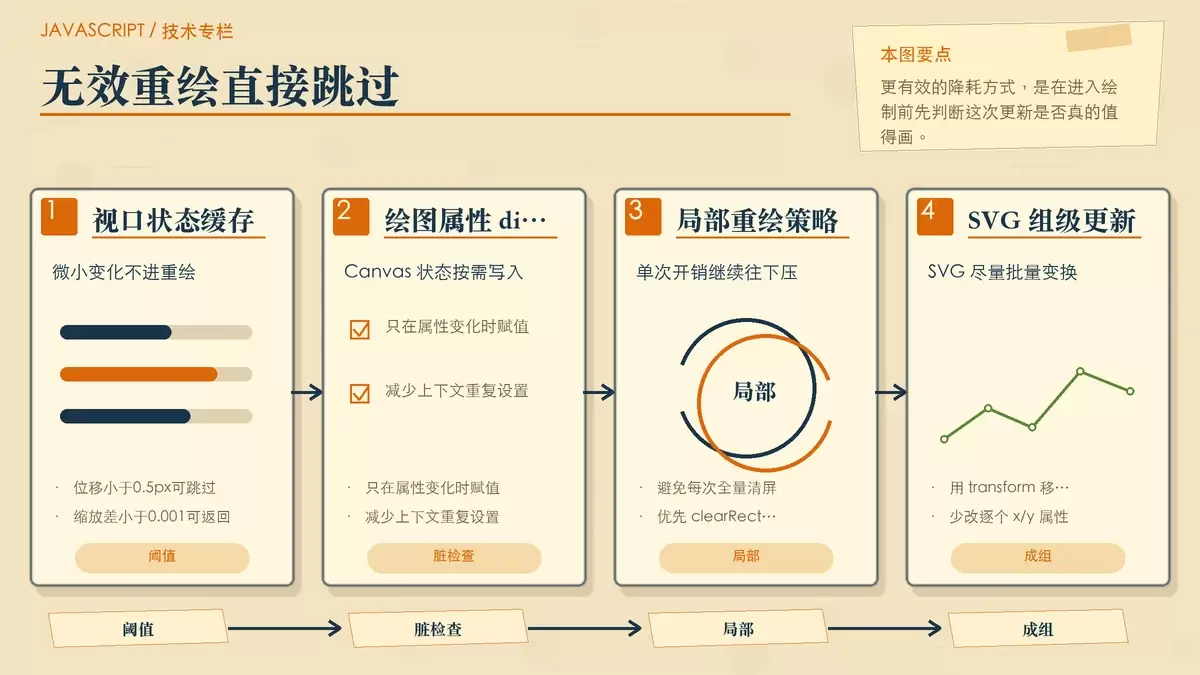
- 记录上一次有效视口范围,例如
x、y、scale。如果新事件带来的位移变化小于0.5px,或者缩放差小于0.001,可以直接return。 - 对 Canvas 绘图上下文属性如
strokeStyle、font、lineWidth做 dirty-check,只有值真正变化时才重新赋值。 - 在 SVG 中,优先用
transform移动整个<g>组,而不是逐个修改x/y属性,避免每个子元素都参与 layout。
这类“智能节流”的本质,是先判断这次输入是否足以改变用户可见结果。如果变化肉眼不可感知,就没必要进入重绘路径。相比单纯延后执行,这种方式对 CPU 的改善通常更稳定,也更不容易牺牲交互手感。
判断节流是否真的生效,可以看这几个信号
如果方案有效,通常会看到几个比较明确的结果:连续拖拽和缩放时帧率更稳定;主线程火焰图里的 Layout、Paint 峰值下降;视口外或微小位移场景的无效绘制明显减少。只有这些指标一起改善,才说明节流已经从“控频”走向“减负”。















