



很多 Node.js 应用上线后,日志还停留在 console.log 阶段:平时难看、出事难查、时间一长还会占满磁盘。真正有用的日志体系,不只是把信息写出来,而是要让你能按级别区分问题、按时间追踪变化,并在异常出现时尽快收到提醒。
这篇文章按 Ubuntu 上常见的部署场景,把日志优化拆成六个实际环节:应用侧记录、系统侧轮转、集中检索、指标监控、定期审查和自动告警。你可以据此判断,自己当前缺的是基础记录能力,还是更进一步的可视化和告警体系。
先把应用日志记录做细
第一步不是上监控平台,而是先让 Node.js 应用本身输出足够可用的信息。只靠零散的 console.log 很难区分普通请求、异常事件和真正需要处理的错误,更不用说后续检索和分析。
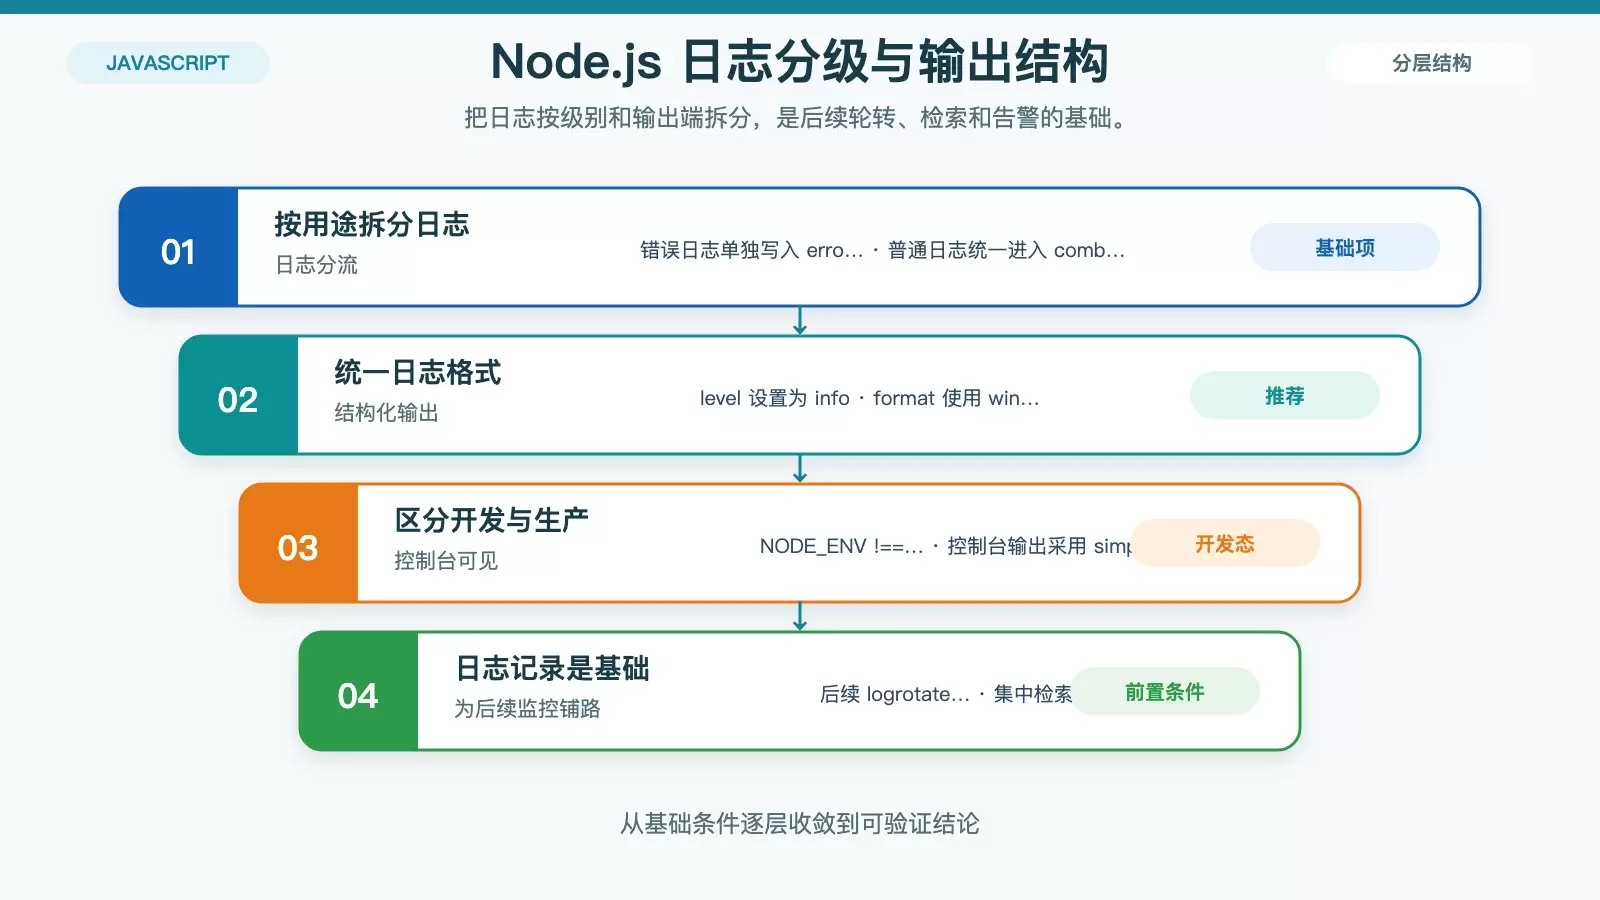
更稳妥的做法,是使用 winston 或 morgan 这类成熟库。它们支持多级别、多格式和多输出端,适合把错误日志、通用日志和开发环境控制台输出分开处理。
例如,下面这段 winston 配置就把错误日志单独写入 error.log,普通日志写入 combined.log,并在非生产环境增加控制台输出:
const winston = require('winston');
const logger = winston.createLogger({
  level: 'info',
  format: winston.format.json(),
  transports: [
    new winston.transports.File({ filename: 'error.log', level: 'error' }),
    new winston.transports.File({ filename: 'combined.log' }),
  ],
});
if (process.env.NODE_ENV !== 'production') {
  logger.add(new winston.transports.Console({
    format: winston.format.simple(),
  }));
}
这一步的价值很直接:后面无论是做轮转、做 ELK 汇聚,还是做异常筛查,都建立在日志本身结构足够清晰的前提上。
用 logrotate 控制日志体积
日志写得越细,文件增长就越快。如果没有轮转策略,几天内吃掉几个 G 的磁盘空间并不夸张。对 Ubuntu 环境来说,最省事也最可靠的方案,就是直接使用系统自带的 logrotate。
安装 logrotate
sudo apt-get install logrotate
配置 Node.js 日志轮转规则
创建 /etc/logrotate.d/nodejs 文件,写入以下规则。这里的含义很明确:每天轮转一次,保留 7 天历史,压缩旧日志,空文件跳过处理,并在轮转后重新创建日志文件。
/var/log/nodejs/*.log {
    daily
    missingok
    rotate 7
    compress
    notifempty
    create 0640 root adm
}
这一层解决的是“日志会不会把机器拖垮”的问题。它不提升排障效率,但能先确保日志系统本身不会成为新的运维负担。
把日志集中到 ELK Stack 检索
当应用数量变多,或者单机日志文件已经难以人工翻查时,集中式日志系统就值得投入了。把日志汇聚到 ELK Stack,意味着你可以按关键词、时间范围和字段结构搜索日志,并直接做可视化分析。
这里的三部分分工比较清楚:
Elasticsearch负责存储和检索Logstash负责采集和转发Kibana负责展示和分析
安装 ELK 组件
依次安装以下服务:
sudo apt-get install elasticsearch
sudo apt-get install logstash
sudo apt-get install kibana
配置 Logstash 读取 Node.js 日志
编辑 /etc/logstash/conf.d/nodejs.conf,让 Logstash 从 /var/log/nodejs/*.log 读取内容,并推送到本机的 Elasticsearch:
input {
  file {
    path => "/var/log/nodejs/*.log"
    start_position => "beginning"
  }
}
output {
  elasticsearch {
    hosts => ["localhost:9200"]
    index => "nodejs-%{+YYYY.MM.dd}"
  }
}
启动服务
sudo systemctl start elasticsearch
sudo systemctl start logstash
sudo systemctl start kibana
配置完成后,日志就不再只是服务器上的文本文件,而是可以被搜索、聚合和筛选的数据源。对于排查 ERROR、定位某一时段的异常请求,效率会明显高很多。
再用 Prometheus 和 Grafana 看性能指标
日志擅长还原事件经过,但它不擅长持续观察趋势。比如错误率是不是正在升高、响应时间是否变慢、内存是不是逼近上限,这些问题更适合交给指标系统处理。
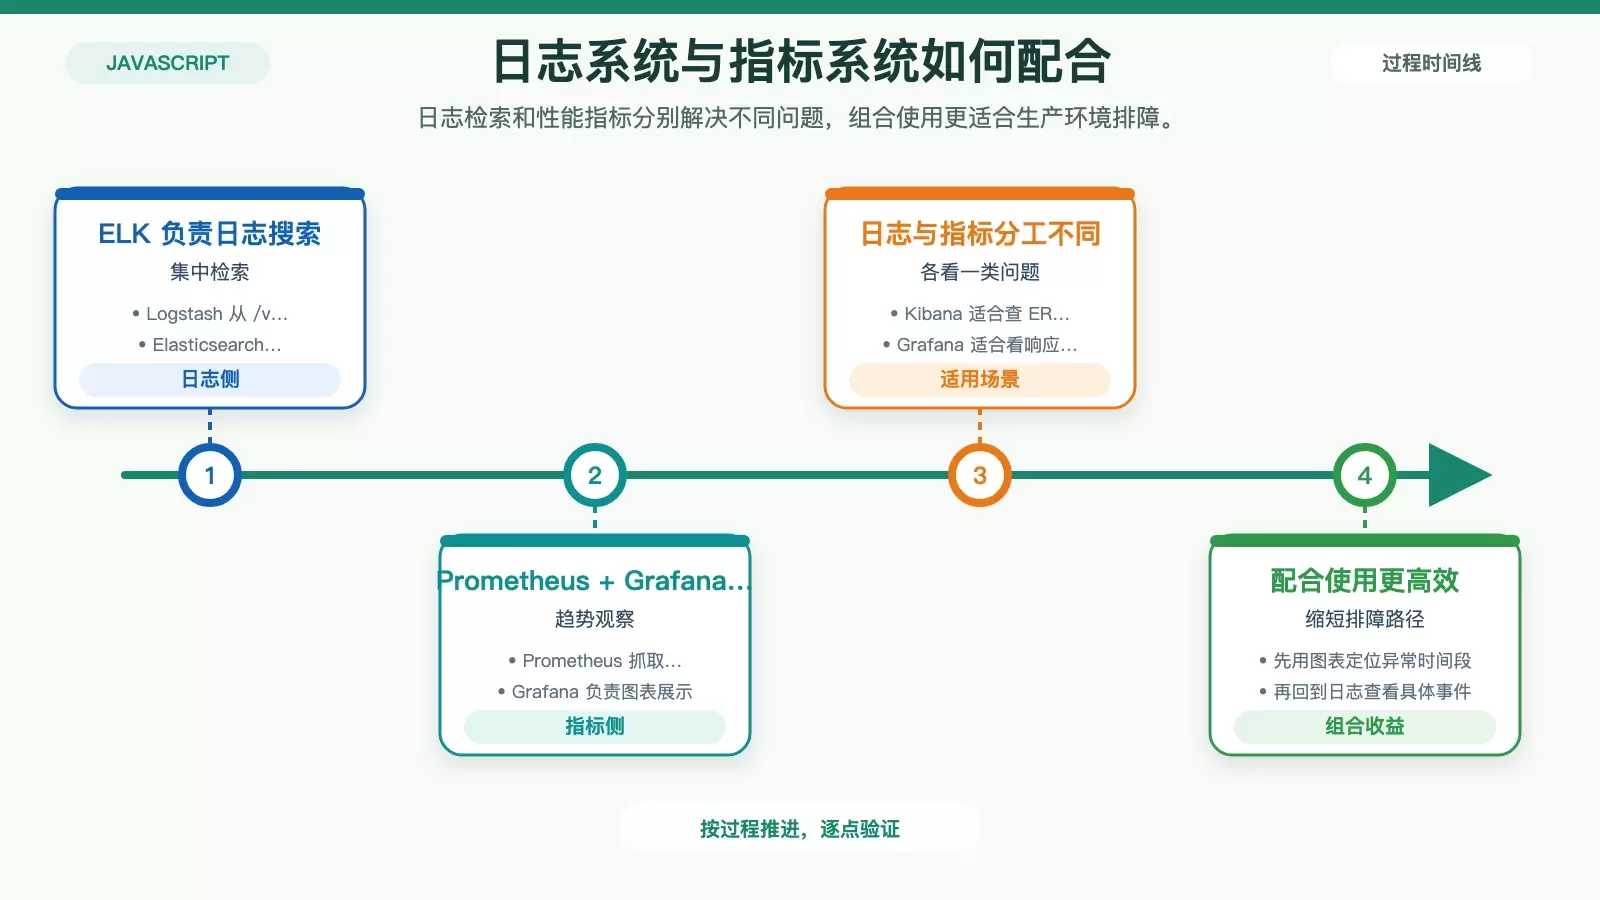
在 Ubuntu 的 Node.js 部署里,Prometheus + Grafana 是一组常见组合:
Prometheus负责抓取指标Grafana负责展示图表和面板
安装 Prometheus 和 Grafana
sudo apt-get install prometheus
sudo apt-get install grafana
配置 Prometheus 抓取 Node.js 应用
编辑 /etc/prometheus/prometheus.yml,加入 Node.js 应用的抓取目标:
scrape_configs:
  - job_name: 'nodejs'
    static_configs:
      - targets: ['localhost:9090']
启动服务
sudo systemctl start prometheus
sudo systemctl start grafana
把日志和指标结合起来后,定位问题的路径会更短:Grafana 先告诉你异常发生在什么时候,ELK 再帮你找到那段时间里具体发生了什么。
定期审查日志,别只在出故障时才看
很多团队把日志系统搭起来后,就默认任务已经完成,结果日志只是“被保存”了,并没有真正被使用。更现实的做法,是定期检查错误日志、慢查询记录和关键异常关键词。
如果已经接入 Kibana,日常审查并不复杂。直接搜索 ERROR 或 5xx,通常几秒钟就能把问题范围缩小到某个接口、某段时间或某类请求。
这一步的重点不在工具本身,而在频率。定期看日志,才能把很多隐患拦在用户投诉之前。
把关键异常做成自动告警
人工翻日志适合排查,不适合值班。想让日志系统真正参与运维,就需要把核心指标和异常模式转成自动告警规则。
可以利用 Kibana 的搜索和可视化能力,或者直接在 Grafana 中设置警报规则,围绕以下几类信号设定阈值:
- 错误率
- 响应时间
- 内存使用
一旦超过阈值,就通过邮件或 Slack 发送通知。这样做的关键收益,是把“事后翻查”变成“事中发现”,让团队在问题扩大前就开始处理。
从死日志到可观测部署
回头看这套流程,真正有效的不是某一个单点工具,而是各环节之间的配合:应用先写出可用日志,系统负责轮转保盘,ELK 负责集中检索,Prometheus 和 Grafana 负责趋势观察,最后再用定期审查和自动告警把运维动作闭环。
对 Ubuntu 上的 Node.js 部署来说,这些步骤并不算复杂,但能明显提升可维护性和稳定性。只要把日志从“留档”升级为“可分析、可检索、可告警”的体系,它就会从死数据变成真正的运维工具。















