


Python实现分布式锁:ZooKeeper与Redis方案对比及代码演示

本文通过Python代码演示了并发场景下不加锁导致的竞态条件问题,并分别介绍了基于ZooKeeper和Redis的分布式锁实现方案。重点解析了Kazoo库与RedLock算法的使用方法及原理,对比了两种方案在一致性、容错性及实现复杂度上的差异,帮助开发者理解分布式锁的核心机制与选型要点。
在计算机并发编程领域,锁机制是处理资源竞争的核心手段,常见的类型包括互斥锁、自旋锁等。
锁的概念通常与线程、进程紧密相关,阮一峰曾撰写文章对这些基础概念进行了通俗易懂的解读。
从我的理解来看,引入线程或进程旨在利用多核CPU或多台服务器提升系统并发性能;然而,由于调度策略的不确定性,这种并发操作容易引发混乱。因此,必须在共享资源或关键节点上加锁,以控制并发行为,确保数据一致性。
许多编程语言提供了线程级别的锁实现及相应工具,但在跨进程层面往往力不从心。当服务在生产环境中部署多个实例时,不同进程间需要同步访问共享资源,此时分布式锁作为分布式系统中对共享资源进行加锁的基础构件,便显得尤为重要。
接下来,我们将通过Python代码示例,展示如何在项目中实现一个简单的分布式互斥锁。
不使用分布式锁会引发什么问题?
首先,通过一个简单实例来演示在没有分布式锁保护的情况下,系统可能出现的混乱状况。
假设商城系统进行秒杀活动,Redis中存储着库存信息 count:1。当秒杀开始时,大量请求涌入,各应用程序查询Redis中的count值,若count大于0,则执行count-1操作,从而阻止其他请求继续秒杀。
# -*- coding: utf-8 -*-
import os
import arrow
import redis
from multiprocessing import Pool

HOT_KEY = 'count'
r = redis.Redis(host='localhost', port=6379)

def seckilling():
  name = os.getpid()
  v = r.get(HOT_KEY)
  if int(v) > 0:
    print name, ' decr redis.'
    r.decr(HOT_KEY)
  else:
    print name, ' can not set redis.', v

def run_without_lock(name):
  while True:
    if arrow.now().second % 5 == 0:
      seckilling()
      return

if __name__ == '__main__':
  p = Pool(16)
  r.set(HOT_KEY, 1)
  for i in range(16):
    p.apply_async(run_without_lock, args=(i, ))
  print 'now 16 processes are going to get lock!'
  p.close()
  p.join()
  print('All subprocesses done.')
上述代码使用多进程模拟高并发请求场景。程序启动时将count初始化为1,随后各进程进入等待状态。当时钟秒数为5时,所有进程同时尝试访问秒杀函数,我们观察其运行效果。
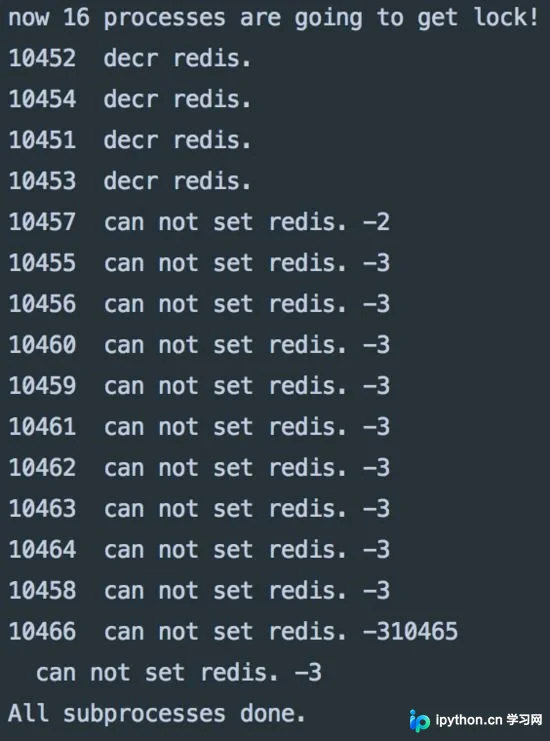
运行结果
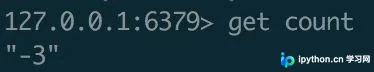
Redis查询展示
从程序打印日志及Redis查询结果来看,结果并不符合预期。原本仅剩一件商品,却成功被抢购了4次。这是因为各进程在获取count值后,执行更新指令(decr)存在时间差,导致其他进程在检查时仍认为库存充足,从而产生竞态条件。
此类问题属于数据并发问题中的“不可重复读”现象。
在缺乏保护机制的情况下,其他常见的并发问题如幻读、脏读、第一类及第二类丢失更新等也可能发生,此处不再逐一举例说明。
使用ZooKeeper实现分布式锁
作为专注于解决分布式协同问题的知名中间件,ZooKeeper利用其提供的API以及对节点唯一性和顺序一致性的保证,可以实现分布式锁。
其实现思路是:各进程尝试创建 /exclusive_lock/lock 类型的节点,ZooKeeper保证只有一个客户端能成功创建该节点,成功者即视为获得锁。当持有锁的业务处理完毕并删除该节点后,其他客户端会监听到该事件,并重新尝试创建节点,如此循环直至获取锁。
Kazoo库实现了这种Lock机制,使用非常简便,开发人员无需自行实现acquire、release等通用锁接口。
此外,在Python中,锁的使用通常可以通过优雅的上下文管理器with语句来实现。
def run_with_zk_lock(name):
  zk = KazooClient()
  zk.start()
  lock = zk.Lock("/lockpath", "my-identifier")
  while True:
    if arrow.now().second % 5 == 0:
      with lock:
        seckilling()
        return
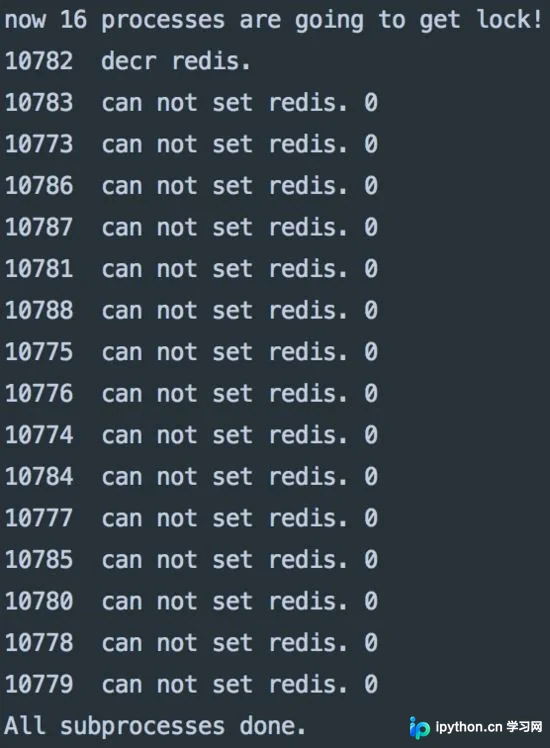
使用ZooKeeper的运行结果
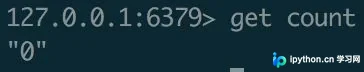
Redis查询展示
当秒杀请求发生时,只有成功获取锁的进程才能执行秒杀操作。
在锁的保护下,程序按照预期逻辑顺利运行。
使用Redis实现分布式锁
Redis官网有一篇文章专门介绍如何使用Redis作为分布式锁,文末还附有对该文章的质疑及作者的回应,内容颇具争议性。
该文章提及了一种名为redlock的分布式锁设计方案。
设置锁的Redis命令为 SET resource_name my_random_value NX PX 30000 ,当添加NX参数时,仅当resource_name不存在时才会创建;若已存在则返回失败。利用这一机制,确保只有一个client能set成功,这与上述ZooKeeper的逻辑类似。
然而,实现这样一个分布式锁远非如此简单。Redis并非像ZooKeeper那样的分布式协同工具,它不向客户端提供分布式环境中各种一致性、容错性及可用性的强保证。
Redis本身采用集群部署,节点间存在异步复制的时间差及容错问题。要在大规模分布式系统中真正落地该锁的实现,需考虑各种复杂情况,难度较大。
关于如何在编程语言层面实现锁接口、redlock的原理与代码实现,以及上述Kazoo包中Lock的源码解析,我将在另一篇专门的文章中详细探讨。
redlock-py 包是对上述文章所述原理的Python语言实现,我们现使用它进行尝试。
rlock = RedLock([{"host": "localhost", "port": 6379, "db": 0}, ])

def run_with_redis_lock(name):
  while True:
    if arrow.now().second % 5 == 0:
      with rlock:
        seckilling()
        return
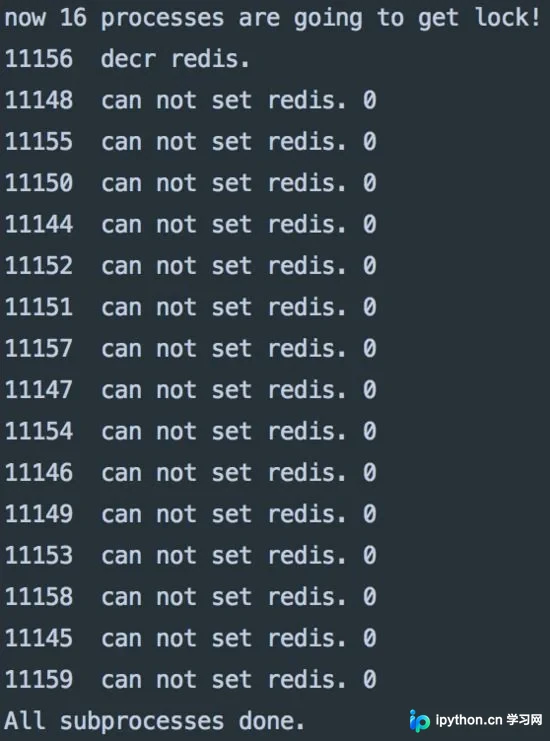
Redis锁运行结果
运行结果与前述使用ZooKeeper的情况一致,符合程序设计预期。
以上仅展示了基于Python语言的一些代码示例,通过引入两个第三方包,利用分布式锁避免了并发程序中可能出现的混乱。
但实际上,这里存在一个断层:这两个工具仅提供底层机制,并未直接对外暴露操作锁的API,如何利用这些机制构建完整的锁抽象,正是这两个第三方库所做的事情。
简要浏览它们实现的源码以及threading模块中部分lock代码后,发现锁实现在底层有共通之处:均包含通用的acquire与release方法,并将enter与exit方法指向这两个方法,从而实现上下文管理器with的用法。
此外,还可以利用关系型数据库(如MySQL)固有的锁机制作为分布式锁。但由于数据库往往是系统瓶颈,引入额外压力并不必要。同时,MySQL中的锁机制与隔离级别涉及众多细节,在GitHub上未找到成熟且对外暴露通用锁API的基于MySQL实现的第三方包,故未在文中展示。
要清晰阐述此事并非易事,后续我将尝试编写一个较为地道的锁实现,并深入研究上述两个第三方包的具体实现,力求填补这一断层。未来或许会尝试实现基于MySQL的类似第三方包,这需要更深入理解MySQL的相关机制。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















