


Python爬虫实战:利用代理IP抓取新浪微博移动端内容

本文详细介绍如何使用Python编写爬虫程序,通过配置代理IP抓取新浪微博移动端(m.weibo.cn)大V的微博内容。文章涵盖前期准备、抓包分析思路及完整可运行代码,演示如何获取containerid并解析微博文本、点赞、评论及转发数据,帮助开发者快速掌握基础爬虫技巧。
本文分享一个使用Python爬虫技术获取新浪微博内容的完整示例,供读者参考学习。
我们将使用Python编写爬虫程序,目标是抓取微博大V发布的微博内容。本文以特定大V为例,演示如何爬取新浪移动端网站(网址:https://m.weibo.cn/u/1259110474)的数据。
在进行网站数据爬取时,通常优先选择移动端站点(m站),其次是wap站,最后才考虑PC端站点。当然,这并非绝对规则;若PC端包含更完整的信息且为所需,则应首选PC站。由于多数m站域名以“m.”开头,本文选取的目标网址为 m.weibo.cn。
前期准备
1. 代理IP配置
网络上存在大量免费代理IP资源,例如西刺免费代理IP(http://www.xicidaili.com/)。用户可自行筛选一个可用的IP地址用于测试。
2. 抓包分析
通过抓包工具获取微博内容的请求地址,具体过程此处不再赘述,如有不清楚之处可自行查阅相关资料。以下直接提供完整的实现代码。
完整代码:
# -*- coding: utf-8 -*-
import urllib.request
import json
#定义要爬取的微博大V的微博ID
id='1259110474'
#设置代理IP
proxy_addr="122.241.72.191:808"
#定义页面打开函数
def use_proxy(url,proxy_addr):
  req=urllib.request.Request(url)
  req.add_header("User-Agent","Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/49.0.2623.221 Safari/537.36 SE 2.X MetaSr 1.0")
  proxy=urllib.request.ProxyHandler({'http':proxy_addr})
  opener=urllib.request.build_opener(proxy,urllib.request.HTTPHandler)
  urllib.request.install_opener(opener)
  data=urllib.request.urlopen(req).read().decode('utf-8','ignore')
  return data
#获取微博主页的containerid,爬取微博内容时需要此id
def get_containerid(url):
  data=use_proxy(url,proxy_addr)
  content=json.loads(data).get('data')
  for data in content.get('tabsInfo').get('tabs'):
    if(data.get('tab_type')=='weibo'):
      containerid=data.get('containerid')
  return containerid
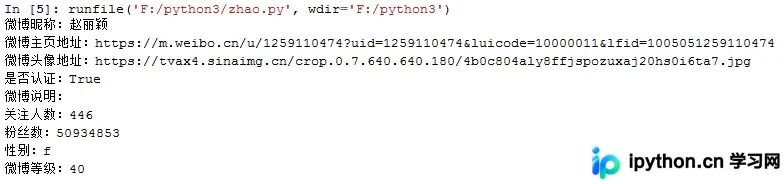
#获取微博大V账号的用户基本信息,如:微博昵称、微博地址、微博头像、关注人数、粉丝数、性别、等级等
def get_userInfo(id):
  url='https://m.weibo.cn/api/container/getIndex?type=uid&value='+id
  data=use_proxy(url,proxy_addr)
  content=json.loads(data).get('data')
  profile_image_url=content.get('userInfo').get('profile_image_url')
  description=content.get('userInfo').get('description')
  profile_url=content.get('userInfo').get('profile_url')
  verified=content.get('userInfo').get('verified')
  guanzhu=content.get('userInfo').get('follow_count')
  name=content.get('userInfo').get('screen_name')
  fensi=content.get('userInfo').get('followers_count')
  gender=content.get('userInfo').get('gender')
  urank=content.get('userInfo').get('urank')
  print("微博昵称:"+name+"\n"+"微博主页地址:"+profile_url+"\n"+"微博头像地址:"+profile_image_url+"\n"+"是否认证:"+str(verified)+"\n"+"微博说明:"+description+"\n"+"关注人数:"+str(guanzhu)+"\n"+"粉丝数:"+str(fensi)+"\n"+"性别:"+gender+"\n"+"微博等级:"+str(urank)+"\n")
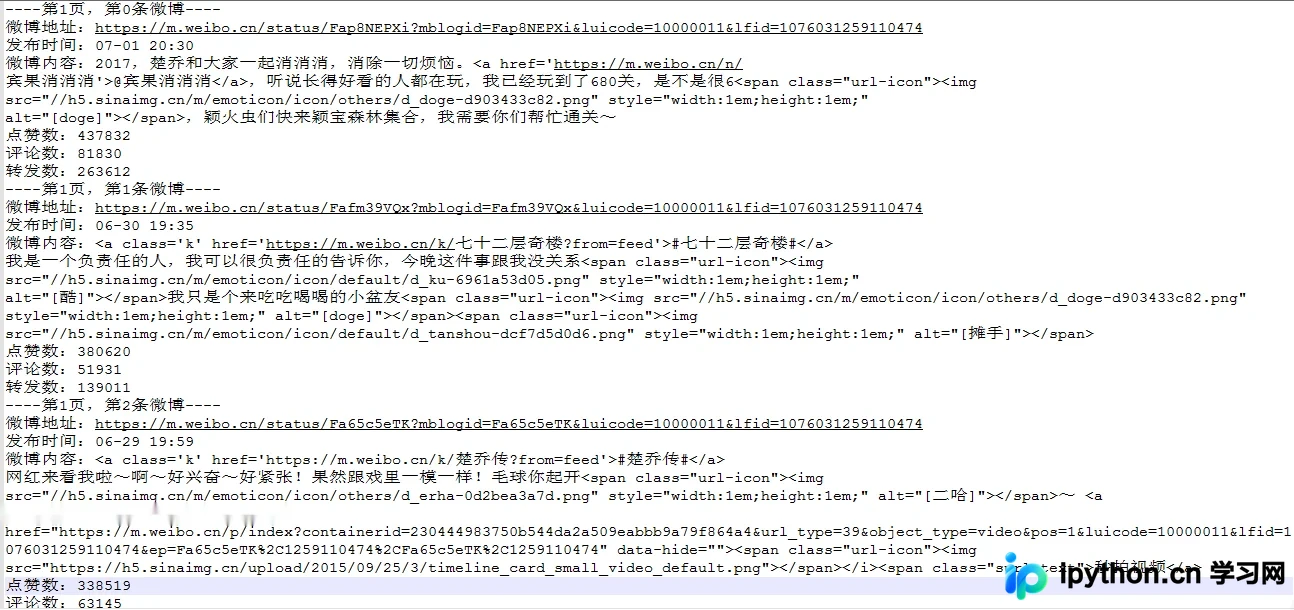
#获取微博内容信息,并保存到文本中,内容包括:每条微博的内容、微博详情页面地址、点赞数、评论数、转发数等
def get_weibo(id,file):
  i=1
  while True:
    url='https://m.weibo.cn/api/container/getIndex?type=uid&value='+id
    weibo_url='https://m.weibo.cn/api/container/getIndex?type=uid&value='+id+'&containerid='+get_containerid(url)+'&page='+str(i)
    try:
      data=use_proxy(weibo_url,proxy_addr)
      content=json.loads(data).get('data')
      cards=content.get('cards')
      if(len(cards)>0):
        for j in range(len(cards)):
          print("-----正在爬取第"+str(i)+"页,第"+str(j)+"条微博------")
          card_type=cards[j].get('card_type')
          if(card_type==9):
            mblog=cards[j].get('mblog')
            attitudes_count=mblog.get('attitudes_count')
            comments_count=mblog.get('comments_count')
            created_at=mblog.get('created_at')
            reposts_count=mblog.get('reposts_count')
            scheme=cards[j].get('scheme')
            text=mblog.get('text')
            with open(file,'a',encoding='utf-8') as fh:
              fh.write("----第"+str(i)+"页,第"+str(j)+"条微博----"+"\n")
              fh.write("微博地址:"+str(scheme)+"\n"+"发布时间:"+str(created_at)+"\n"+"微博内容:"+text+"\n"+"点赞数:"+str(attitudes_count)+"\n"+"评论数:"+str(comments_count)+"\n"+"转发数:"+str(reposts_count)+"\n")
        i+=1
      else:
        break
    except Exception as e:
      print(e)
      pass
if __name__=="__main__":
  file=id+".txt"
  get_userInfo(id)
  get_weibo(id,file)
爬取结果展示
如需了解更多Python相关知识,可参考本站系列教程:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望本文提供的代码和说明能对读者的Python编程实践有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















