


TensorFlow文本分类实战:从模型构建到训练详解

本文详细解析使用TensorFlow进行文本分类的完整流程。从数据预处理、One-Hot编码,到构建包含隐藏层的神经网络,深入讲解RELU与Softmax激活函数的选择依据及偏置项作用。通过具体代码示例,展示如何设置训练参数、计算交叉熵误差并使用Adam优化器进行梯度下降,最终实现高准确率的文本分类模型。
前言
近期Caffe2发布,支持移动端应用,这让人联想到物联网设备而非智能手机。想象一下在iPhone 7上运行CNN的场景,确实令人印象深刻。
作为初学者,我们暂且放下Caffe2,专注于TensorFlow的学习。尽管其上手难度高于Caffe,但TensorFlow具备以下显著特点:
- 基于Python开发,编写速度快且代码可读性强。
- 兼容CPU和GPU环境,在多GPU系统中运行更加流畅。
- 具备较高的代码编译效率。
- 拥有发展迅速且活跃的开发者社区。
- 能够生成网络拓扑结构和性能的可视化图表。
TensorFlow(简称TF)的运算流程如下:
TensorFlow的运行主要包含两个阶段:模型构建与模型训练。
在模型构建阶段,我们需要创建一个图(Graph)来描述模型结构。TensorFlow的强大之处在于支持TensorBoard可视化:
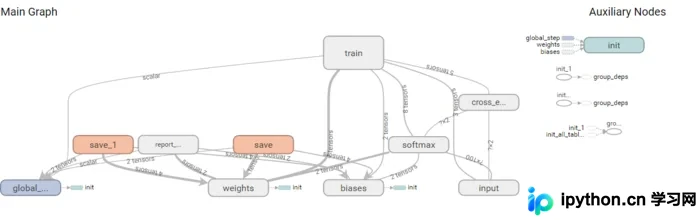
如图所示,这类似于流程图。此外,推荐尝试Google提供的TensorFlow Playground,体验十分有趣。
进入训练阶段,模型构建阶段并不执行实际计算,只有在调用tensoflow.Session.run()时才会开始进行数值计算。
文本分类
首先展示代码,随后逐一进行解释。
# -*- coding: utf-8 -*-

import pandas as pd
import numpy as np
import tensorflow as tf
from collections import Counter
from sklearn.datasets import fetch_20newsgroups

def get_word_2_index(vocab):
 word2index = {}
 for i,word in enumerate(vocab):
 word2index[word] = i
 return word2index


def get_batch(df,i,batch_size):
 batches = []
 results = []
 texts = df.data[i*batch_size : i*batch_size+batch_size]
 categories = df.target[i*batch_size : i*batch_size+batch_size]
 for text in texts:
 layer = np.zeros(total_words,dtype=float)
 for word in text.split(' '):
  layer[word2index[word.lower()]] += 1
 batches.append(layer)

 for category in categories:
 y = np.zeros((3),dtype=float)
 if category == 0:
  y[0] = 1.
 elif category == 1:
  y[1] = 1.
 else:
  y[2] = 1.
 results.append(y)
 return np.array(batches),np.array(results)

def multilayer_perceptron(input_tensor, weights, biases):
 #hidden层RELU函数激励
 layer_1_multiplication = tf.matmul(input_tensor, weights['h1'])
 layer_1_addition = tf.add(layer_1_multiplication, biases['b1'])
 layer_1 = tf.nn.relu(layer_1_addition)

 layer_2_multiplication = tf.matmul(layer_1, weights['h2'])
 layer_2_addition = tf.add(layer_2_multiplication, biases['b2'])
 layer_2 = tf.nn.relu(layer_2_addition)

 # Output layer
 out_layer_multiplication = tf.matmul(layer_2, weights['out'])
 out_layer_addition = out_layer_multiplication + biases['out']
 return out_layer_addition

#main
#从sklearn.datas获取数据
cate = ["comp.graphics","sci.space","rec.sport.baseball"]
newsgroups_train = fetch_20newsgroups(subset='train', categories=cate)
newsgroups_test = fetch_20newsgroups(subset='test', categories=cate)

# 计算训练和测试数据总数
vocab = Counter()
for text in newsgroups_train.data:
 for word in text.split(' '):
 vocab[word.lower()]+=1

for text in newsgroups_test.data:
 for word in text.split(' '):
 vocab[word.lower()]+=1

total_words = len(vocab)
word2index = get_word_2_index(vocab)

n_hidden_1 = 100 # 一层hidden层神经元个数
n_hidden_2 = 100 # 二层hidden层神经元个数
n_input = total_words
n_classes = 3  # graphics, sci.space and baseball 3层输出层即将文本分为三类
#占位
input_tensor = tf.placeholder(tf.float32,[None, n_input],name="input")
output_tensor = tf.placeholder(tf.float32,[None, n_classes],name="output")
#正态分布存储权值和偏差值
weights = {
 'h1': tf.Variable(tf.random_normal([n_input, n_hidden_1])),
 'h2': tf.Variable(tf.random_normal([n_hidden_1, n_hidden_2])),
 'out': tf.Variable(tf.random_normal([n_hidden_2, n_classes]))
}
biases = {
 'b1': tf.Variable(tf.random_normal([n_hidden_1])),
 'b2': tf.Variable(tf.random_normal([n_hidden_2])),
 'out': tf.Variable(tf.random_normal([n_classes]))
}

#初始化
prediction = multilayer_perceptron(input_tensor, weights, biases)

# 定义 loss and optimizer 采用softmax函数
# reduce_mean计算平均误差
loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(logits=prediction, labels=output_tensor))
optimizer = tf.train.AdamOptimizer(learning_rate=learning_rate).minimize(loss)

#初始化所有变量
init = tf.global_variables_initializer()

#部署 graph
with tf.Session() as sess:
 sess.run(init)
 training_epochs = 100
 display_step = 5
 batch_size = 1000
 # Training
 for epoch in range(training_epochs):
 avg_cost = 0.
 total_batch = int(len(newsgroups_train.data) / batch_size)
 for i in range(total_batch):
  batch_x,batch_y = get_batch(newsgroups_train,i,batch_size)
  c,_ = sess.run([loss,optimizer], feed_dict={input_tensor: batch_x,output_tensor:batch_y})
  # 计算平均损失
  avg_cost += c / total_batch
 # 每5次epoch展示一次loss
 if epoch % display_step == 0:
  print("Epoch:", '%d' % (epoch+1), "loss=", "{:.6f}".format(avg_cost))
 print("Finished!")

 # Test model
 correct_prediction = tf.equal(tf.argmax(prediction, 1), tf.argmax(output_tensor, 1))
 # 计算准确率
 accuracy = tf.reduce_mean(tf.cast(correct_prediction, "float"))
 total_test_data = len(newsgroups_test.target)
 batch_x_test,batch_y_test = get_batch(newsgroups_test,0,total_test_data)
 print("Accuracy:", accuracy.eval({input_tensor: batch_x_test, output_tensor: batch_y_test}))
代码解析
本示例未涉及模型保存操作。按照代码执行顺序,我将解释各个函数及参数选择。该代码源自GitHub项目,旨在供学习参考。
数据获取方面,我们从sklearn.datasets加载数据,这里包含20类新闻文本,我们将基于每个单词进行后续分类处理:
# 计算训练和测试数据总数
vocab = Counter()
for text in newsgroups_train.data:
 for word in text.split(' '):
 vocab[word.lower()]+=1

for text in newsgroups_test.data:
 for word in text.split(' '):
 vocab[word.lower()]+=1

total_words = len(vocab)
word2index = get_word_2_index(vocab)
根据每个索引转换为One-Hot编码。One-Hot编码,又称一位有效编码,主要采用N位状态寄存器对N个状态进行编码,每个状态由独立的寄存器位表示,且任意时刻仅有一位有效。
def get_batch(df,i,batch_size):
 batches = []
 results = []
 texts = df.data[i*batch_size : i*batch_size+batch_size]
 categories = df.target[i*batch_size : i*batch_size+batch_size]
 for text in texts:
 layer = np.zeros(total_words,dtype=float)
 for word in text.split(' '):
  layer[word2index[word.lower()]] += 1
 batches.append(layer)

 for category in categories:
 y = np.zeros((3),dtype=float)
 if category == 0:
  y[0] = 1.
 elif category == 1:
  y[1] = 1.
 else:
  y[2] = 1.
 results.append(y)
 return np.array(batches),np.array(results)
在此段代码中,根据自定义的数据范围确定每次训练的样本数量,即批处理大小。在测试模型时,我们将使用更大的批处理来提供字典数据,因此需要定义一个可变批处理维度。
构建神经网络
神经网络是一种计算模型,描述使用机器语言和数学概念的系统方式。这些系统通过自主学习与训练运作,而非明确编程。下图展示了传统的三层神经网络结构:
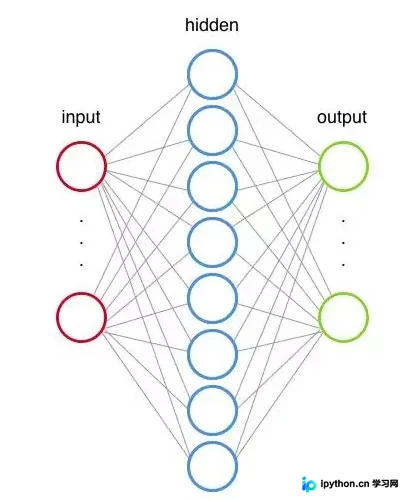
在本例的神经网络中,隐藏层(hidden layer)扩展至两层。这两层执行相同的操作,只是hidden1层的输出作为hidden2层的输入。
weights = {
 'h1': tf.Variable(tf.random_normal([n_input, n_hidden_1])),
 'h2': tf.Variable(tf.random_normal([n_hidden_1, n_hidden_2])),
 'out': tf.Variable(tf.random_normal([n_hidden_2, n_classes]))
}
biases = {
 'b1': tf.Variable(tf.random_normal([n_hidden_1])),
 'b2': tf.Variable(tf.random_normal([n_hidden_2])),
 'out': tf.Variable(tf.random_normal([n_classes]))
}
在输入层,需要定义第一个隐藏层的节点数量。这些节点也被称为特征或神经元,在上例中,每个圆圈代表一个节点。
输入层的每个节点对应数据集中的一个词(后续将展示其运行机制)。
每个节点(神经元)与权重相乘。每个节点拥有特定的权重值,在训练阶段,神经网络会调整这些值以生成正确的输出。
将输入乘以权重,并将结果与偏置项相加,类似于线性回归公式 y = Wx + b。这些数据随后通过激活函数传递,该函数定义了每个节点的最终输出。常见的激活函数包括:
- Rectified Linear Unit (RELU) - 用于隐藏层神经元输出
- Sigmoid - 用于隐藏层神经元输出
- Softmax - 用于多分类神经网络输出
- Linear - 用于回归神经网络输出(或二分类问题)
本例的隐藏层使用RELU,而传统方法多采用Sigmoid系列激活函数。
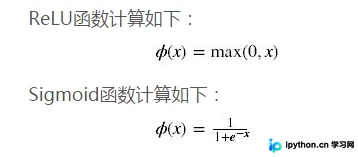
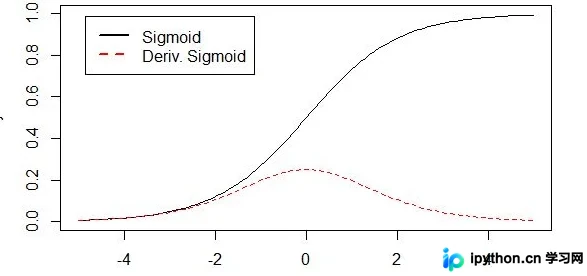
由图可知,Sigmoid函数的导数从0开始迅速趋近于0,易导致“梯度消失”现象,而RELU的导数不存在此问题。与Sigmoid类函数相比,RELU的主要变化在于:1)单侧抑制;2)相对宽阔的兴奋边界;3)稀疏激活性。这与人类神经皮层的工作原理更为接近。
为何需要引入偏移常量(偏置项)?
以Sigmoid函数为例进行说明。
权重w使得Sigmoid函数可以调整其倾斜程度,下图展示了权重变化时Sigmoid函数图形的变化情况:
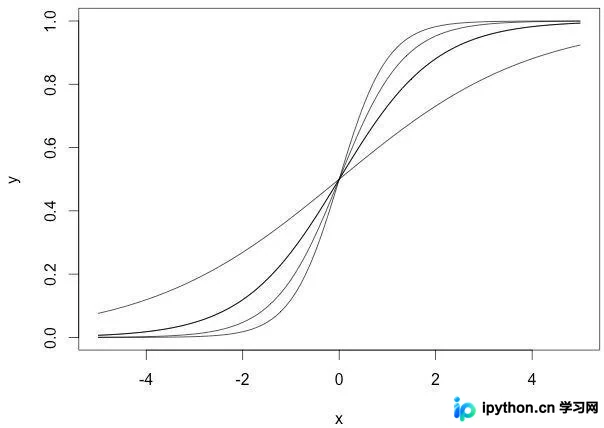
可以看出,无论W如何变化,函数始终经过点(0, 0.5)。但在实际应用中,我们可能需要在x接近0时,函数输出其他值。
当我们同时改变权重w和偏移量b时,可以为单个神经元构造多种输出可能性。在神经网络中,成千上万个神经元的结合能够产生复杂的输出模式。
输出层的值同样需要乘以权重,并加上偏置项,但此时使用的激活函数不同。
若希望用分类标签标记每段文本,且这些分类相互独立(即一段文本不能同时属于多个分类)。
基于此考虑,我们将使用Softmax函数而非RELU激活函数。该函数将每个完整的输出转换为0到1之间的值,并确保所有单元的输出之和等于1。
在此神经网络中,输出层明显包含3个神经元,对应三种文本分类任务。
#初始化所有变量
init = tf.global_variables_initializer()

#部署 graph
with tf.Session() as sess:
 sess.run(init)
 training_epochs = 100
 display_step = 5
 batch_size = 1000
 # Training
 for epoch in range(training_epochs):
 avg_cost = 0.
 total_batch = int(len(newsgroups_train.data) / batch_size)
 for i in range(total_batch):
  batch_x,batch_y = get_batch(newsgroups_train,i,batch_size)
  c,_ = sess.run([loss,optimizer], feed_dict={input_tensor: batch_x,output_tensor:batch_y})
  # 计算平均损失
  avg_cost += c / total_batch
 # 每5次epoch展示一次loss
 if epoch % display_step == 0:
  print("Epoch:", '%d' % (epoch+1), "loss=", "{:.6f}".format(avg_cost))
 print("Finished!")
以下是参数设置:
- training_epochs = 100 # 进行100次递归训练
- display_step = 5 # 每5次打印一次当前的loss值
- batch_size = 1000 # 训练数据的分割大小
为了判断网络是否正在学习,需要比较输出值(Z)与期望值(expected)。如何计算这种差异(损耗)呢?有多种解决方法。
由于我们正在进行分类任务,衡量损耗的最佳方式是交叉熵误差。
通过TensorFlow,我们将使用 tf.nn.softmax_cross_entropy_with_logits() 方法计算交叉熵误差(适用于softmax激活函数),并计算平均误差(tf.reduced_mean())。
通过寻找权重和误差的最佳值,以最小化输出误差(实际得到值与正确值之间的差异)。为此,需使用梯度下降法,具体而言,是使用随机梯度下降。
对应代码实现如下:
loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(logits=prediction, labels=output_tensor))
optimizer = tf.train.AdamOptimizer(learning_rate=learning_rate).minimize(loss)
TensorFlow已将复杂的算法封装为函数,我们只需选择合适的函数即可。
tf.train.AdamOptimizer(learning_rate).minimize(loss) 方法是一种语法糖,它执行两项操作:
compute_gradients(loss, <变量列表>) 计算梯度 apply_gradients(<变量列表>) 应用梯度
该方法使用新值更新所有tf.Variables,因此无需传递变量列表。
运行计算过程
Epoch: 0001 loss= 1133.908114347 Epoch: 0006 loss= 329.093700409 Epoch: 00011 loss= 111.876660109 Epoch: 00016 loss= 72.552971845 Epoch: 00021 loss= 16.673050320 ........ Finished! Accuracy: 0.81
Accuracy: 0.81 表示置信度为81%。通过调整参数和增加数据量(本文未涉及),置信度会发生变化。
结束
至此完成!使用神经网络创建了一个模型,将文本分类到不同类别中。采用GPU或分布式TF可以提升训练速度和效率。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或工作具有一定的参考学习价值。如果有疑问,欢迎留言交流,感谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















