


Python梯度下降法入门:单变量线性回归实战示例

本文通过Python代码演示梯度下降法在单变量线性回归中的应用。文章解释了损失函数的定义、对参数求导的过程以及迭代更新公式,并结合具体样本数据展示如何求解最优斜率k。适合希望直观理解梯度下降原理的初学者参考。
此处不展开讲解梯度下降法的数学原理与公式推导,仅提供一个直观且易于理解的简单示例。
首先考虑最简单的情况,样本仅包含一个变量,即简单的(x, y)对。若涉及多变量,例如通过体重或身高判断性别(注:此仅为假设,实际并不严谨),则变量包含两个属性:体重和身高,可表示为(x1, x2, y),即一个目标值对应两个输入属性。
在单变量情况下,最简单的模型是函数hk(x) = k*x所代表的直线(注意:这里的k也是变化的,我们的目标就是求出最优的k)。在深度学习中,我们通常不知道具体的函数形式,也就是不知道上述的k值。以下讨论仅针对单变量情况:
在未知k的情况下,我们通过样本点(x1, y1)、(x2, y2)……(xn, yn)来估计k。评估估计出的k的好坏,需要借助损失函数。
损失函数用于衡量预测值与真实值之间的差异大小。例如,对于样本(1, 1),其真实值为1,若预测值为0.5,则差异较大;若预测值为0.9999,则差异较小。
单变量情况下的损失函数定义如下:
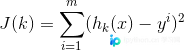
我们的目标是求出使损失函数最小的变量k(需注意与变量x区分)。为此,需对损失函数关于k求导(在多变量情况下为求偏导得到梯度,此处单变量求导,严格来说不称为梯度)。求偏导结果如下:

随后进行迭代更新,迭代过程中涉及一个步长alpha(在深度学习中通常称为学习率)。
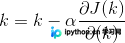
3. 具体示例
假设我们获得的样本为(1, 1)、(2, 2)、(3, 3)。由这三个样本可知,真实函数应为y = 1*x,此时损失函数值为0。但机器无法直接得知这一点,因此需要通过训练过程来学习。
以下是一段Python实现代码。
import numpy as np
import matplotlib.pyplot as plt
x=np.arange(-5, 5, 0.001)
y=(((x-1)*(x-1)+(x*2-2)*(x*2-2)+(x*3-3)*(x*3-3))*1/6.0)
plt.plot(x,y)
#plt.show() #显示图形


def sum(x):
 return ((x*1-1)*1+(x*2-2)*2+(x*3-3)*3)
def fun(x):
 return ((1/3.0)*sum(x))
old = 0
new = 5
step = 0.01
pre = 0.00000001

def src_fun(x):
 print(((x-1)*(x-1)+(x*2-2)*(x*2-2)+(x*3-3)*(x*3-3))*1/6.0)

while abs(new-old)>pre:
 old = new
 #src_fun(old)  #输出每次迭代的损失值
 new = new - step*fun(old)


print(new)
print(src_fun(new))
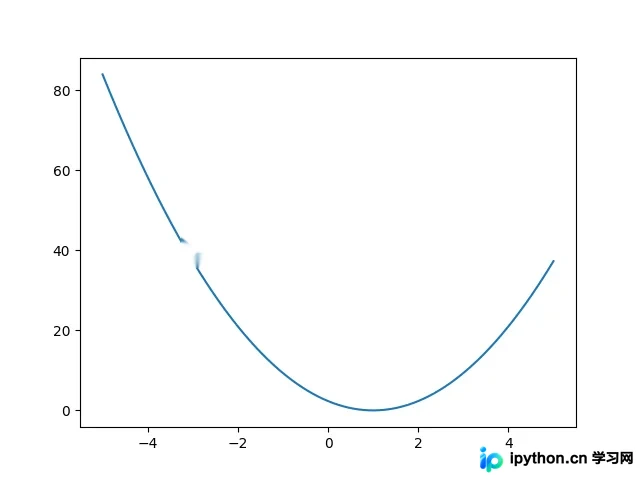
下图展示了损失函数的图像,其中变量为k。横坐标表示k的不同取值,纵坐标表示对应的损失大小。从图中可以大致看出,当k为1时,损失函数值为0。需要注意的是,这里得到的最优值k=1是基于已有样本得出的,如果样本不同,k值也会相应变化。
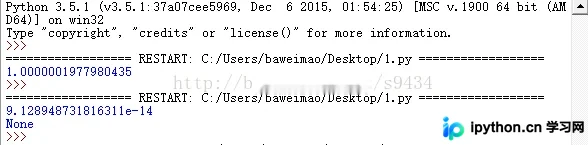
以下是print(new)和print(src_fun(new))的输出结果。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















