


Python利用requests与BeautifulSoup实现网页数据抓取

发布时间:2026-10-13 |
4人浏览过
本文详细介绍如何使用Python的requests库发送HTTP请求获取网页内容,并结合BeautifulSoup库解析HTML结构。通过百度首页及51job招聘网站两个具体案例,演示了处理编码问题、设置请求头防反爬以及提取特定文本信息的完整流程,帮助开发者掌握基础的网络数据采集技能。
Python网页抓取基础:requests与BeautifulSoup
requests库是一款轻量级且易于使用的第三方Python库,专门用于处理各类HTTP网络请求。
在获取网页内容时,get()方法是最常用的手段,其基础调用方式如下所示。
获取HTML页面并将其转换为字符串后,通常需要对页面结构进行解析。此时,我们常借助beautifulsoup4库来解析和处理HTML及XML文档。
以下代码展示了如何爬取百度首页信息并简单输出其界面内容。
import requests
from bs4 import BeautifulSoup
r=requests.get('http://www.baidu.com')
r.encoding=None
result=r.text
bs=BeautifulSoup(result,'html.parser')
print(bs.title)
print(bs.title.text)
实战案例:51job薪资数据抓取与编码处理
import requests
from bs4 import BeautifulSoup
#用来解决乱码现象,所以编写爬取信息的代码最好带上(输出出现乱码或者UnicodeEncodeError:'gbk'codec can't encode character)
import io
import sys
sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='gb18030')
#用来防止反爬取,可以了解一下
headers={"User-Agent" : "Mozilla/5.0 (Windows; U; Windows NT 5.1; zh-CN; rv:1.9.1.6)",
"Accept" : "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
"Accept-Language" : "en-us",
"Connection" : "keep-alive",
"Accept-Charset" : "GB2312,utf-8;q=0.7,*;q=0.7"
}
#获取51job网站的基本信息
r=requests.get('https://search.51job.com/list/000000,000000,0000,00,9,99,python,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare=')
r.encoding=r.apparent_encoding
result=r.text
bs=BeautifulSoup(result,'html.parser')
print(bs.prettify())
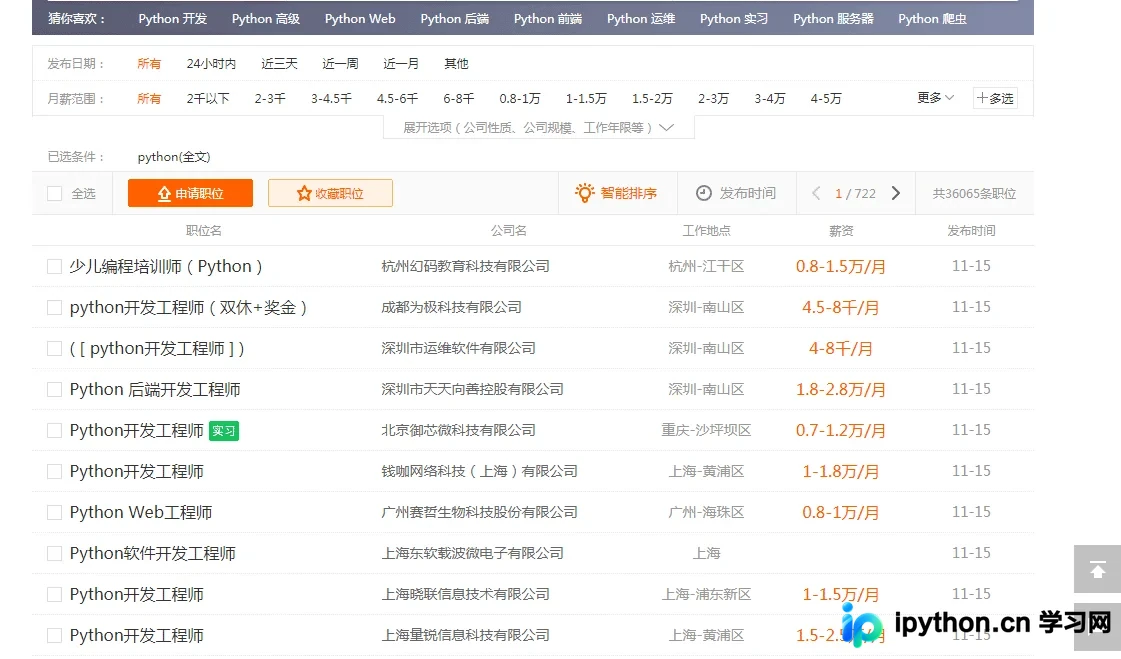
u1=bs.find_all('u1',attrs={'class':'item_con_list'}) #这部分代码便是我们爬取的目标,51job网站上关于python职业的薪资
print(len(u1))
li=bs.find_all('span',attrs={'class':'t4'})
for l in li:
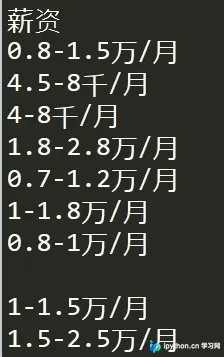
print(l.text)上述代码演示了如何从51job网站抓取与Python相关职位的薪资数据。
以上就是本文的全部内容,希望对读者的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















