



做高并发下载服务或大文件同步时,很多人会先去加 Goroutine、调大 Buffer,结果 CPU 还是很高,吞吐也上不去。真正拖后腿的,往往不是 Go 的并发模型,而是传统文件传输路径里频繁发生的内核态/用户态切换和多次内存复制。本文就从这条数据路径入手,说明 io.Copy 为什么有机会自动走到 Linux sendfile,以及在 HTTP 与 TLS 场景下该怎样判断零拷贝到底有没有保住。
传统读写为什么会把 CPU 拖高
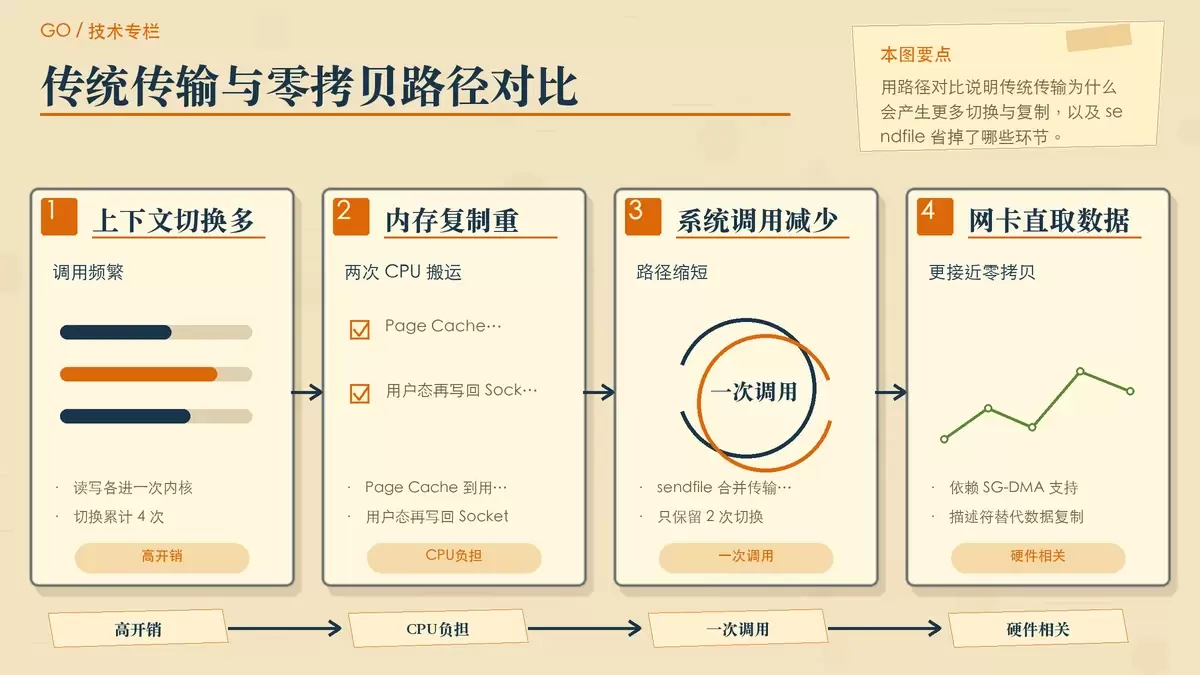
如果文件传输是靠普通的 Read + Write 完成,数据从磁盘到网络 Socket 需要经过一条比较“绕”的路径。
先看读文件阶段。调用 os.File.Read() 后,进程会发起系统调用,从用户态切到内核态。此时操作系统借助 DMA(Direct Memory Access)把磁盘数据读入内核空间的 Page Cache。随后,CPU 再把这些数据从内核 Page Cache 拷贝到用户态应用自己的 Buffer 中,最后进程返回用户态。
写网络阶段同样要再走一遍系统调用流程。调用 net.Conn.Write() 时,进程再次从用户态进入内核态,CPU 把用户态 Buffer 中的数据复制到内核的 Socket 发送缓冲区,然后由 DMA 把数据送到网卡,最后回到用户态。
这样传一次数据块,整体会产生 4 次用户态与内核态之间的上下文切换,以及 4 次复制动作,其中包括 2 次 DMA 传输和 2 次 CPU 主导的内存复制。
问题就出在这里。上下文切换会带来寄存器保存恢复、TLB 缓存失效等额外成本,而 CPU 主动做内存搬运会持续吃掉总线带宽。面对 GB 级文件下载,这种开销很容易把 CPU 顶满,但网络吞吐却未必能同步拉高。
sendfile 到底省掉了什么
Linux 为这类问题提供了一个很直接的系统调用:sendfile。它的目标很明确,就是让数据尽量停留在内核空间内部流转,避免先拷到用户态再写回内核。
// sendfile 系统调用原形
ssize_t sendfile(int out_fd, int in_fd, off_t *offset, size_t count);
这里的思路是:应用程序直接把输入文件描述符 in_fd 的内容发送到输出 Socket 描述符 out_fd,而不是自己读出字节后再手动写回去。
在这种模式下,调用一次 sendfile 只需要 1 次系统调用,也就是 2 次上下文切换。磁盘数据仍然会先进入内核 Page Cache,但后续如果硬件支持网卡的 SG-DMA(Scatter-Gather DMA),内核甚至不需要把数据再复制到 Socket 缓冲区。
更进一步说,内核只需要把内存地址和长度这类描述信息附加到 Socket 缓冲区,网卡 DMA 就可以直接按描述符从 Page Cache 取数并发送出去。这样省掉的不是磁盘 I/O 本身,而是 CPU 参与的那部分内存搬运。
因此,零拷贝真正改善的是两件事:一是减少上下文切换,二是尽量消除 CPU 在不同内存区域之间来回复制数据的成本。这也是它在大文件下载、高吞吐分发场景中效果最明显的原因。
Go 里的 io.Copy 为什么能自动走零拷贝
在 Go 里,很多场景其实不需要你手写 syscall.Sendfile。标准库已经把这层优化藏进了通用接口中,最典型的入口就是 io.Copy(dst, src)。
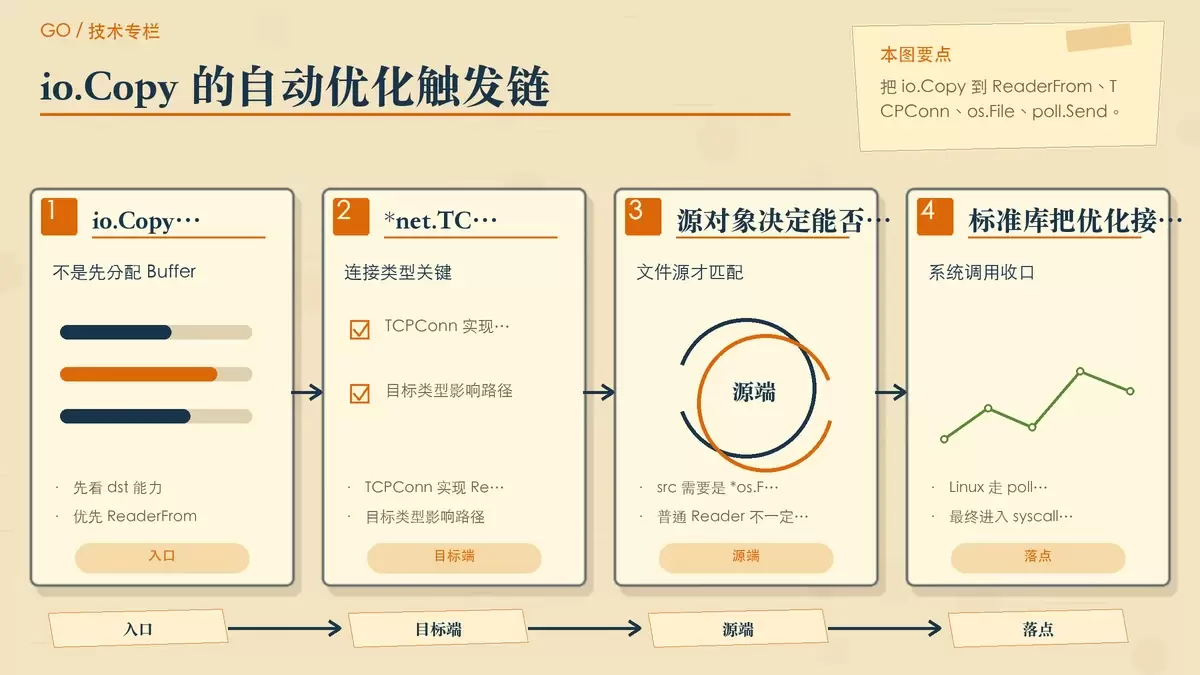
io.Copy 不会一上来就进入普通的读写循环,它会先检查目标端 dst 有没有实现 io.ReaderFrom 接口:
// io.Copy 底层优先尝试 ReaderFrom 优化
if r, ok := dst.(ReaderFrom); ok {
    return r.ReadFrom(src)
}
这个判断很关键。因为 Go 的 *net.TCPConn 正好实现了 ReadFrom(r io.Reader)。当目标端是 TCP 连接时,标准库会继续判断源端 src 是否为 *os.File。
如果这两个条件同时满足,Go 就不会再走“申请一个 []byte Buffer,然后循环读写”的常规路径,而是会在 Linux 上进一步调用内部的 poll.SendFile,最终落到 syscall.Sendfile。
典型写法如下:
func sendFileZeroCopy(tcpConn *net.TCPConn, file *os.File) (int64, error) {
    // 当 dst 为 *net.TCPConn 且 src 为 *os.File 时
    // io.Copy 会自动发起 Linux syscall.Sendfile 零拷贝
    return io.Copy(tcpConn, file)
}
这段代码表面上只是一次普通的 io.Copy,但只要类型条件满足,传输过程就会由内核接管。应用层不需要自己分配用户态 Buffer,Goroutine 主要是在等待系统调用完成,内存占用和 CPU 拷贝负担都会明显更低。
这也是 Go 做高性能 I/O 时一个很值得注意的点:看起来抽象层更高,未必性能更差。很多时候,标准库接口反而比手写循环更容易吃到底层优化。
HTTP 下载场景里,零拷贝什么时候会失效
如果你做的是 Web 服务,而不是直接操作 *net.TCPConn,零拷贝同样有机会自动生效。Go 的 net/http 已经把这层能力接进了静态文件响应流程里。
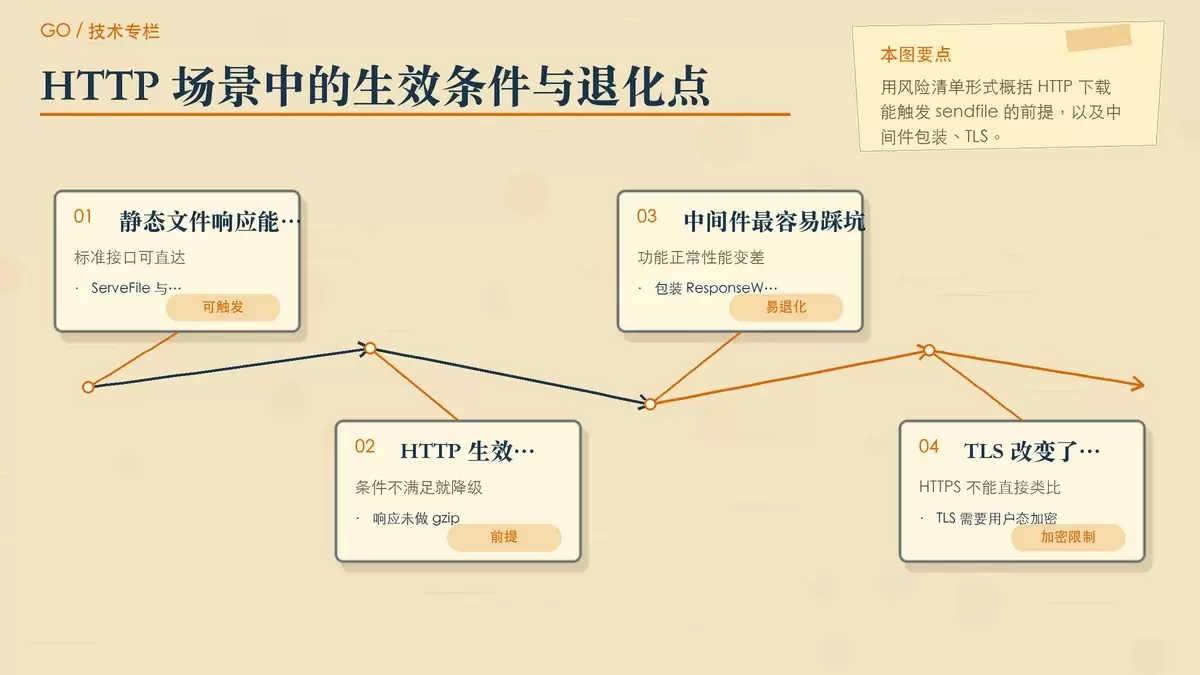
例如调用 http.ServeFile 或 http.ServeContent 时,底层的 http.response 实现了 ReadFrom。在响应体没有经过 gzip 压缩、底层连接仍是标准 TCP 的前提下,数据传输通常也会自动走到 sendfile。
func downloadHandler(w http.ResponseWriter, r *http.Request) {
    file, err := os.Open("large_file.zip")
    if err != nil {
        http.Error(w, "File not found", http.StatusNotFound)
        return
    }
    defer file.Close()
    // ServeContent 内部自动利用 io.Copy 与 Sendfile
    http.ServeContent(w, r, "large_file.zip", time.Now(), file)
}
不过工程里最容易踩坑的,也恰恰是在这一层。
中间件包装可能让 ReadFrom 优化直接失效
很多项目会在 http.ResponseWriter 外层再包一层自定义结构体,用来统计响应字节数、统一改写 Header,或者植入日志和监控逻辑。问题在于,一旦包装后的类型没有继续透传 ReadFrom 能力,底层接口断言就会失败。
一旦断言失败,请求虽然还能正常返回,但传输路径会退回普通读写模式,也就是重新回到那条 4 次切换、4 次复制的老路上。功能没坏,性能却悄悄掉了,这类问题在线上很难第一时间察觉。
HTTPS/TLS 仍然是常见的分界线
另一个常见限制来自 HTTPS。标准 TLS 需要在应用层对明文数据做对称加密,这意味着数据通常要先进入用户态内存,完成加密后才能继续发送。
在没有启用 Linux 内核级 KTLS 的情况下,sendfile 无法直接覆盖这段加密流程,零拷贝自然也就不能按同样方式生效。换句话说,HTTP 明文下载和 HTTPS 加密下载,底层数据路径并不一样,性能预期也不该混为一谈。
实际开发中该怎么用,才更容易吃到这类优化
从工程角度看,零拷贝不是让代码变“神奇”的技巧,而是一条需要满足条件的执行路径。要让 Go 更稳定地走到这条路径,核心原则其实很简单。
第一,优先使用标准库已经打通的流式接口,比如 io.Copy、http.ServeFile、http.ServeContent。这些接口抽象层高,但并不意味着一定多绕一层,反而常常内置了平台相关的最优分支。
第二,尽量少写固定 Buffer 的手动循环,除非你确实有内容改写、分块校验、限速整形等明确需求。否则,自己控制每次 Read/Write 的方式,很容易把标准库原本可以自动触发的优化提前截断。
第三,设计 HTTP 中间件时,不只要关注功能正确性,也要关注底层接口是否被完整透传。一个看似无害的包装层,就可能让 ReadFrom 消失,最终把文件下载性能拉回普通模式。
第四,评估 HTTPS 传输性能时要把 TLS 加密成本单独考虑进去。不能因为本地测试里 io.Copy 对明文 TCP 很快,就默认线上 HTTPS 下载也能拿到同样收益。
归根结底,Go 在大文件传输上的优势,不只是“能开很多 Goroutine”,更在于标准库已经和操作系统能力做了足够深的衔接。理解这条链路之后,遇到 CPU 高、吞吐低的问题,排查方向就不会只停留在协程数和 Buffer 大小上,而会更快落到真正影响性能的传输路径本身。















