



调用第三方 HTTP 接口时,日志里常见的只有一个总耗时,比如 2.1s。但排查性能问题时,真正有价值的并不是“慢了”,而是“慢在什么阶段”:是 DNS 抖动、TCP 往返变长、TLS 握手偏慢,还是对方服务端本身处理时间过高。Go 标准库里的 net/http/httptrace 正适合做这件事,本文按请求生命周期拆开关键 Hook,并给出一套可直接接入业务日志的轻量实现,帮助你快速判断问题归因。
为什么总耗时不够用
当下游接口出现 P99 延时升高时,很多服务只能从 http.Client 拿到一次请求的总耗时,例如 52ms、800ms 或 2.1s。这个数字能证明请求慢了,却没法说明瓶颈落在哪一段。
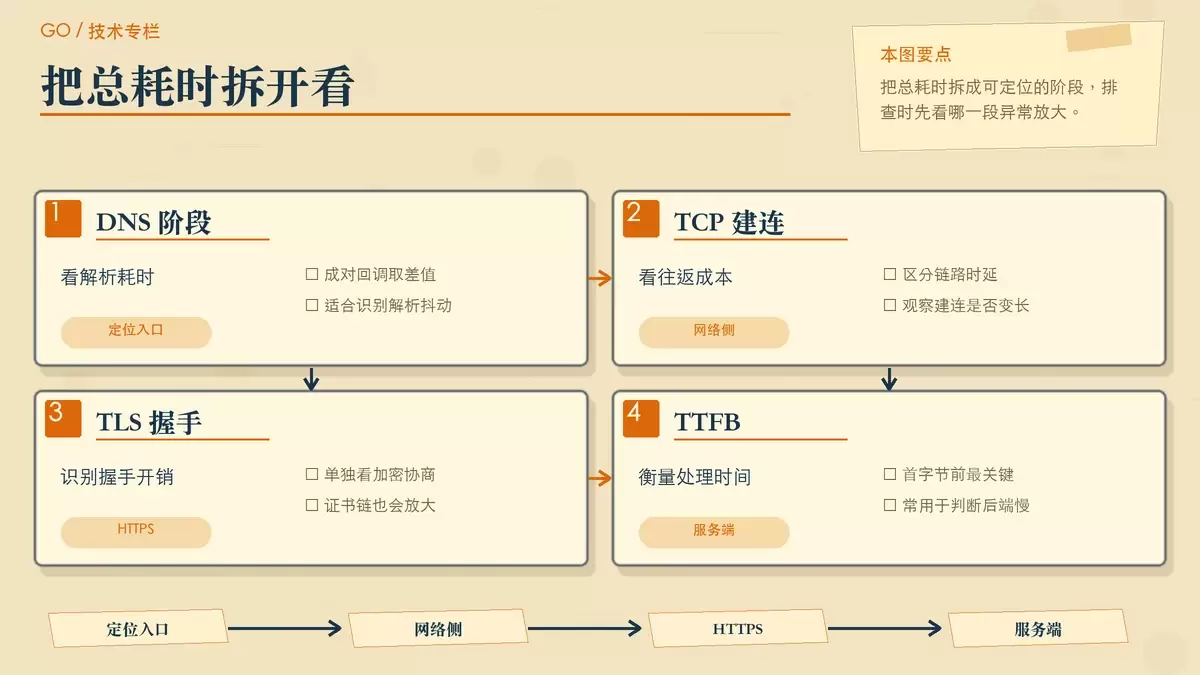
一次完整的 HTTP 请求,至少会经历几个明显不同的阶段:
- DNS 域名解析
- TCP 建连
- TLS 握手(HTTPS 场景)
- 服务端处理并返回首字节,也就是 TTFB
- 连接是否来自连接池复用
如果没有更细的阶段耗时,排查时就很容易陷入猜测:有人怀疑是跨机房 RTT,有人怀疑证书链验证,有人又怀疑是下游业务逻辑本身变慢。httptrace 的价值就在这里,它能把原本混在一起的总耗时拆成一条更可读的“瀑布线索”。
httptrace 的工作方式
Go 在 net/http 内部预留了一套很实用的观察机制,核心对象是 httptrace.ClientTrace。做法并不复杂:在请求发出前,把一组回调函数挂到 Request 的 Context 上,后续传输过程走到关键节点时,底层会自动触发这些回调。
绑定方式如下:
// 将 ClientTrace 注入 Request Context
ctx := httptrace.WithClientTrace(req.Context(), trace)
req = req.WithContext(ctx)
一旦请求进入 http.DefaultTransport 的传输流程,连接池检查、DNS 查询、TCP 建连、TLS 协商、收到响应首字节等节点,都会按时机调用你注册好的 Hook。
这种设计的优点很直接:
- 不需要修改
Transport底层实现 - 埋点对业务代码侵入很小
- 可以精确拿到各阶段耗时
- 适合直接写入日志或接入指标系统
如果你的目标是判断“总耗时为什么突然涨了”,那么 httptrace 基本就是 Go 标准库里最顺手的入口。
关键 Hook 怎么看,分别对应什么问题
想把 HTTP 请求拆清楚,重点关注四组回调就够用了:DNS、TCP/TLS、首字节时间、连接复用状态。
DNS:先确认是不是解析阶段抖动
DNS 解析可以通过 DNSStart 和 DNSDone 这一对回调来测量:
// 监听 DNS 解析起止时间
trace := &httptrace.ClientTrace{
    // DNS 解析开始回调
    DNSStart: func(_ httptrace.DNSStartInfo) {
        dnsStart = time.Now()
    },
    // DNS 解析完成回调
    DNSDone: func(_ httptrace.DNSDoneInfo) {
        dnsDone = time.Now()
    },
}
用 DNSDone 与 DNSStart 的差值,就能得到当前请求的域名解析耗时。若某个下游域名频繁在这里出现明显抖动,通常说明问题可能在本地缓存、DNS 解析链路,或者集群内的 CoreDNS 配置上。
TCP 与 TLS:区分网络往返和加密开销
TCP 建连和 TLS 握手也分别有成对的回调:
// 监控 TCP 建连与 TLS 握手
trace := &httptrace.ClientTrace{
    // TCP 建连开始回调
    ConnectStart: func(_, _ string) {
        connStart = time.Now()
    },
    // TCP 建连完成回调(包含建连结果与错误信息)
    ConnectDone: func(_, _, _ error) {
        connDone = time.Now()
    },
    // TLS 握手开始回调
    TLSHandshakeStart: func() {
        tlsStart = time.Now()
    },
    // TLS 握手完成回调(包含 TLS 状态与握手错误)
    TLSHandshakeDone: func(_ tls.ConnectionState, _ error) {
        tlsDone = time.Now()
    },
}
这里最关键的意义,不只是“看到耗时”,而是把两类问题拆开:
TCP偏高,更接近网络路径、跨机房 RTT、链路质量等问题TLS偏高,更可能与 TLS 协商、证书链校验、加密开销有关
在长连接连接池工作正常的情况下,这两个阶段很多时候会直接表现为 0,因为请求并没有重新建连。如果不先确认这一点,很容易把“首次连接成本”误认为“对方接口响应慢”。
TTFB:判断慢在服务端还是客户端前置阶段
服务端首字节响应时间,也就是 TTFB,可以通过 GotFirstResponseByte 捕获:
// 捕获首字节到达时间(TTFB)
trace := &httptrace.ClientTrace{
    // 收到 HTTP 响应头的第一个字节回调
    GotFirstResponseByte: func() {
        gotFirstByte = time.Now()
    },
}
GotFirstResponseByte 会在客户端收到 HTTP 响应头的第一个字节时立即触发。通常从请求开始计时,到这一刻的间隔,能很好反映服务端处理路径是否变慢。
这项指标在排查时特别有用:如果 DNS、TCP、TLS 都很短,但 TTFB 明显拉长,问题多半已经不在客户端网络侧,而在下游服务端逻辑、依赖调用、数据库查询或线程池拥塞等环节。
连接复用:避免把首次建连误判为接口变慢
是否复用连接,可以通过 GotConn 获取:
// 获取连接复用状态
trace := &httptrace.ClientTrace{
    // 成功建立/取得连接回调(包含连接复用标记 Reused)
    GotConn: func(info httptrace.GotConnInfo) {
        reused = info.Reused
    },
}
这里的 info.Reused 很重要。它告诉你当前请求拿到的是一个新连接,还是连接池里已经存在的长连接。只有把这个维度一并带上,才能正确解读前面的 DNS、TCP 和 TLS 数据。
把 Hook 封装成可落地的 Trace Client
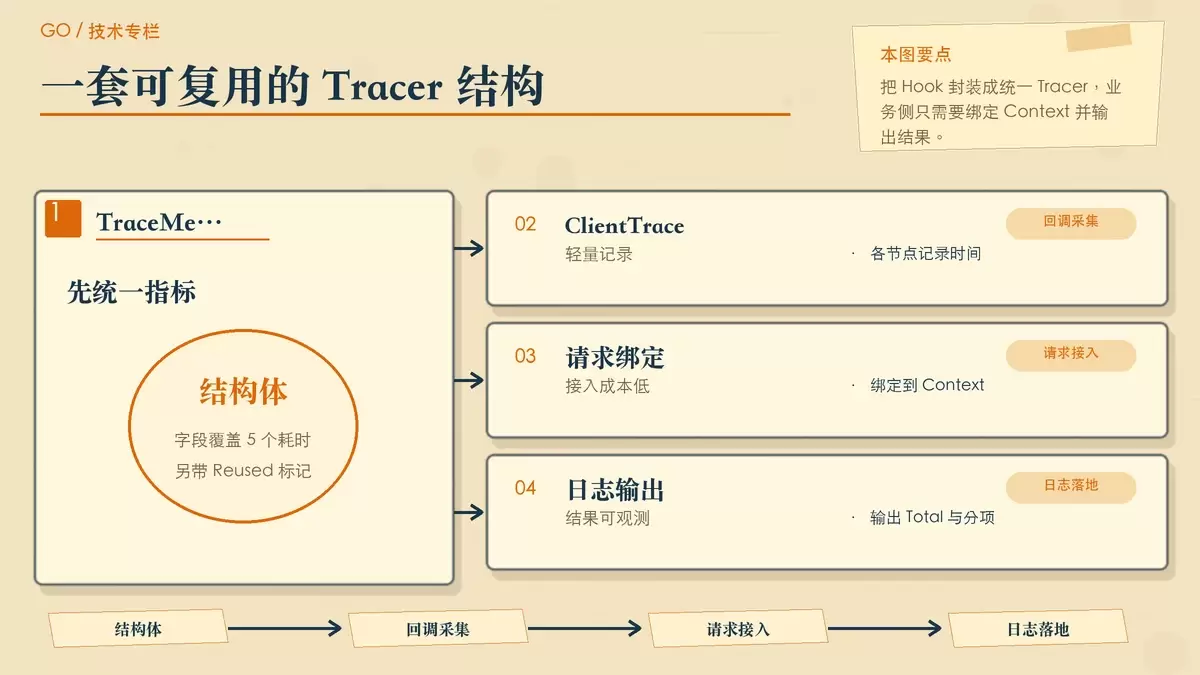
如果每次都手动在业务代码里拼这些时间点,使用成本会比较高。更实用的方式,是把它封装成一个轻量级的 Tracer,在请求结束后直接输出结构化耗时。
先定义一个承载指标的结构体:
type TraceMetrics struct {
    DNS, TCP, TLS, TTFB, Total time.Duration
    Reused                     bool
}
然后在请求发起前构造 ClientTrace,在各个回调里记录阶段耗时:
// 构建 ClientTrace 收集各阶段耗时
trace := &httptrace.ClientTrace{
    // 1. 记录 DNS 解析阶段耗时
    DNSStart: func(_ httptrace.DNSStartInfo) {
        dStart = time.Now()
    },
    DNSDone: func(_ httptrace.DNSDoneInfo) {
        m.DNS = time.Since(dStart)
    },
    // 2. 记录 TCP 建连阶段耗时
    ConnectStart: func(_, _ string) {
        cStart = time.Now()
    },
    ConnectDone: func(_, _, _ error) {
        m.TCP = time.Since(cStart)
    },
    // 3. 记录 TLS 加密握手耗时
    TLSHandshakeStart: func() {
        tStart = time.Now()
    },
    TLSHandshakeDone: func(_ tls.ConnectionState, _ error) {
        m.TLS = time.Since(tStart)
    },
    // 4. 记录连接复用标志与首字节响应耗时 (TTFB)
    GotConn: func(i httptrace.GotConnInfo) {
        m.Reused = i.Reused
    },
    GotFirstResponseByte: func() {
        m.TTFB = time.Since(t0)
    },
}
这段实现的核心思路,是在各个 Callback 被触发时,通过闭包计算时间差,并把结果写入统一的指标结构中。整个过程不需要阻塞网络流程,也不需要额外改造 Transport。
真正发请求时,再把 Trace 绑定到 Context 上:
// 执行 HTTP 请求并打点耗时
req = req.WithContext(httptrace.WithClientTrace(req.Context(), trace))
resp, err := client.Do(req)
m.Total = time.Since(t0)

log.Printf("[HTTP Trace] Total:%v Reused:%t DNS:%v TCP:%v TLS:%v TTFB:%v",
    m.Total, m.Reused, m.DNS, m.TCP, m.TLS, m.TTFB)
最终日志可以长这样:
Total:52ms Reused:false DNS:1.2ms TCP:2.5ms TLS:15ms TTFB:33ms这种输出相比单独一个总耗时,信息密度高很多。比如上面的结果里,TTFB:33ms 占了主要部分,就说明慢点更可能在服务端处理;如果看到 TLS:15ms 异常放大,则排查方向应优先转向 TLS 协商与证书链。
线上使用时的判断方法与注意事项
把 net/http/httptrace 用在线上,价值不只是单次排障,更在于把这些阶段耗时持续沉淀为观测数据。配合 Prometheus 一类监控系统,可以把 DNS、TCP、TLS、TTFB 等指标分别打进 Histogram,进一步观察 P95、P99 的变化趋势。
实际判断时,可以按下面的思路看:
- DNS 偏高:优先排查本地缓存、解析服务、CoreDNS 配置
- TCP 偏高:关注跨机房 RTT、网络链路、连接建立失败重试
- TLS 偏高:关注证书链验证、握手协商成本、HTTPS 配置
- TTFB 偏高:重点看下游服务端逻辑和其内部依赖
Reused:true且 TCP/TLS 接近 0:说明连接池复用正常,问题更可能不在建连阶段
还有一个容易被忽略的点:ClientTrace 的回调函数是在发起 HTTP 请求的那个 Goroutine 中同步执行的。这意味着回调里只能放非常轻的逻辑,例如记录时间、写内存结构、设置标记位。
不适合放进回调里的内容包括:
- 阻塞 I/O
- 高 CPU 计算
- 复杂日志拼装
- 任何可能额外拉长请求路径的操作
否则你本来是在测量请求耗时,结果却把埋点本身变成了新的延迟来源。
对于 Go HTTP 客户端的性能排查来说,httptrace 的优势就在于足够底层、足够标准,而且接入成本很低。只要把各阶段数据稳定打出来,很多“到底慢在哪”的问题,基本都能从猜测变成可验证的结论。















