


Python3实现腾讯云OCR识别

发布时间:2026-10-13 |
3人浏览过
本文介绍了如何使用Python3调用腾讯云OCR接口进行文字识别。由于网上Python2.7示例较多,作者将其改写为Python3版本。文章提供了完整的代码示例,包括签名生成、请求构造及结果解析,并对关键参数进行了说明,供开发者参考使用。
本文将介绍如何使用Python3调用腾讯云OCR接口。由于网上相关示例较少,且多数为Python2.7版本,作者花费时间将其改写为Python3。首先展示腾讯官方提供的示例图片:
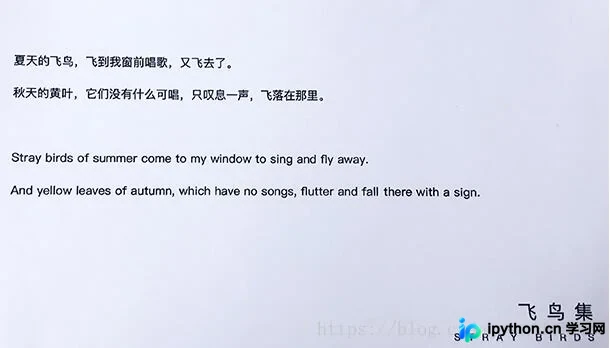
以下是具体的实现代码:
import requests
import hmac
import hashlib
import base64
import time
import random
import re


appid = "你自己的appid"
bucket = " 这个是优图上面的,可以不填" #参考本文开头提供的链接
secret_id = "填自己的" #参考官方文档
secret_key = "填自己的" #同上
expired = time.time() + 2592000
onceExpired = 0
current = time.time()
rdm = ''.join(random.choice("0123456789") for i in range(10))
userid = "0"
fileid = "tencentyunSignTest"

info = "a=" + appid + "&b=" + bucket + "&k=" + secret_id + "&e=" + str(expired) + "&t=" + str(current) + "&r=" + str(
 rdm) + "&u=0&f="

signindex = hmac.new(bytes(secret_key,'utf-8'),bytes(info,'utf-8'), hashlib.sha1).digest() # HMAC-SHA1加密
sign = base64.b64encode(signindex + bytes(info,'utf-8')) # base64转码,也可以用下面那行转码
#sign=base64.b64encode(signindex+info.encode('utf-8'))

url = "http://recognition.image.myqcloud.com/ocr/general"
headers = {'Host': 'recognition.image.myqcloud.com',
   "Authorization": sign,
   }
files = {'appid': (None,appid),
 'bucket': (None,bucket),
 'image': ('1.jpg',open('D:/codes/images/form.jpg','rb'),'image/jpeg')
 }

r = requests.post(url, files=files,headers=headers)

responseinfo = r.content
data = responseinfo.decode('utf-8')

r_index = r'itemstring":"(.*?)"' # 做一个正则匹配
result = re.findall(r_index, data)
for i in result:

 print(i)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















