



不少 Go 项目都会把 defer func() { recover() }() 当成并发代码的“保险丝”,尤其是给每个 Goroutine 入口都包一层,觉得这样就算出了问题也不至于把整个服务拖垮。问题在于,recover 只能接住走 panic 流程的异常;一旦触发的是 Go 运行时直接判定的致命错误,进程仍然会立刻退出。
这篇文章就把最常见、也最容易在面试和线上排障里遇到的 4 类场景拆开说明:哪些错误会让 recover 完全失效,它们分别是怎么触发的,以及工程上该用什么手段提前规避,而不是等进程崩了再补救。
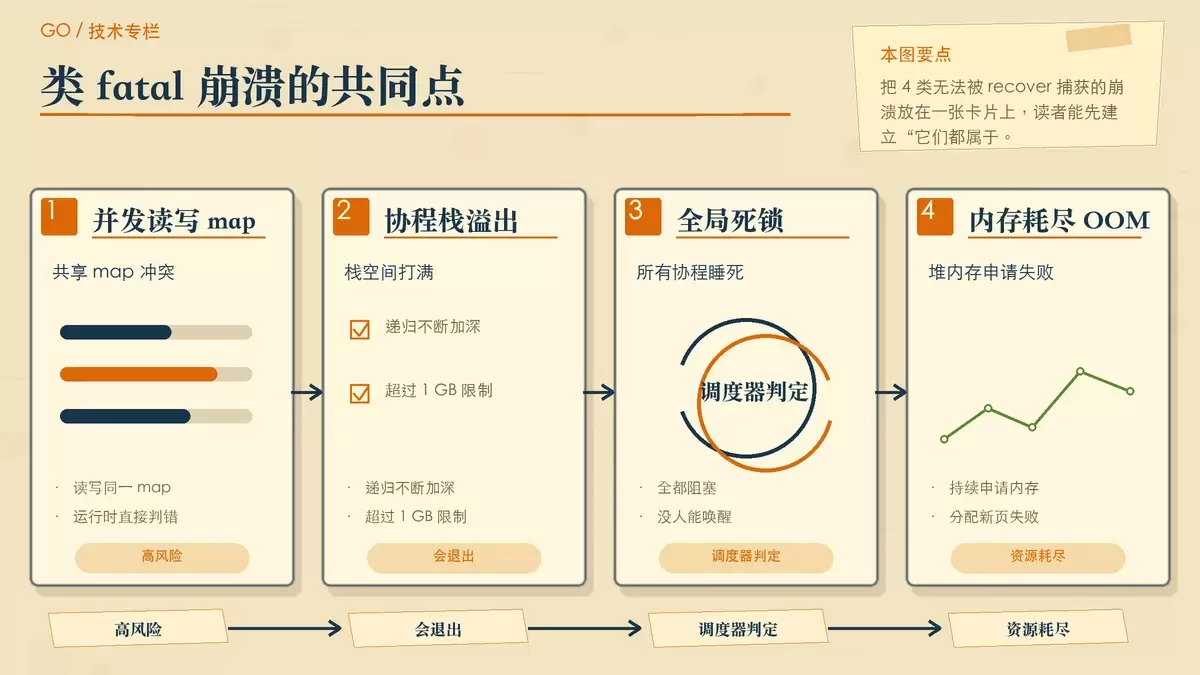
并发读写 map,为什么会直接 fatal
Go 标准库里的 map 不是并发安全结构。只要多个协程同时对同一个 map 写入,或者一边写一边读,就可能直接触发运行时崩溃。
m := make(map[int]int)
go func() {
    for {
        m[1] = 1
    }
}()
for {
    m[1] = 2
}
这段代码即使在 main 协程或子协程入口处加上 recover,运行后依然会报出 fatal error: concurrent map writes,然后整个进程退出。
原因不在业务代码,而在运行时内部。Go 在执行 map 写操作时,会检查哈希表当前的状态标志位;如果发现这个 map 已经处于另一个写入过程里,运行时会直接走致命错误处理逻辑,而不是先抛一个普通 panic 让你在 defer 里慢慢接。
这也是为什么“每个 Goroutine 都包一层 recover”对这类问题没有效果。它不是你漏接异常,而是运行时根本没给你进入恢复流程的机会。
协程栈溢出时,defer 为什么来不及执行
Goroutine 的栈不是固定大小,初始通常只有 2 KB 左右,后续会随着调用深度增长而自动扩容。很多人因此误以为 Go 的递归足够“安全”,但这只是动态扩容,不代表没有上限。
在 64 位系统下,Go 对单个协程栈大小限制为 1 GB。如果递归没有退出条件,或者递归深度失控,最终还是会把栈打满。
var f func()
f = func() {
    f()
}
f()
当递归层数持续增加,超过栈限制后,程序会报出 runtime: goroutine stack exceeds 1000000000-byte limit,随后直接终止。
这里的关键点是:错误发生在运行时申请和扩展栈空间的阶段。到了这一步,当前执行上下文已经不适合再继续跑常规的 defer 链路,recover 也就无从谈起。换句话说,这不是一个“抛出来等你处理”的业务异常,而是运行时判断当前栈已经无法安全继续执行。
这类问题在处理树结构、深度优先遍历、递归下降解析时尤其要小心。代码看起来很优雅,但只要输入规模失控,线上就可能被非常深的调用链直接压垮。
死锁和 OOM,都是调度器与运行时层面的终止
所有协程都睡死时的全局死锁
当 Go 调度器发现所有 Goroutine 都已经阻塞,没有任何一个协程能继续推进程序时,它会判定这是全局死锁。
c := make(chan int)
<-c
上面这段代码里,只有一个接收方,却没有任何发送方。结果就是当前协程永远卡在读取通道的位置,调度器检查后会直接输出 fatal error: all goroutines are asleep - deadlock!。
它之所以无法被 recover 捕获,是因为这不是某个函数内部主动触发的普通异常,而是调度器在全局视角下做出的致命判定。既然连“谁来继续执行并恢复”都不存在了,recover 当然也没有落点。
内存耗尽后,进程没有继续运行的条件
另一类常见的致命退出是 OOM,也就是内存耗尽。触发方式并不复杂:程序持续申请内存,直到操作系统无法再提供可用页,或者超出 Go 运行时可分配的虚拟内存上限。
var slice [][]byte
for {
    slice = append(slice, make([]byte, 100*1024*1024))
}
这种代码会不断向堆申请新空间。一旦底层内存分配失败,运行时就会报出 fatal error: out of memory,然后直接结束进程。
和普通 panic 不同,OOM 不是“程序出错但还能继续清理现场”的状态,而是运行时已经拿不到继续执行所需的基本资源。此时要求它再去跑一轮 defer、再调用一次 recover,本身就不现实。
recover 能处理什么,处理不了什么
理解这件事,关键在于分清 panic 和运行时致命错误不是同一条链路。
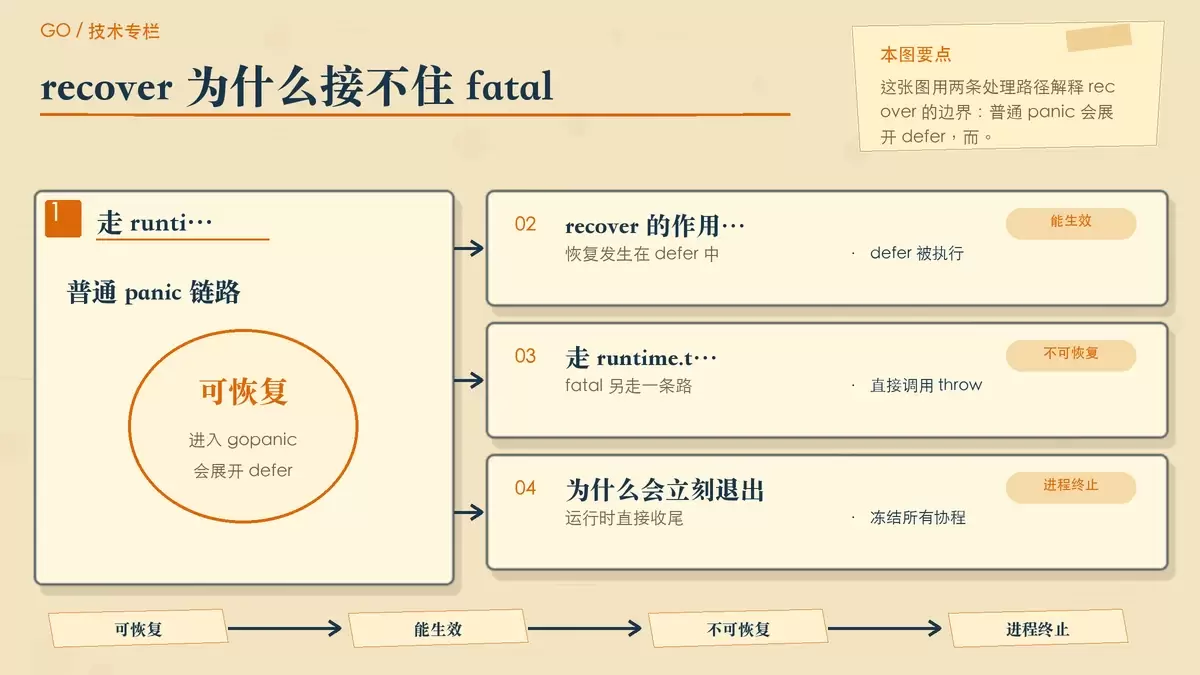
对于常见的空指针、数组越界这类普通 panic,Go 会调用 runtime.gopanic。这个过程中,运行时会把当前异常挂到 Goroutine 的 g 结构体上的 _panic 链表里,然后按顺序执行当前调用栈上的 defer。如果某个 defer 里调用了 recover(),运行时就能把这个 panic 接住,把控制权交回去。
但前面这 4 类情况并不走这条路径。它们会在运行时底层直接调用 runtime.throw 或 runtime.fatalthrow。
这两个函数的处理方式非常直接:冻结所有协程,跳过 defer 执行,直接把堆栈打印到标准错误,然后调用 exit(2) 结束进程。既然 defer 都不会执行,recover 自然也没有任何发挥空间。
所以更准确的说法应该是:recover 只能恢复“当前 Goroutine 正在展开的普通 panic”,而不能拦住运行时已经认定必须终止进程的错误。
工程上怎么防,而不是指望 recover 兜底
既然这些崩溃本质上无法靠 recover 挽回,防线就必须前移到设计、测试和运维层面。
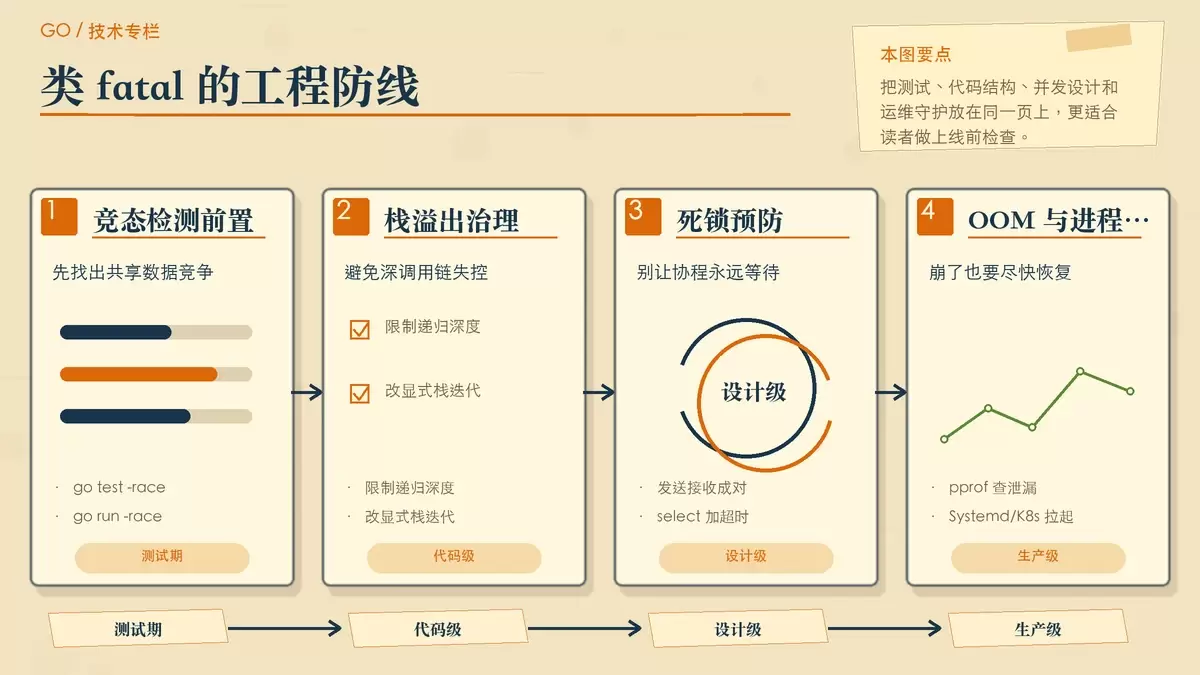
1. 先把并发 map 问题消灭在测试期
对于并发读写 map,最有效的办法不是线上加恢复,而是在开发和 CI/CD 阶段尽早暴露问题。至少要把下面两类命令纳入日常检查:
go test -race
go run -race
-race 能提前发现不少共享内存竞争问题。在明确存在并发访问的地方,应该使用 sync.Mutex 做保护,或者根据场景改用线程安全的 sync.Map。该加锁的地方不加锁,再多的 recover 也只是心理安慰。
2. 对递归深度设边界,核心路径尽量改迭代
栈溢出的治理重点在代码结构。只要递归深度可能被外部输入放大,就应该显式限制最大层数。处理树、图、DFS 之类逻辑时,尤其要评估极端输入下的调用深度。
如果逻辑位于高并发核心链路,通常更稳妥的做法是把递归改成“显式栈 + 循环”的迭代实现。这样不仅更容易控制内存和深度,也能减少极端情况下的栈风险。
3. 通道和锁的设计要能证明不会永久阻塞
死锁问题不能靠事后补救,只能靠设计时约束。使用通道时,要确认每一个发送都有对应接收方,每一个接收也都能等到生产者。
在可能长时间等待的地方,可以用 select 配合超时机制,避免协程无限期卡死。涉及互斥锁时,也要避免锁顺序不一致和循环等待。只要程序进入“所有协程都不能推进”的状态,调度器就会直接宣布失败。
4. OOM 防御一定要覆盖监控、分析和拉起
对于内存耗尽,代码层面的重点是及时排查异常增长和泄漏,常见手段包括用 pprof 做内存分析,结合业务流量观察对象分配是否异常。
但仅靠代码优化还不够。生产环境必须接入外部进程守护,例如 Supervisor、Systemd 或 K8s 容器管理器。因为一旦 Go 进程因 fatal error 退出,应用自身已经无法自救,只能依靠外部系统第一时间拉起新进程。
同时,标准错误中的致命日志要被可靠收集并接入告警。否则服务已经重启多次,团队却还以为只是偶发抖动,真正的问题会被掩盖很久。
结语:别把 recover 当成运行时崩溃的总开关
recover 很有用,但它的能力边界也很明确。它适合处理普通 panic,不适合承担“任何异常都能兜住”的职责。
真正稳妥的做法,是先分清哪些问题属于业务层可恢复异常,哪些问题属于 Go 运行时必须终止的致命错误。对前者用好 panic/recover,对后者则依赖竞态检测、递归深度控制、并发模型设计、pprof 分析,以及外部守护和告警体系。这样写出来的 Go 服务,才不至于在线上把希望寄托在一层并不存在的“万能恢复”上。















