



跨平台 Go 程序一旦碰到底层系统调用,问题往往不在“怎么分支”,而在“代码能不能先编过”。很多人会先想到用 runtime.GOOS 在运行时判断平台,但这只能控制执行路径,无法阻止编译器检查当前文件里的导入、符号和方法调用。
这也是为什么涉及 Windows API、Unix 系统调用这类平台专属代码时,真正可靠的做法是用构建标签和文件命名规则,在编译期把实现彻底隔离开。下面就用一个跨平台文件锁封装,说明这套写法为什么能落地,以及哪些细节最值得提前避坑。
为什么运行时判断不够用
初学者经常会把跨平台处理写成运行时分支,例如通过 runtime.GOOS 决定走哪段逻辑。但这类写法有一个根本限制:即使某个分支永远不会在当前平台执行,只要它和当前文件放在一起,编译器仍然会解析文件中的平台专属导入和符号引用。
比如在 Unix 下编译时,如果同一个源文件里直接引用了 Windows 独有的系统调用,哪怕你外层加了平台判断,编译器仍然会因为符号不存在而报错。问题发生在编译阶段,而不是运行阶段。
Go 的构建标签(Build Tags)就是为这种场景准备的。它的作用不是选择“执行哪条语句”,而是选择“让哪些文件进入本次编译”。一旦把平台代码按文件物理拆开,编译器只会加载符合目标平台的那部分实现,平台冲突也就从源头上消失了,而且没有额外运行时开销。
统一接口怎么设计,平台文件怎么拆
跨平台封装是否好用,关键不只是能编译通过,还在于上层业务代码是否能保持一致。比较稳妥的做法是:在公共文件里定义统一结构和错误,在不同平台文件里分别实现同名方法。
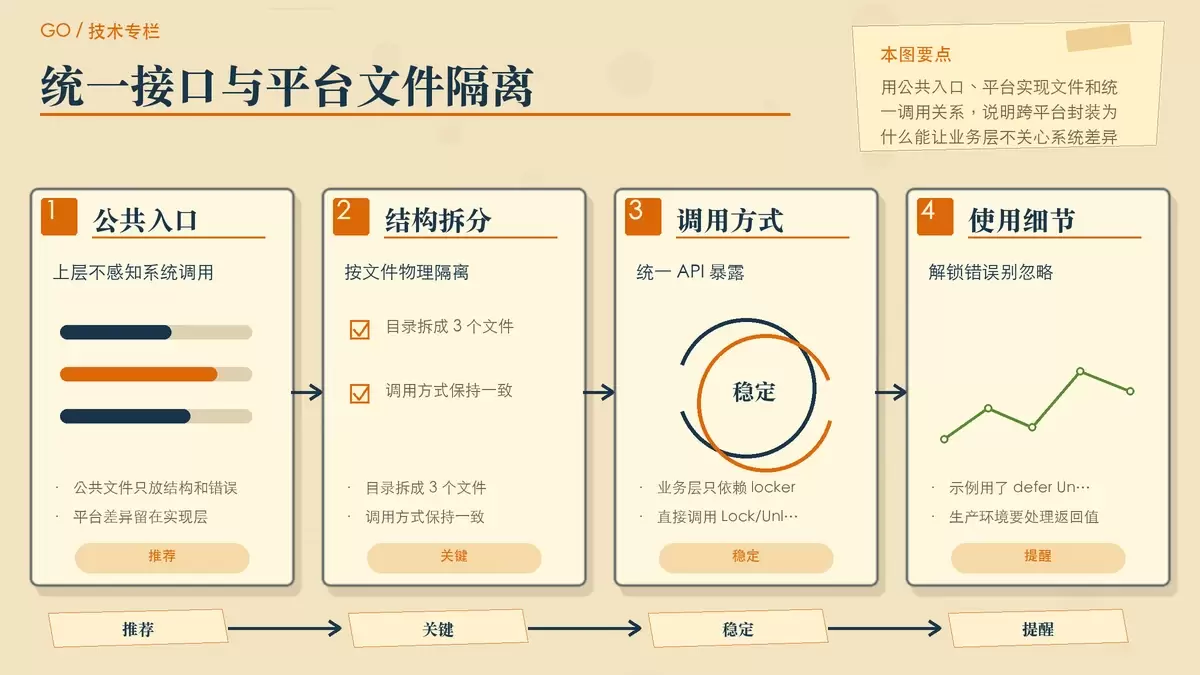
一个典型目录结构可以写成这样:
locker/
├── lock.go          # 统一结构体与公共错误定义
├── lock_unix.go     # Unix 实现,依赖显式构建标签
└── lock_windows.go  # Windows 平台专属实现
其中,公共入口 lock.go 只保留与平台无关的定义:
var ErrLocked = errors.New("file is already locked")

// FileLocker 包装了底层文件句柄,提供跨平台锁能力
type FileLocker struct {
    file *os.File
}

func New(f *os.File) *FileLocker { return &FileLocker{file: f} }
这样做的直接收益是,上层调用方完全不必关心底层到底是 flock,还是 Windows 的字节范围锁。业务层只面向统一 API:
func main() {
    f, err := os.OpenFile("data.lock", os.O_CREATE|os.O_RDWR, 0666)
    if err != nil { log.Fatal(err) }
    defer f.Close()
    lk := locker.New(f)
    if err := lk.Lock(); err != nil {
        log.Fatal("加锁失败:", err)
    }
    defer lk.Unlock()
}
这个封装方式的重点,在于把“平台差异”压缩在适配层内部。示例里为了简洁直接使用了 defer lk.Unlock(),但如果放到生产代码中,通常仍应记录或处理 Unlock 的返回值,避免释放失败被静默忽略。
Unix 平台实现:为什么不能只靠文件名
Unix 侧最容易被误解的一点,是 unix 这个词虽然是 Go 预定义的构建标签,但它并不是合法的 GOOS 文件后缀。也就是说,lock_unix.go 这个文件名本身,并不会像 lock_windows.go 那样被 Go 自动识别为某个平台专属文件。
因此,Unix 这类“平台集合”场景,通常需要显式写出构建标签。原文给出的做法,是明确声明由 golang.org/x/sys/unix.Flock 覆盖的平台范围:
//go:build linux || darwin || freebsd || openbsd || netbsd || dragonfly || solaris
// +build linux darwin freebsd openbsd netbsd dragonfly solaris

package locker

import "golang.org/x/sys/unix"
这里还有两个工程上不能忽略的点。
第一,Go 官方现在更建议新代码优先使用覆盖面更完整的 golang.org/x/sys,而不是继续直接依赖标准库里的 syscall。
第二,构建规则里有一些“标签继承”行为需要提前知道,例如 android 同时满足 linux 标签,ios 同时满足 darwin 标签,illumos 同时满足 solaris 标签。这意味着你在写平台集合时,看到的是几个系统名,实际匹配范围可能比表面更广。
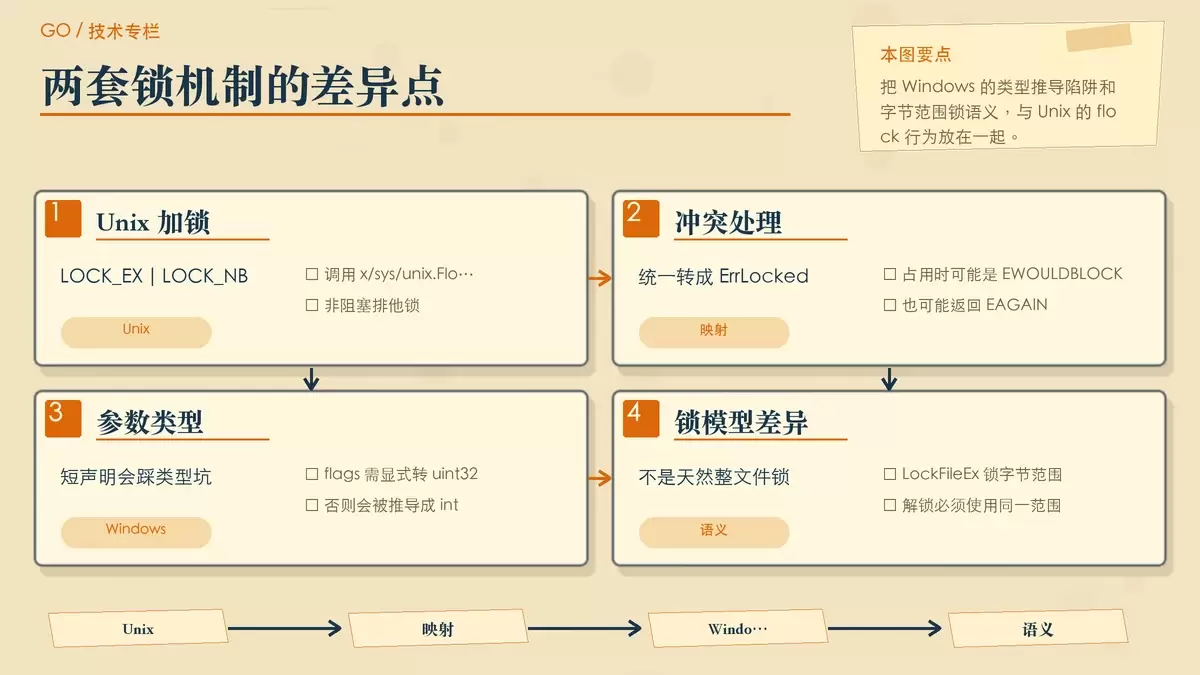
加锁逻辑本身并不复杂,核心是调用 unix.Flock 申请非阻塞排他锁:
// Lock 尝试获取排他锁,若锁被占用则返回 ErrLocked
func (fl *FileLocker) Lock() error {
    fd := int(fl.file.Fd())
    err := unix.Flock(fd, unix.LOCK_EX|unix.LOCK_NB)
    if err == unix.EWOULDBLOCK || err == unix.EAGAIN {
        return ErrLocked
    }
    return err
}
这里把 EWOULDBLOCK 和等价的 EAGAIN 都映射为统一的 ErrLocked,这样上层就不需要理解各平台错误码差异,只处理“文件已被占用”这一业务语义即可。
Windows 实现的两个关键坑:类型推导与锁语义
Windows 侧的文件过滤相对直接,因为 _windows.go 后缀本身就会被 Go 编译器自动识别。不过,在文件顶部额外写出 //go:build windows,仍然是更清晰的工程写法:
//go:build windows

package locker

import (
    "errors"
    "golang.org/x/sys/windows"
)
真正容易出错的,是实现细节。示例中的加锁代码如下:
func (fl *FileLocker) Lock() error {
    var ol windows.Overlapped
    flags := uint32(windows.LOCKFILE_EXCLUSIVE_LOCK | windows.LOCKFILE_FAIL_IMMEDIATELY)
    err := windows.LockFileEx(windows.Handle(fl.file.Fd()), flags, 0, ^uint32(0), ^uint32(0), &ol)
    if err != nil && errors.Is(err, windows.ERROR_LOCK_VIOLATION) {
        return ErrLocked
    }
    return err
}
第一个坑是类型推导。这里的 flags 不能省略 uint32(...) 这个显式转换。原因是用 := 对两个无类型常量做按位或时,Go 会把结果默认推导成 int,而 LockFileEx 的第二个参数要求的是严格的 uint32。如果不转型,代码会直接编译失败。
第二个坑是锁语义并不完全一致。Unix 示例中的 flock 更接近“针对整个文件描述符加锁”,而 Windows 的 LockFileEx 实际锁定的是某个字节范围。为了让封装后的行为尽量接近“锁整个文件”,示例传入了 ^uint32(0), ^uint32(0),表示从起始位置开始覆盖最大 64 位长度。
这也意味着,解锁时必须使用完全对应的字节范围:
func (fl *FileLocker) Unlock() error {
    var ol windows.Overlapped
    return windows.UnlockFileEx(windows.Handle(fl.file.Fd()), 0,
        ^uint32(0), ^uint32(0), &ol)
}
如果只看表面 API,很多人会误以为两端实现只是“函数名不同”。实际上,Windows 与 Unix 在底层锁模型上就存在差异,封装层的价值就在于把这种差异收束为统一接口,但实现者自己必须清楚这些细节没有真的消失。
落地时要守住的三条工程规则
把 build tag 用到项目里,最终拼的不是语法熟悉度,而是工程约束是否足够严谨。下面这三条最值得直接纳入日常检查清单。
1. 方法签名必须完全一致
不同平台实现文件中,对应方法的接收者、方法名、参数列表和返回值都必须一字不差。只要有一侧不一致,最终就会在某个平台下暴露为符号缺失或类型不匹配的编译错误。
2. 构建标签位置和格式不能写错
//go:build 必须放在文件顶部附近,前面只能出现空行或其他注释;在 Go 源文件里,它必须位于 package 声明之前,而且应与后续包声明或包文档之间留出空行。标签本身很短,但放错位置时,问题往往不容易第一眼看出来。
3. 理解显式标签与隐式命名规则的边界
Go 编译器原生支持 _GOOS.go、_GOARCH.go、_GOOS_GOARCH.go 这类文件名过滤规则,例如 lock_windows.go 就属于隐式过滤。需要查看完整平台列表时,可以直接使用:
go tool dist list实际项目中,可以把两套机制配合使用:单一平台且命名清晰的文件,用后缀约束;涉及多个系统组成的平台集合时,再用显式 build tag 补足表达能力。
整体看下来,Go 处理跨平台系统代码的思路其实很明确:公共声明放在统一入口,平台实现按文件物理隔离,编译器只加载当前目标平台真正需要的那部分代码。这样既能保留底层系统调用的原生能力,也能给上层业务提供零运行时判断、零平台污染的统一 API。















