


Python3中Byte类型详解:文本与二进制数据的清晰区分

发布时间:2026-10-13 |
4人浏览过
本文详解Python3中新增的byte类型,阐述其与Unicode文本的严格区分。重点介绍encode和decode方法在UTF-8编码下的应用,以及网络数据传输中必须使用二进制格式的原因,帮助开发者正确处理字符串与字节的转换。
在Python2中,字节类型与字符类型的界限较为模糊,但在Python3中,一个核心改进是对文本数据和二进制数据进行了更明确的划分。文本始终由Unicode字符类型表示,而二进制数据则由byte类型处理。Python3禁止在字节型和字符型之间进行任何隐式混合操作,这意味着在Python3中无法直接拼接字符串与字节对象(Python2中会自动转换),也无法在字节对象中搜索字符串,或者将字符串传递给期望字节参数的函数。
需要特别注意的是,在网络数据传输场景中,Python2允许直接通过字符串(string)进行传输,而Python3强制要求使用二进制(bytes)格式。因此,在涉及网络通信时,必须对传输的文本数据进行相应的编码转换。
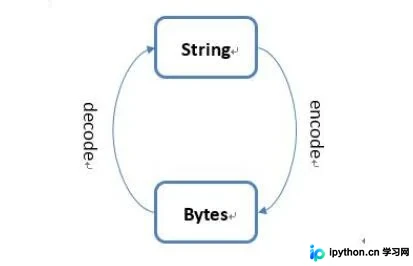
具体示例如下所示:
>>>'你好'.encode('utf-8')

b'\xe4\xbd\xa0\xe5\xa5\xbd'

>>> b'\xe4\xbd\xa0\xe5\xa5\xbd'.decode('utf-8')

'你好'

 >>>'你好'.encode('utf-8').decode('utf-8')
'你好'
其中涉及的关键点包括:
首先,encode()和decode()方法默认使用UTF-8编码,但为了确保程序的健壮性和避免潜在错误,建议显式指定编码格式。
其次,encode()方法返回结果前缀的“b”代表二进制(binary),表明该对象为字节类型。
以上关于Python3新增byte类型的详细解析到此结束,希望能为读者提供有价值的参考。欢迎大家继续支持本站,获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















