



调用 http.Get 或 client.Do 后,很多人会顺手写上 defer resp.Body.Close(),但真到解释原因时,常常只停留在“防止泄漏”这一层。更准确的理解是,resp.Body 代表一次 HTTP 响应的数据流,成功拿到响应后,关闭它就是调用方的职责;而在高频请求场景里,是否把响应读完,还会进一步影响连接能不能继续复用。
这篇文章把这件事拆成几个实际开发里最常见的问题:什么情况下是“必须关闭”,为什么“只关闭”还不够,遇到不关心响应内容、响应体大小未知、以及循环请求时又该怎么写。看完之后,你可以用同一套判断标准处理面试题和生产代码。
为什么拿到响应后就要关闭 Body
一个很常见的疏漏,是代码只关心状态码,却忘了处理响应体的生命周期:
func ping(url string) error {
    resp, err := http.Get(url)
    if err != nil {
        return err
    }
    if resp.StatusCode != http.StatusOK {
        return fmt.Errorf("status: %s", resp.Status)
    }
    return nil
}
这段代码的问题不在业务判断,而在于 resp.Body 从头到尾都没有关闭。它的类型是 io.ReadCloser,不只是“返回内容”,还关联着底层传输资源。
net/http 的责任边界很明确:只要请求成功返回、err == nil,那么响应里的 Body 一定不是 nil。即便响应没有正文,或者长度为 0,关闭它仍然是调用方的责任。
因此,成功拿到响应之后,通常第一时间就应该安排关闭:
resp, err := http.Get(url)
if err != nil {
    return err
}
defer resp.Body.Close()

if resp.StatusCode != http.StatusOK {
    return fmt.Errorf("status: %s", resp.Status)
}
这里有两个关键点:
1. `defer` 要放在错误判断之后
只有在 err == nil 时,才能安全使用 resp。请求失败时,不能假设它可用。
2. 关闭是底线,不是全部优化
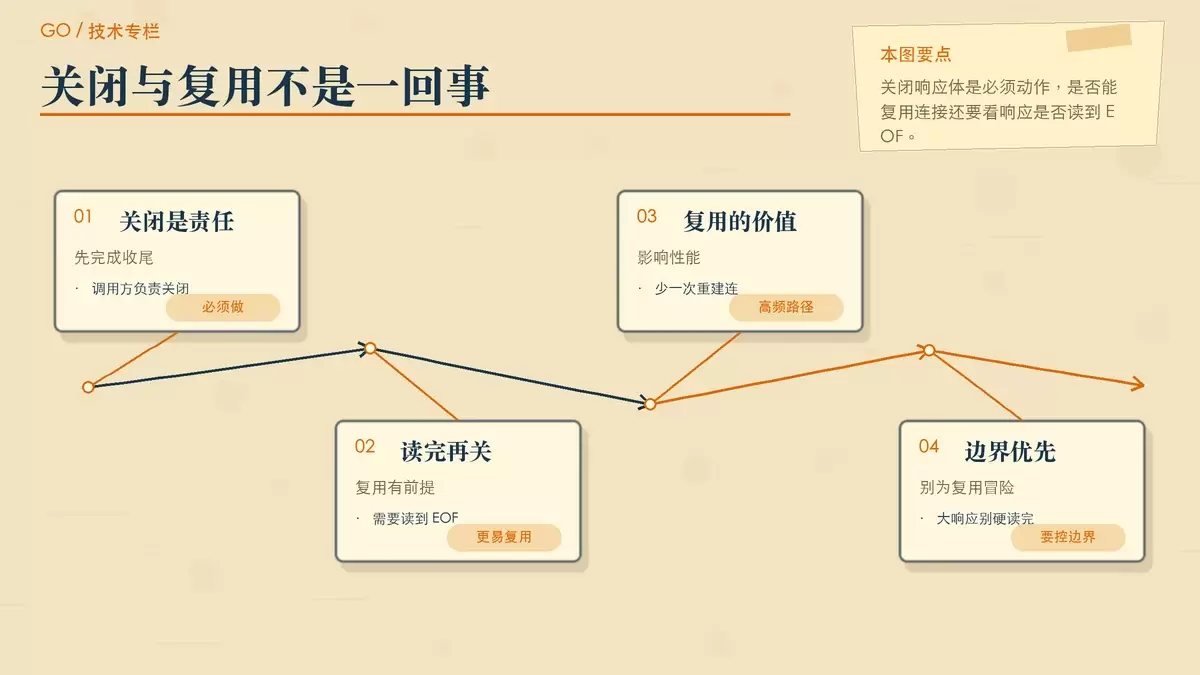
这段写法已经满足“成功得到响应后必须关闭”的基本要求,但如果你还希望默认客户端下的 HTTP/1.x 持久连接尽量被后续请求复用,通常还要继续考虑响应体是否被完整读完。
为什么只关闭还不一定够
很多人把“关闭响应体”和“连接可复用”混为一谈,实际它们是两层不同的问题。
关闭响应体,解决的是这次请求的资源收尾;而连接能否留给下一次请求继续使用,还和响应内容是否已经读取到 EOF 有关。Go 对 Client.Do 的说明也指出,如果响应体没有读取到 EOF 并关闭,底层 Transport 可能无法复用这条持久 TCP 连接。
也就是说,下面这段代码虽然做到了 Close,但仍可能丢掉连接复用机会:
resp, err := http.Get(url)
if err != nil {
    return err
}
defer resp.Body.Close()
return nil // 响应体完全没有读取
在偶发请求里,这个影响可能不明显;但在健康检查、批量采集、轮询任务、调用下游 API 这类高频路径中,不能复用连接就意味着更频繁地重新建连,额外的延迟和资源开销都会堆出来。
不过,读完响应体也不是绝对规则。关键在于场景:
- 如果本来就要解析一个很小的 JSON 或文本响应,那么正常读取到结束再关闭,通常就足够了。
- 如果面对的是下载接口、流式返回,或者大小未知的响应体,就不能为了“争取复用”而无边界地把内容全部读进内存。
换句话说,连接复用是收益,资源边界是前提。代码应该优先保证可控,而不是机械地追求“每次都读完”。
不关心响应内容时该怎么处理
有些请求只是想确认接口是否成功,并不需要真正消费返回内容。这时怎么写,取决于你对响应体大小有没有把握。
响应体很小:读到 EOF 再关闭
如果接口契约已经确认响应体很小,可以把内容直接丢弃掉,读完后再关闭:
func finish(resp *http.Response) {
    _, _ = io.Copy(io.Discard, resp.Body)
    _ = resp.Body.Close()
}
这个写法的意义不是“拿内容来用”,而是明确把流读到 EOF,让底层连接更有机会继续复用。它适合大小有明确约束的接口。
响应体未知或不可信:限制读取后关闭
如果对方可能返回很大的错误页面、异常堆栈,甚至长流数据,盲目读完整个响应就不稳妥了。更合适的做法是只截取一小段必要内容用于排查,然后关闭:
func errorDetail(resp *http.Response) string {
    defer resp.Body.Close()
    b, _ := io.ReadAll(io.LimitReader(resp.Body, 4<<10))
    return string(b)
}
这里通过 io.LimitReader 把读取量限制在 4 KB。这样做的重点是控制资源消耗,而不是追求连接复用。因为一旦没有读到 EOF,这次连接通常就不该再指望被复用。
实际工程里,这两类写法分别对应两种优先级:
- 已知小响应时,优先完整消费,争取复用连接。
- 未知大响应时,优先限制资源边界,复用能力让位于稳定性。
循环请求里,为什么不能把 `defer` 直接堆在外层
另一个非常常见的坑,是在循环中对每次请求都写 defer resp.Body.Close():
for _, url := range urls {
    resp, err := client.Get(url)
    if err != nil {
        continue
    }
    defer resp.Body.Close() // 循环结束前不会执行
    process(resp.Body)
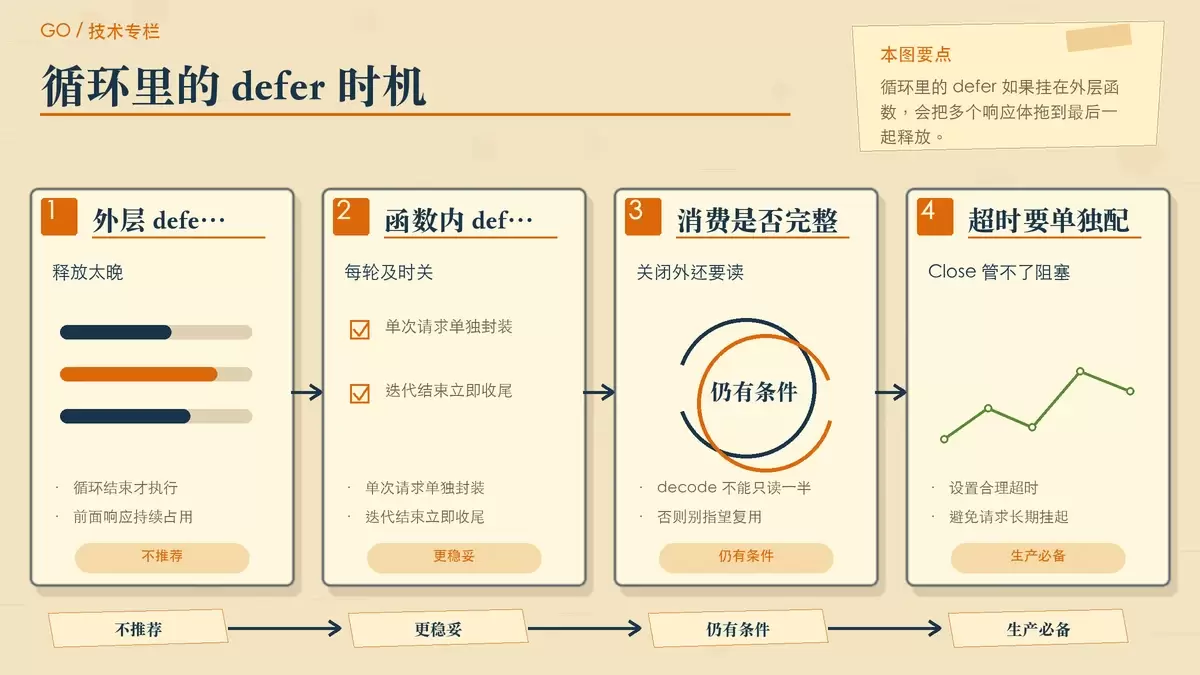
}问题在于,defer 的执行时机不是“本轮循环结束”,而是“当前函数返回”。如果这是一个长循环,前面几次请求的响应体会一直拖到整个函数结束才关闭,资源会被不必要地占住。
更合适的方式,是把单次请求包装成独立函数,让每一轮迭代在函数返回时立即完成收尾:
func fetch(client *http.Client, url string) error {
    resp, err := client.Get(url)
    if err != nil {
        return err
    }
    defer resp.Body.Close()
    return decode(resp.Body)
}
然后在循环里调用 fetch。这样每次处理完一个 URL,响应资源都会及时释放,不会在外层函数里持续堆积。
这里还有一个容易被忽略的细节:即使你已经把关闭时机放对了,如果 decode(resp.Body) 只读取到一半就返回,那么连接复用这件事依然没有保证。也就是说,循环里要同时考虑两件事:
- 每次迭代都要及时关闭响应体。
- 如果目标是提高 HTTP/1.x 连接复用率,单次处理逻辑还应尽量完整消费响应内容。
此外,生产环境下还应给客户端设置合理超时。Close 解决的是“请求已返回之后怎么收尾”,并不能处理请求长期阻塞、迟迟不返回的问题。
面试和实战里,如何把这件事说清楚
如果把“为什么一定要关闭 resp.Body”作为一道面试题,比较完整的回答可以分成三层:
resp.Body是调用方持有并管理的响应数据流。只要Do成功返回,关闭它就是调用方责任。- 关闭只解决资源释放,不等于连接一定复用。对于 HTTP/1.x,通常还要把响应读取到 EOF 并关闭,底层连接才更有机会继续给后续请求使用。
- 真正落到代码时要按场景取舍:小响应可以读完或丢弃到 EOF;未知大小响应应限制读取量后关闭;循环请求不要把
defer一路堆到外层函数结束。
这样的回答比一句“防止资源泄漏”更完整,因为它同时覆盖了官方约定、连接复用机制,以及实际工程中的边界控制。
归根到底,defer resp.Body.Close() 不是格式化习惯,而是 HTTP 客户端调用必须完成的收尾动作。忘记关闭,网络资源可能得不到及时释放;只关闭不读取,又可能让高频请求失去持久连接带来的效率优势。小响应就完整读取后关闭,未知响应就先守住资源边界,再谈复用,这才是更稳妥的 Go 写法。















