


Python使用NumPy实现可复现的数据集切分

发布时间:2026-10-13 |
6人浏览过
本文介绍在Python中如何使用NumPy将数据集随机切分为训练集和测试集。针对随机切分结果不固定的问题,通过调用np.random.seed(43)设置随机种子,确保每次运行代码时生成的索引序列一致,从而实现可复现的数据划分效果。
在数据处理流程中,通常需要将原始数据集划分为训练集和测试集,以下记录具体的切分实现代码。
'''
data:数据集
test_ratio:测试机占比
如果data为numpy.numpy.ndarray直接使用此代码
如果data为pandas.DatFrame类型则
  return data[train_indices],data[test_indices]
修改为
  return data.iloc[train_indices],data.iloc[test_indices]
'''
def split_train(data,test_ratio):
  shuffled_indices=np.random.permutation(len(data))
  test_set_size=int(len(data)*test_ratio)
  test_indices =shuffled_indices[:test_set_size]
  train_indices=shuffled_indices[test_set_size:]
  return data[train_indices],data[test_indices]
基础测试代码如下:
import numpy as np
import pandas as pd
data=np.random.randint(100,size=[25,4])
print(data)
运行结果如下:
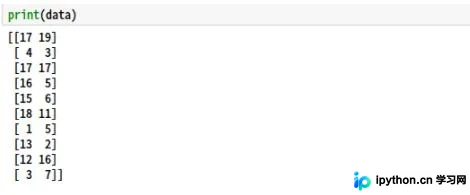
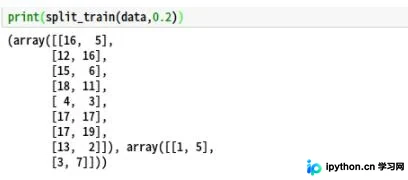
从输出结果可见,原始数据集已按5:1的比例被随机分割为两部分。然而,该方法存在一个显著缺陷:每次调用该函数对同一数据集进行切分时,生成的结果均不相同。为解决此问题,需在执行np.random.permutation(len(data))之前,先调用np.random.seed(int)函数以固定随机种子,从而保证每次切分结果的一致性。
基于上述分析,将原函数优化修改为:
def split_train(data,test_ratio):
  np.random.seed(43)
  shuffled_indices=np.random.permutation(len(data))
  test_set_size=int(len(data)*test_ratio)
  test_indices =shuffled_indices[:test_set_size]
  train_indices=shuffled_indices[test_set_size:]
  return data[train_indices],data[test_indices]
在此函数中,当np.random.seed(43)的参数为相同的整数时,后续生成的随机数序列将保持一致。
以上关于Python数据集切分的实例分享完毕,旨在提供参考,欢迎支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















