


Python3.5 读取txt文件并过滤指定行数据的方法

发布时间:2026-10-13 |
3人浏览过
本文介绍使用Python3.5读取txt文件,通过正则表达式提取每行逗号后的数值,并过滤掉小于9.500或大于12.500的行,最终将保留的数据写入新文件的完整代码与步骤。
该问题源自技术问答社区,此处分享具体的实现代码供参考。
#coding:utf-8
#python3.5.1

import re

file_path0 = r'G:\任务20180312\test/handle1.txt'

f = open(file_path0)
#读取全部内容
lines = f.readlines() #lines在这里是一个list
#获取行数
nums = len(lines)
#建立一个空列表
rows_get = []
#循环行数
for i in range(nums):
 line = lines[i] #line类型为str
 #开始用正则得到数字部分,并判断
 #给定正则规则
 p = r',(.+)' #发现每行取逗号后面部分就行
 #编译正则
 pattern = re.compile(p)
 try:
  #查找,用try判断是因为还存在空行
  number = re.findall(pattern,line)[0] #这里number类型 str
  #去除空格
  number = number.strip()
  #转换int,便于比较
  number = float(number)
  #判断数字小于9.500和大于12.500的行删除
  if number <9.500 or number>12.500:
   pass
  else:
   rows_get.append(i)

 except:
  continue
#rows_get使我们所需要的数据
print(rows_get)

#建立空字符串
text = ''
for x in rows_get:
 #得到想要的每行数据
 row = lines[x]
 #叠加
 text = text + row

with open(r'G:\任务20180312\test/handle1_get.txt','w') as f:
 f.write(text)
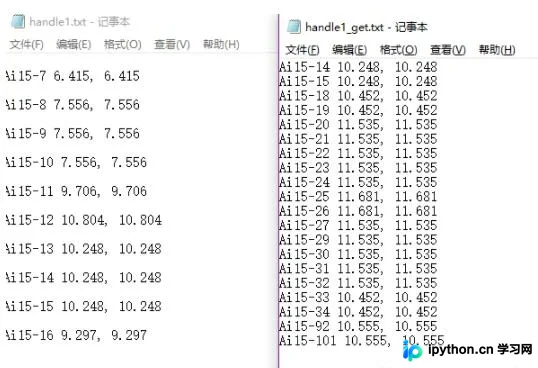
程序运行后的输出结果如下图所示:
希望上述内容能对您有所帮助,欢迎采纳。
以上关于Python3.5处理txt文件并删除不需要的行的方法即为全部分享,旨在为读者提供实用参考,同时也感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















