


Python读取TXT文件特定行数据并清洗格式

发布时间:2026-10-13 |
2人浏览过
本文介绍利用Python读取TXT文件中特定格式行的方法。通过正则表达式匹配以数字加冒号开头的行,提取目标数据,并使用replace函数去除逗号与冒号,实现数据格式的规范化处理。
如何编写Python代码,循环读取.txt文件中被红括号标记的特定数据?
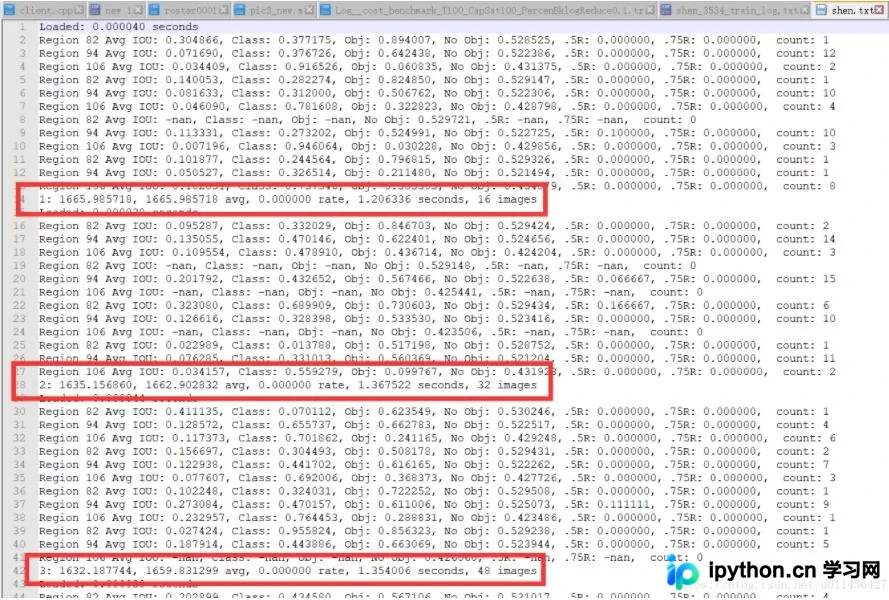
观察数据特征发现,各行首部的第一个数据元素存在差异,因此决定直接采用正则表达式进行匹配处理。
在此基础上,结合对文件读写操作的标准流程,即可完成数据处理任务。
注意:本示例基于pycharm环境及python2.7版本进行演示。
以下直接展示具体代码实现。
import re

f1=file('shen.txt','r')
data1=f1.readlines()
# print data1
f1.close()
results = []

for line in data1:
 data2=line.split()
 # print data2[0]
 m = re.findall(r"[0-9]:", data2[0])
 if m:
  results.append(line)

 # for i in data2[0]:
  # data3=i.split(":")
  # print data3
  # if data3>=0 and data3<=50000:
  #  results.append(line)


  # if i=='1':
  #  results.append(line)


f2=file('deal.txt','w')
f2.writelines(results)
f2.close()
此前在处理类似“1:”格式的字符串时曾遇到阻碍,经查阅资料后,发现正则表达式能高效解决此类问题。
对上述代码的关键部分说明如下:
m = re.findall(r"[0-9]:", data2[0])
该语句旨在针对字符串内容,筛选出符合“1:”、“2:”、“9:”等以数字后跟冒号模式的字符串片段。
经过初步正则匹配处理后的结果如下:
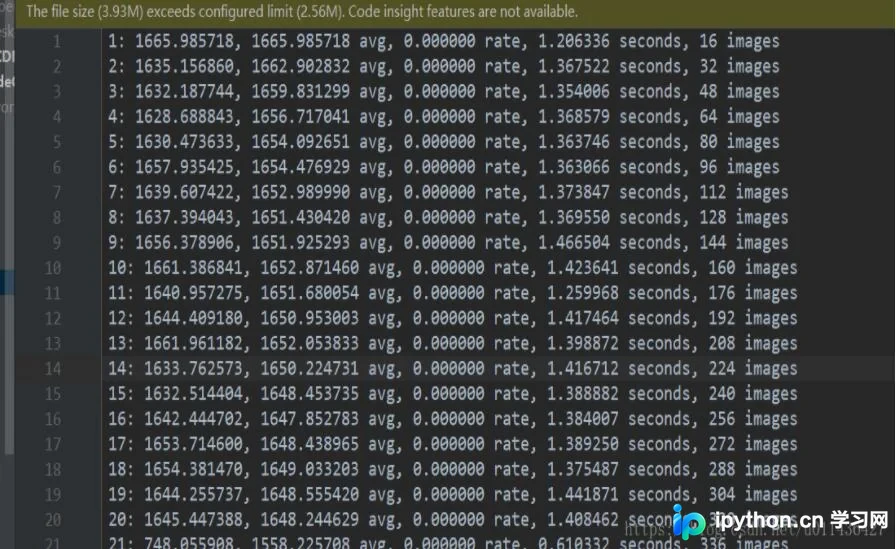
鉴于原始数据格式尚不够规范,需进一步去除其中的“,”和“:”符号,故在此处调用replace语句进行替换。
具体替换代码如下:
#coding:utf-8
#__author__ ='dell'

import re

f1=file('shen.txt','r')
data1=f1.readlines()
# print data1
f1.close()
results = []

for line in data1:
 data2=line.split()
 # print data2[0]
 m = re.findall(r"[0-9]:", data2[0])
 if m:
  results.append(line)

 # for i in data2[0]:
  # data3=i.split(":")
  # print data3
  # if data3>=0 and data3<=50000:
  #  results.append(line)


  # if i=='1':
  #  results.append(line)

f2=file('deal.txt','w')
f2.writelines(results)
f2.close()

# 替换掉所有的逗号,
f4=open('deal.txt','r')
data3=f4.read()
f4=data3.replace(',',' ')
f5=file('deal.txt','w')
f5.write(f4)
f5.close()

# 替换掉所有的冒号
f6=open('deal.txt','r')
data4=f6.read()
f6=data4.replace(':',' ')
f7=file('deal.txt','w')
f7.write(f6)
f7.close()
最终输出的数据格式已变得整洁清晰,展示如下:
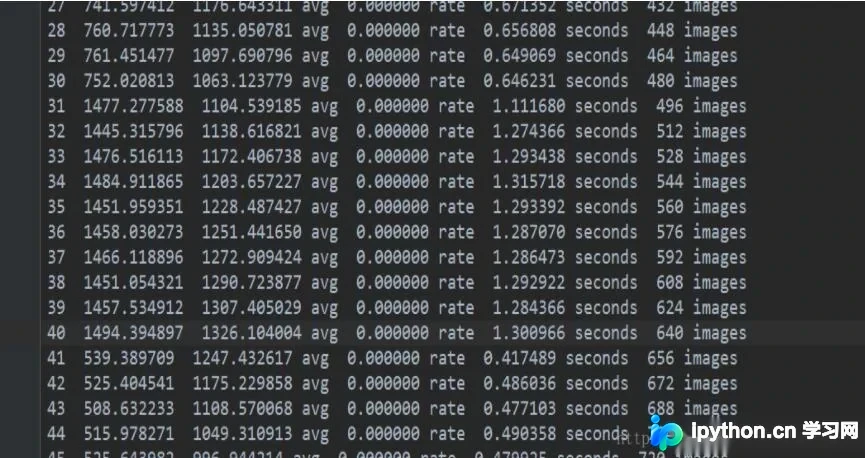
以上关于使用Python读取.txt文件特定行数据的方法即为全部分享,希望能为读者提供参考,并期待大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















