


Python数据分析中正则表达式匹配字符串与常用函数示例详解

本文深入解析Python数据分析中正则表达式的应用,详细讲解re.match、re.search与re.findall三大核心函数的区别与用法。涵盖字符集、量词、贪婪与非贪婪模式、分组捕获及sub替换与compile优化等关键语法,并通过综合案例演示如何从复杂日志中提取用户ID、订单号及支付金额,助力高效数据清洗。
前言
在实际的数据分析项目中,原始数据通常质量参差不齐,包含大量非结构化文本,例如用户评论、系统日志或网页抓取内容。面对这些数据,如何精准提取电话号码、邮箱地址、日期格式或金额等关键信息?解决这一问题的核心工具正是正则表达式(Regular Expression)。
Python通过标准库 re 提供了强大且灵活的正则表达式支持。本文将系统梳理正则表达式在数据分析中的核心应用场景,主要内容包括:
- 字符串匹配函数(match、search、findall)
- 正则表达式基础语法(字符范围、重复次数、字符类)
- 贪婪模式与非贪婪模式的区分
- 分组机制与逻辑“或”运算
- 内容替换与编译优化(sub、compile)
一、匹配字符串:三大核心函数
1.re.match():从字符串开头匹配
- 功能说明:该函数仅检查字符串的起始位置是否符合给定的正则模式。
- 返回结果:若匹配成功,返回
Match对象;若未匹配,则返回None。
调用格式:
re.match(参数1,参数2)
该函数用于从参数2(字符串类型数据)中查找符合参数1(正则表达式)的内容。
示例代码:
import re

messaga = '张三、李四、王五、赵六、张三'
result = re.match('张三', messaga)
print(result)

result1 = re.match('李四', messaga)
print(result1)
代码执行结果:
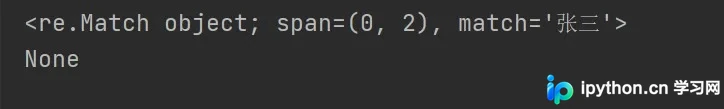
- 输出中的 span=(0, 2) 表示在字符串索引 0 到 2 的位置匹配成功。
- 输出中的 match='张三' 表示实际匹配到的文本内容为“张三”。
2.re.search():全文搜索首次匹配
- 功能说明:在整个字符串中查找第一个符合正则模式的匹配项。
- 返回结果:返回首个匹配的
Match对象,若未找到则返回None。
调用格式:
re.search(参数1,参数2)
该函数用于从参数2(字符串类型数据)中查找符合参数1(正则表达式)的内容。如果存在多个匹配项,仅返回第一个匹配成功的信息。
示例代码:
messaga1 = '张三、李四、王五、赵六、王五'
result2 = re.search('王五', messaga1)
print(result2)
代码执行结果:
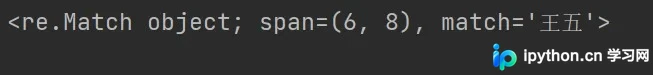
注意:该函数仅返回第一个匹配成功的信息。
3.re.findall():查找所有匹配项
- 功能说明:返回所有非重叠匹配结果的列表。
- 返回结果:若无分组,返回字符串列表;若包含多个分组,则返回元组列表。
调用格式:
re.findall(参数1,参数2)
该函数用于从参数2(字符串类型数据)中查找符合参数1(正则表达式)的内容。如果存在多个匹配项,将返回所有匹配成功的信息。
import re

messaga1 = '张三、李四、王五、赵六、王五'
result3 = re.findall('王五', messaga1)
print(result3)

运行结果:
['王五','王五']
需要注意的是,findall() 不返回匹配的位置信息,仅返回匹配的全部内容。
二、正则表达式基础语法
表示字符范围:[...]
使用方括号定义可接受的字符集合:
| 表达式 | 含义 |
|---|---|
[abc] | 匹配 a、b 或 c |
[a-z] | 匹配任意小写字母 |
[0-9] | 等价于 \d,匹配数字 |
[^0-9] | 取反,匹配非数字字符 |
示例:
import re

message = 'Pythonnnnncc93,c87,Javac63,C++88'
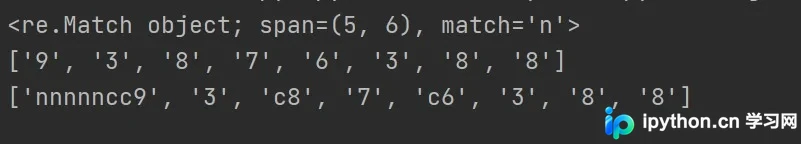
result_1 = re.search('[cn]', message)  # 只返回第一个匹配成功的信息
result_2 = re.findall('[0-9]', message)
result_3 = re.findall('[cn]*[0-9]', message)
print(result_1)
print(result_2)
print(result_3)
运行结果:
表示字符出现的次数(量词)
| 符号 | 含义 | 示例 |
|---|---|---|
* | 0 次或多次 | ab* → "a", "ab", "abb" |
+ | 1 次或多次 | \d+ → 至少一个数字 |
? | 0 次或 1 次 | colou?r → "color" / "colour" |
{n} | 恰好 n 次 | \d{4} → 四位年份 |
{n,} | 至少 n 次 | \d{3,} → 三位及以上数字 |
{n,m} | n 到 m 次 | \d{2,4} → 2~4 位数字 |
示例:
import re

message1 = 'da2a7ddbre77yifed777t3fefd777b'
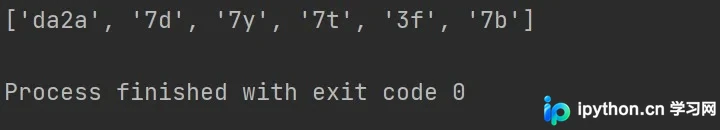
result = re.findall('[a-z]*[0-9][a-z]', message1)
print(result)
运行结果:
表示同一类字符(预定义字符类)
| 符号 | 等价写法 | 含义 |
|---|---|---|
\d | [0-9] | 数字 |
\D | [^0-9] | 非数字 |
\w | [a-zA-Z0-9_] | 单词字符(字母、数字、下划线) |
\W | [^a-zA-Z0-9_] | 非单词字符 |
\s | [ \t\n\r\f\v] | 空白字符 |
\S | [^\t\n\r\f\v] | 非空白字符 |
\b | 单词边界,即单词中与空格邻接的字符 | |
\B | 非单词边界 | |
\f | 分页符 | |
\n | 换行符 | |
\r | 回车符 | |
\t | 制表符 | |
\v | 垂直制表符 | |
.: | 匹配除"\n"和"\r"之外的任何单个字符 |
示例:清洗文本中的非字母数字字符
import re

text = "Hello, World! 123 @#$"
clean = re.sub(r"\W", " ", text)  # \W = 非单词字符
print(clean)  # "Hello  World  123   "
三、贪婪模式 vs 非贪婪模式
贪婪和非贪婪模式决定了匹配时是否尽可能多地包含字符,具体应用如下:
- 默认情况下为贪婪模式:尽可能多地匹配字符。
- 非贪婪(惰性)模式:在量词后添加
?,以尽可能少地匹配字符。
text = "<div>Hello</div><div>World</div>"

# 贪婪:匹配整个字符串
print(re.search(r"<div>.*</div>", text).group())
# 输出:<div>Hello</div><div>World</div>

# 非贪婪:只匹配第一个标签
print(re.search(r"<div>.*?</div>", text).group())
# 输出:<div>Hello</div>
数据分析提示:在提取 HTML/XML 标签或 JSON 片段时,务必使用非贪婪模式以避免过度匹配。
四、“或”和分组(Grouping)
逻辑“或”:|
re.findall(r"jpg|png|gif", "image1.jpg, image2.png, icon.gif")
# 输出:['jpg', 'png', 'gif']
分组:(...)与捕获
使用括号将模式分组,便于提取子内容:
date_str = "2025-04-05"
match = re.search(r"(\d{4})-(\d{2})-(\d{2})", date_str)
print(match.groups())      # ('2025', '04', '05')
print(match.group(1))      # '2025'(年)
五、sub()和compile()方法
re.sub():替换匹配内容
- 功能说明:将匹配到的文本替换为指定的字符串。
- 语法格式:
re.sub(pattern, repl, string)
import re

text = "Call me at 138****5678"
cleaned = re.sub(r"\d{3}\*\*\*\d{4}", "[PHONE_HIDDEN]", text)
print(cleaned) # Call me at [PHONE_HIDDEN]支持使用分组引用(\1, \2):
import re

text = "John Doe"
swapped = re.sub(r"(\w+) (\w+)", r"\2, \1", text)
print(swapped)  # Doe, John
re.compile():预编译正则(提升性能)
当同一正则表达式需多次使用(例如处理百万行数据)时,应先进行编译以提高效率:
phone_pattern = re.compile(r"1[3-9]\d{9}")

# 后续可直接调用
if phone_pattern.search(text1):
    ...
if phone_pattern.findall(text2):
    ...
综合案例:
给定字符串 log_info = "用户ID:10086,订单号:ORD20260122001,支付金额:99.9元;用户ID:10087,订单号:ORD20260122002,支付金额:199.5元;用户ID:10088,订单号:ORD20260122003,支付金额:0.88元"
1、基础匹配:提取所有的用户 ID 数字(如 10086、10087、10088),并以列表形式输出。
2、捕获组 + 贪婪 / 非贪婪:提取所有的订单号(如 ORD20260122001),要求分别用贪婪匹配和非贪婪匹配实现,并对比两种方式的结果(思考为什么结果一致 / 不一致)。
3、数值提取:提取所有的支付金额数字(仅保留数字部分,如 99.9、199.5、0.88),忽略 “元” 字,最终输出浮点数列表。
实现代码:
import re

log_info = "用户ID:10086,订单号:ORD20260122001,支付金额:99.9元;用户ID:10087,订单号:ORD20260122002,支付金额:199.5元;用户ID:10088,订单号:ORD20260122003,支付金额:0.88元"

pattern1 = re.compile(':(\d+),')
print(pattern1.findall(log_info))

pattern2 = re.compile('ORD\d+')  # 贪婪模式
print(pattern2.findall(log_info))

pattern3 = re.compile('ORD2026012200\d+?')  # 非贪婪模式
print(pattern3.findall(log_info))

pattern4 = re.compile(':(\d+.\d+)元')
print(pattern4.findall(log_info))
结语
记住口诀:
- 提取一个用
search,- 提取多个用
findall,- 替换内容用
sub,- 高频使用要
compile!
总结
到此这篇关于Python数据分析中正则表达式匹配字符串与常用函数的文章就介绍到这了,更多相关Python数据分析正则表达式匹配内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















