



在 Go 开发里,字符串比较几乎天天都会写到:判断是否相等、做排序、做去重,甚至一些业务规则分支都离不开它。问题在于,很多人知道 == 能用,却不一定清楚 Go 比较字符串时到底按什么规则执行、什么时候该换成标准库函数,以及为什么“看起来一样”的两个字符串也可能比较失败。下面就按使用方式、底层规则和常见坑点拆开讲清楚,方便你在写判断逻辑时有明确依据。
Go 字符串有哪些比较方式
先说结论:Go 字符串不但能比较是否相等,还支持比较大小。不同写法适合的场景并不一样。
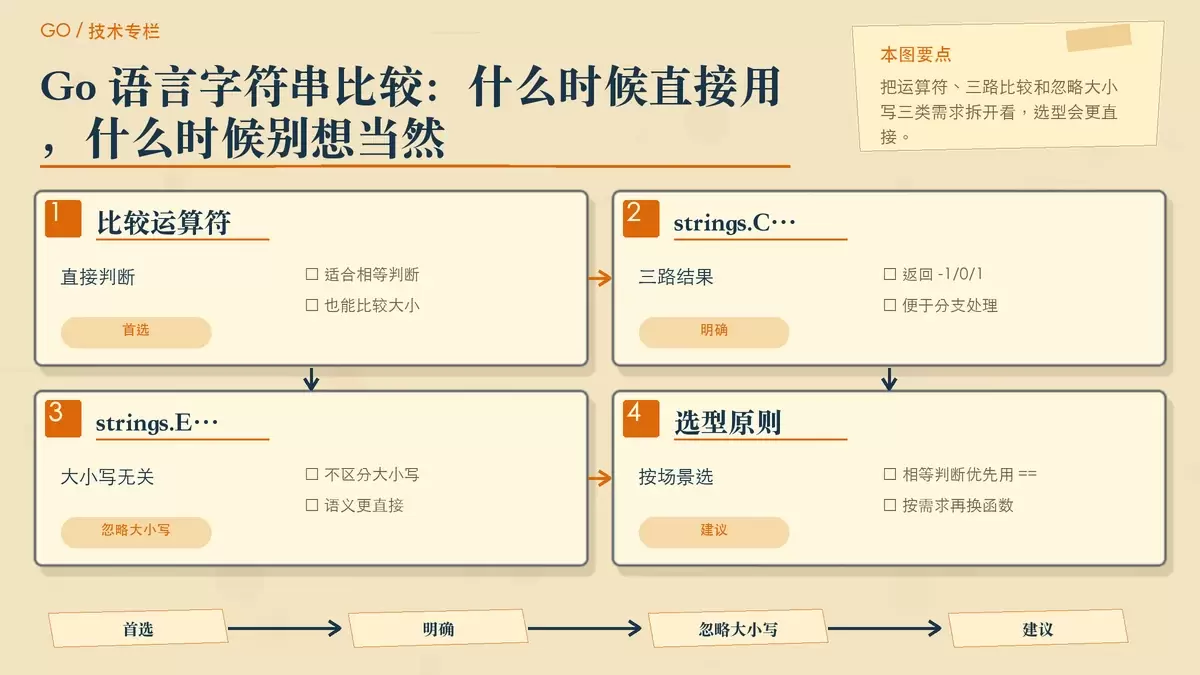
直接用比较运算符
如果你的目标是判断是否相等,或者按字典序判断大小,最直接的方式就是使用比较运算符。Go 支持 ==、!=、<、>、<=、>= 对字符串进行比较。
s1, s2, s3 := "apple", "banana", "apple"

fmt.Println(s1 == s3)  // true
fmt.Println(s1 < s2)   // true,按字典序比较
这类写法最常见,也通常是首选,尤其是简单相等性判断时,可读性和性能都比较好。
需要三路结果时用 strings.Compare()
有些场景不是只想知道“相不相等”,而是需要明确知道左边更小、相等还是更大,这时可以用标准库 strings 包里的 strings.Compare()。
result := strings.Compare("apple", "banana") // -1它的返回值很明确:
- 返回
-1:前者小于后者 - 返回
0:两者相等 - 返回
1:前者大于后者
当你要把比较结果继续传给排序逻辑、规则分支或自定义判断函数时,这种形式会更顺手。
忽略大小写时用 strings.EqualFold()
如果需求是“内容相同即可,不区分大小写”,就不要手动先转成全大写或全小写再比较。Go 已经提供了更合适的做法:
fmt.Println(strings.EqualFold("GoLang", "golang")) // truestrings.EqualFold() 的语义很直接,也比手工做大小写转换更适合作为正式代码里的比较方式。
Go 比较字符串时到底按什么规则
理解规则比记 API 更重要。因为一旦知道 Go 的比较逻辑,你就能判断一段代码为什么会得到那个结果。
本质是按字节做字典序比较
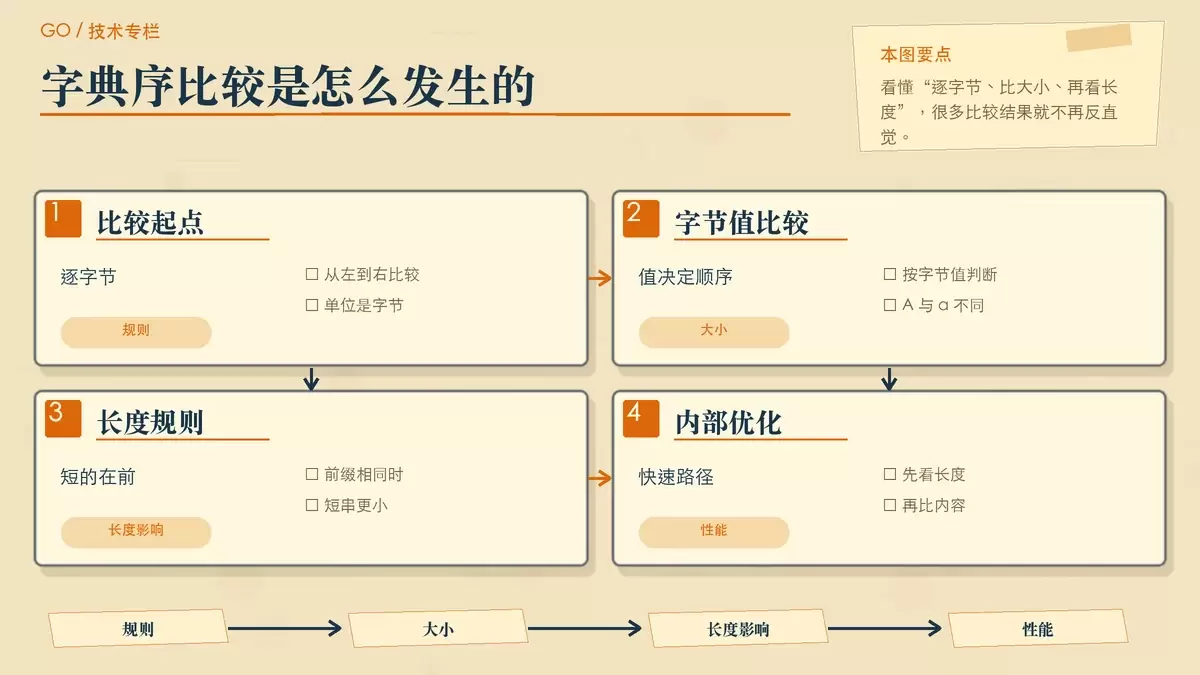
Go 对字符串采用的是字典序比较,核心过程可以概括为三步:
- 从左到右逐字节比较
- 比较当前位置字节值的大小
- 如果前面都相同,则较短的字符串更小
fmt.Println("a" < "b")      // true
fmt.Println("a" < "aa")     // true(长度影响)
fmt.Println("A" < "a")      // true(ASCII: 65 < 97)
这里最容易让人误判的一点,是 Go 比较的不是“看起来像什么字符”,而是底层字节序列。也正因为如此,大小写、长度和编码形式都会直接影响结果。
为什么说它还有性能上的快速路径
字符串比较并不是每次都把所有内容逐个字节扫完。Go 在比较时会先看长度,长度不同的情况下可以更快得到结果;长度相同,再继续逐字节比较内容。这也是为什么简单比较通常足够高效,不需要额外包装一层逻辑。
对日常业务代码来说,这意味着两件事:
- 简单相等性判断优先用
==就够了 - 遇到长字符串或大量比较时,理解“先长度、后内容”的路径有助于判断性能表现
怎么在可读性和性能之间做选择
这部分不复杂,关键是别把问题想得太重。多数场景下,按需求直接选最贴近语义的写法即可。
- 简单相等性判断:优先使用
==运算符 - 需要三路比较结果:使用
strings.Compare() - 忽略大小写:使用
strings.EqualFold()
如果只是在代码里判断两个字符串是否一致,Go 官方推荐的方向也很明确:优先使用 == 运算符。它更快,也更符合大多数读者的阅读习惯。
容易踩的坑,以及它在代码里怎么落地
真正麻烦的地方不在 API,而在那些“表面看起来没问题,结果却不符合预期”的细节。
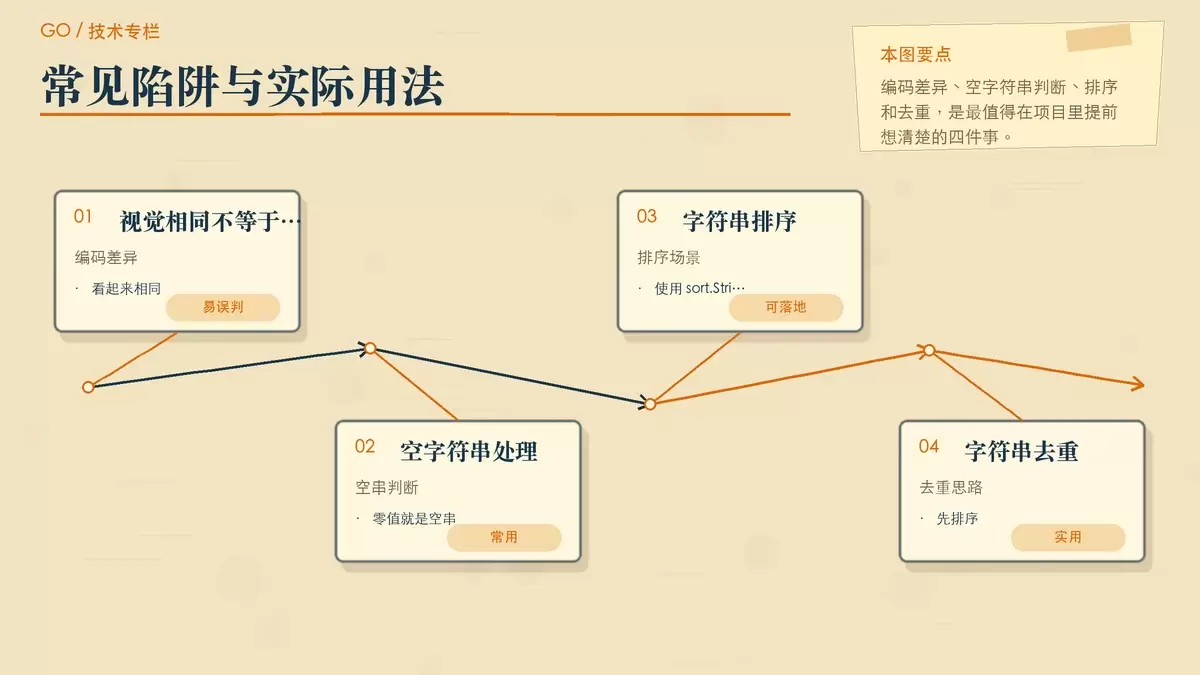
坑一:视觉相同,不代表字节相同
Go 字符串按字节比较,所以两个看起来一样的字符,只要底层编码不同,比较结果就可能是 false。
s1 := "é"      // 两个字节
s2 := "é"     // 三个字节('e' + 组合音标)
fmt.Println(s1 == s2)  // false!
这类问题常出现在外部输入、用户复制粘贴内容、不同系统生成的文本之间。遇到“肉眼看着一样,但判断不相等”的情况,第一反应应该先查编码表示,而不是怀疑比较运算符本身。
坑二:空字符串判断别绕远路
Go 里字符串的零值就是空字符串,所以未赋值字符串变量和字面量 "" 比较时,本身就是成立的。
var s1 string     // 零值,空字符串
s2 := ""
fmt.Println(s1 == s2)      // true
fmt.Println(len(s1) == 0)  // true,推荐方式
如果你的目的是判断“是否为空”,用 len(s1) == 0 会更直接,也更符合代码语义。
场景一:排序
字符串比较最常见的实际用途之一就是排序。Go 标准库已经把这个能力封装好了:
fruits := []string{"banana", "apple", "cherry"}
sort.Strings(fruits)
fmt.Println(fruits)  // [apple banana cherry]
sort.Strings() 背后依赖的就是同样的字符串比较规则,因此排序结果本质上也是按字典序排列。
场景二:去重
另一个很实用的场景,是先排序再去重。只要相同字符串会排到一起,后面逐项比较就很好处理。
func uniqueStrings(strs []string) []string {
    if len(strs) == 0 {
        return strs
    }
    sort.Strings(strs)
    result := []string{strs[0]}
    for i := 1; i < len(strs); i++ {
        if strs[i] != strs[i-1] {
            result = append(result, strs[i])
        }
    }
    return result
}
这段写法的关键不在“技巧多高”,而在于它充分利用了字符串比较和排序规则的一致性:先排好,再比较相邻元素是否相同。
更稳妥的使用建议
把前面的内容收束一下,Go 字符串比较可以按下面这套原则来用:
- 优先使用
==运算符:简单、直观,性能也好 - 需要三路比较时使用
strings.Compare():结果表达更明确 - 忽略大小写时使用
strings.EqualFold():比先转大小写更合适 - 注意字符编码问题:视觉一致不代表底层字节一致
- 理解长度优先的比较路径:有助于判断长字符串比较时的行为和性能
如果只记一句话,那就是:Go 的字符串比较并不神秘,它非常直接,但它比较的是字节序列。只要把这个前提记住,很多看似反常的结果其实都能解释清楚。















