



本地跑通的 Go 服务,上线后最容易被忽略的并不是编译和启动,而是“挂了以后怎么办”。像 nohup ./app &、screen、tmux 这类办法适合临时顶上,但一到生产环境,自动拉起、日志留存、平滑重启和统一管理才是真正影响可用性的部分。下面按常见部署规模来拆开讲,帮助你判断单机、小团队、多服务或微服务场景下分别该用哪一类工具。
为什么不建议把 nohup 当成生产方案
很多 Go 项目第一次上服务器时,最先想到的就是直接后台启动:nohup ./app &。这当然能让程序先跑起来,screen 或 tmux 也能让会话断开后进程继续存活,但这些办法更接近“让程序别跟着终端退出”,而不是“管理一个长期运行的服务”。
核心问题在于:一旦进程异常退出,它们不会自动恢复。也就是说,服务如果在半夜崩掉,除非有人发现并手动重启,否则它就一直处于不可用状态。
而生产环境对进程管理的要求通常至少包括几件事:
- 进程崩溃后能自动重启;
- 能方便查看日志;
- 服务启动、停止、重启有统一入口;
- 最好支持优雅重启或平滑更新;
- 多服务场景下能集中管理。
也正因为如此,真正适合上线使用的,通常还是 Systemd、Supervisor、Docker、PM2、Kubernetes 这一类工具。
单机和跨平台场景:Systemd 与 Supervisor 怎么选
Systemd:Linux 服务器上的原生方案
如果你的部署环境是 Linux,Systemd 通常是最稳妥的首选。它本身就是现代 Linux 发行版的标准初始化系统,服务管理能力直接内建在系统层,启动快、占用低,也足够稳定。
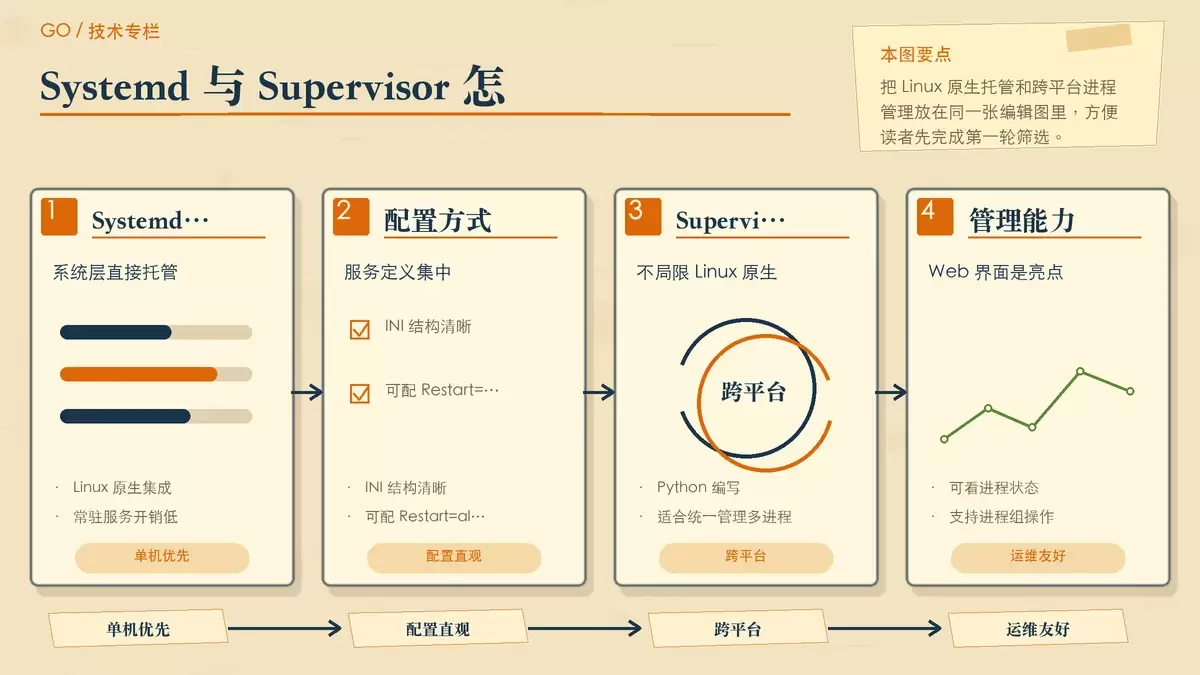
它的配置文件采用 INI 风格,结构清晰,适合把 Go 程序定义成正式服务:
[Unit]
Description=My Go Application
After=network.target

[Service]
Type=simple
ExecStart=/path/to/your/app
Restart=always
# 其他配置:User=app, RestartSec=5等

[Install]
WantedBy=multi-user.target
这段配置的重点很明确:等待网络就绪后启动应用,进程退出后自动重启。对于单个 Go 服务来说,这已经覆盖了最核心的生产需求。
Systemd 的配套命令也很成熟。比如:
systemctl start myapp:启动服务;journalctl -u myapp:查看服务日志。
日志能力也是它的一大优势。很多时候不需要额外再接一层日志守护进程,就能直接排查问题。如果你的项目就是一台或少量 Linux 机器上的常驻服务,Systemd 往往已经够用,而且维护成本最低。
Supervisor:配置灵活,适合跨平台和多进程管理
如果服务器环境不只 Linux,或者你希望用一套相对统一、灵活的配置去管理多个服务,Supervisor 会更合适。它由 Python 编写,跨平台支持更友好,作为通用进程管家也比较成熟。
一个最常见的配置大致如下:
[program:myapp]
command=/path/to/your/app
autostart=true
autorestart=true
# 其他配置:user=app, stdout_logfile等
这里保留了几个最重要的动作:自动启动、异常退出自动重启。对于 Go 服务来说,这样的配置门槛并不高,而且可继续补充运行用户、标准输出日志文件等参数。
Supervisor 比较实用的地方在于两点。第一,它提供 Web 管理界面,可以直接在浏览器里查看进程状态、启动或停止进程、查看日志输出;第二,它支持进程组,多个相关服务可以归为一组统一操作。
所以,如果你面对的是“小规模但不止一个服务”的环境,或者希望运维同学通过图形界面快速处理常见问题,Supervisor 往往比纯命令行方案更顺手。
容器化和多实例部署:Docker 与 PM2 的定位
Docker:把进程管理和部署一致性一起解决
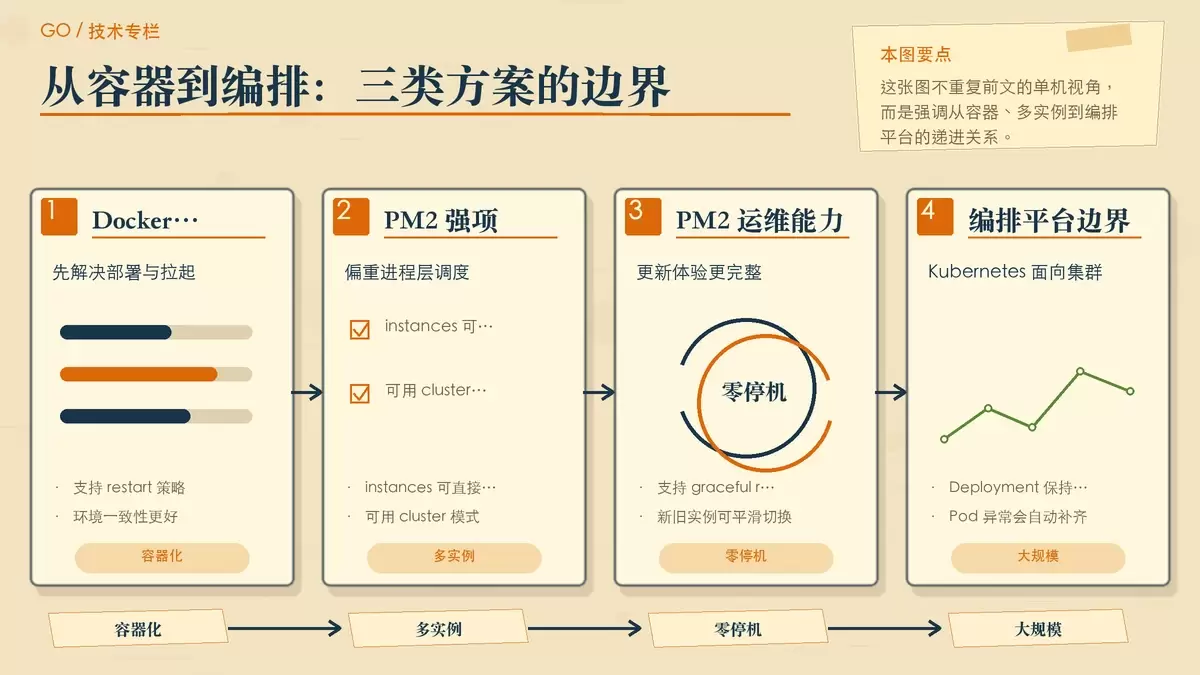
现在不少团队部署 Go 服务时,已经默认走容器化路线。Docker 的价值不只是“打包环境”,它也顺带解决了进程生命周期管理的问题。
最直接的办法就是使用 restart 策略。例如:
docker run -d --restart=always -p 8080:8080 --name myapp myapp:latest加上 --restart=always 之后,容器异常退出时会自动拉起。对于已经把 Go 程序做成镜像的项目,这比再单独引入一套宿主机进程管理工具要自然得多。
如果项目里不止一个组件,Docker Compose 会进一步简化管理:
version: '3'
services:
  myapp:
    image: myapp:latest
    restart: always
    # 其他配置:ports, environment等
这样做的好处是,服务定义、端口、环境变量和重启策略都集中在同一份配置里,启动和维护都更一致。除了自动重启,容器方案还有一个很现实的收益:资源隔离。每个容器拥有独立的文件系统、网络栈和进程空间,服务之间互不干扰,排障边界也更清楚。
PM2:功能丰富,适合需要多实例和平滑重载的场景
PM2 常被看作 Node.js 生态的工具,但它并不只服务于 Node.js。只要是可执行文件,包括 Go 编译产物,也可以交给 PM2 管理。
它的一个典型配置如下:
module.exports = {
  apps: [{
    name: 'myapp',
    script: '/path/to/your/app',
    instances: 2,
    exec_mode: 'cluster',
    // 其他配置:max_memory_restart, autorestart等
  }]
}
这段配置里最有辨识度的是 instances: 2 和 exec_mode: 'cluster':它会拉起两个实例,并以集群模式运行。对需要快速做多实例部署的团队来说,这一点很有吸引力。
PM2 的长处还在“开箱即用”的运维体验上。运行 pm2 monit,就能直接看到 CPU、内存等运行状态;需要做零停机部署时,graceful reload 也很实用,它会先拉起新实例,等新实例就绪后再停掉旧实例。
如果你的重点是多实例管理、简单监控和较低门槛的平滑重载,PM2 是一个偏“全能型”的选择。不过它毕竟不是围绕 Go 和 Linux 原生体系设计出来的,因此在纯 Linux 单机场景里,很多团队还是更倾向先选 Systemd 或容器方案。
服务规模再上去,Kubernetes 才值得引入
当系统进入微服务阶段,服务数量增长到几十、上百,甚至更多时,单纯靠宿主机上的进程管理工具就开始吃力了。这个时候,Kubernetes 解决的已经不只是“进程崩了自动拉起”,而是整个容器集群的编排问题。
在 Kubernetes 中,常见做法是定义一个 Deployment,例如:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: myapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: myapp
  template:
    metadata:
      labels:
        app: myapp
    spec:
      containers:
      - name: myapp
        image: myapp:latest
        # 其他配置:ports, resources等
这里的关键信息是 replicas: 3。也就是说,系统会始终保持 3 个副本运行。如果某个 Pod 崩溃了,Kubernetes 会自动创建新的 Pod 来补齐副本数。
相比前面的工具,Kubernetes 提供的是一整套更完整的运行时能力,包括服务发现、负载均衡、配置管理等。这种方案非常适合微服务体系,尤其是在服务数量多、发布频繁、需要标准化交付的团队中。
但它的问题也很明确:学习曲线陡,运维成本高。如果你的 Go 服务还停留在少量实例或几台机器的规模,引入 Kubernetes 往往会把问题复杂化,属于典型的过度设计。
怎么按项目规模做判断
把这些工具放到同一张表里比较,真正有用的不是“谁功能最多”,而是“谁和当前阶段最匹配”。可以按下面几个场景来判断:
单机部署
优先考虑 Systemd。它是 Linux 原生能力,稳定、轻量、学习成本低,适合大多数单服务或少量服务的线上环境。
需要管理多个服务
可以看 Supervisor 或 PM2。两者都适合统一管理多个进程,也都提供更友好的可视化或运维能力。若更重视跨平台和分组管理,Supervisor 会更稳;若更需要多实例、监控和平滑 reload,PM2 更有优势。
已经采用容器化部署
直接用 Docker + Docker Compose 往往是最顺的路径。既然服务已经跑在容器里,重启策略、配置集中化和环境一致性就一起解决了,没有必要再人为拆成两套体系。
微服务和大规模编排
服务数量一多,Kubernetes 才真正体现价值。它适合解决副本调度、服务治理和集群级运维问题,但前提是你的团队也准备好了接受它带来的复杂度。
最后别忽略监控告警
无论最终选的是哪一种方案,都要记住一件事:进程活着,不代表服务一定正常。进程管理工具能做的是保证“程序还在跑”,但它不能替你确认接口是否超时、依赖是否异常、业务是否已经不可用。
所以,真正可靠的上线方案通常是两层:一层用进程管理工具负责拉起和托管,另一层用监控告警去确认服务本身是否健康。只有这样,Go 服务的可用性才算真正落到实处。















