


15行Python代码实现网易云音乐热门歌单抓取教程

本文介绍如何使用Python的Selenium模块配合Chrome浏览器,通过15行核心代码抓取网易云音乐播放量超过1000万的热门歌单。教程涵盖环境配置、ChromeDriver下载与路径设置,以及利用开发者工具分析DOM结构实现自动翻页和数据保存的完整流程。
引言与环境配置
0. 引言
随着314情人节临近,或许你需要一首歌曲来安抚内心。本文将演示如何用15行代码获取热门歌单,助你轻松上手。
本方案采用Selenium模块,这是一款自动化测试工具,可驱动浏览器执行点击、下拉等操作。对于JavaScript动态渲染的页面,该方式抓取效果显著。运行环境为Chrome浏览器配合Selenium。
接下来直接进入详细步骤。
1. 环境
操作系统:Windows
Python版本:3.7.2
准备工作与工具安装
2. 准备工作
a. 若环境中未安装selenium模块,可通过pip直接安装。
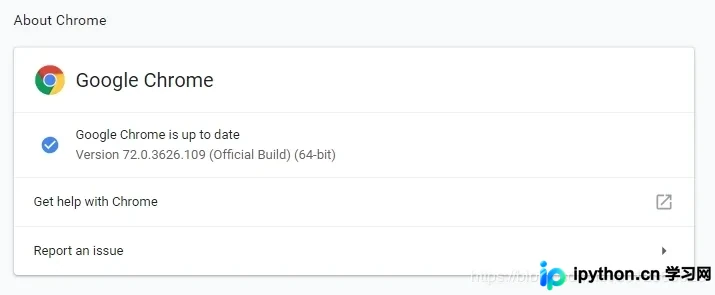
pip install seleniumb. 启动谷歌浏览器,在地址栏输入 chrome://settings/help 并回车,查看当前Chrome版本号。
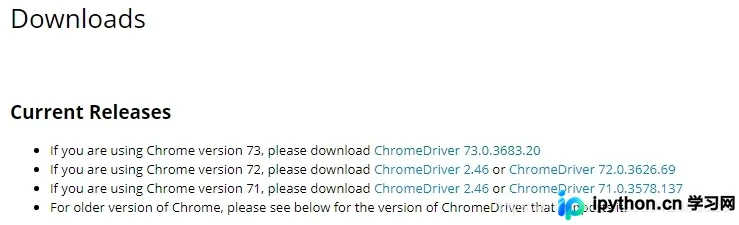
c. 访问ChromeDriver官方网站: https://sites.google.com/a/ch... 查找与当前浏览器版本匹配的ChromeDriver进行下载。
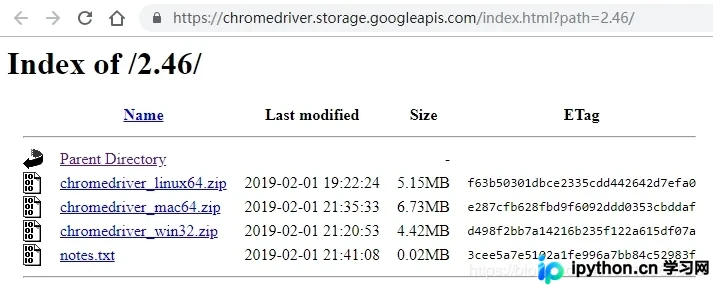
d. 根据操作系统类型选择对应版本下载。
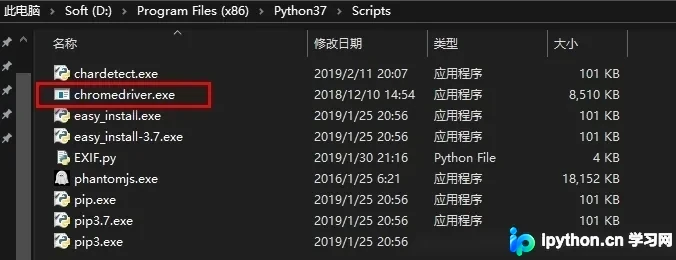
e. 以Windows系统为例,下载完成后,将ChromeDriver文件放置于Python安装目录下的Scripts文件夹中。
准备工作就绪,开始编写代码。
热门歌单抓取实现
3. 迷你爬虫的实现
本次目标是爬取网易云音乐中播放量超过1000万的热门歌单,包括歌单名称及链接。
a. 首先访问网易云歌单首页: https://music.163.com/#/disco...
b. 使用Chrome开发者工具(<F12>)进行页面结构分析。
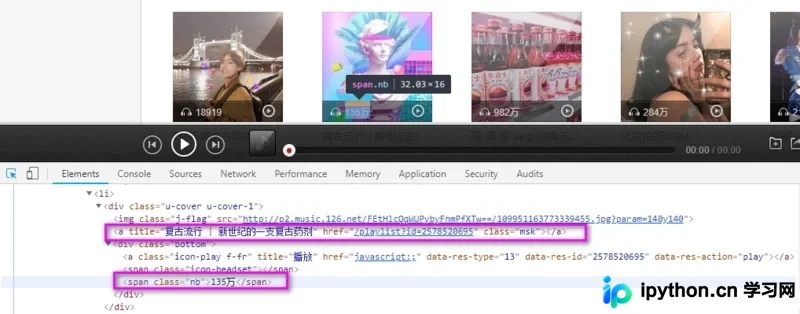
所需信息均包含在以下元素中:
- msk,封面[mask]:包含歌单名称及链接
- nb,播放数[number broadcast]:例如135万
c. 需遍历所有页面,继续分析以找到“下一页”的URL地址。
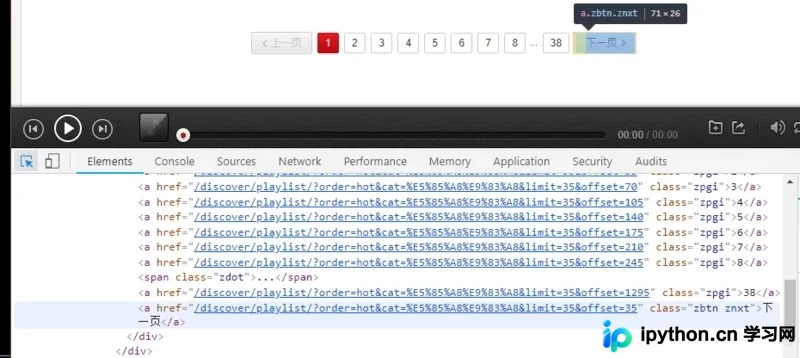
d. 切换至最后一页,获取该页URL。
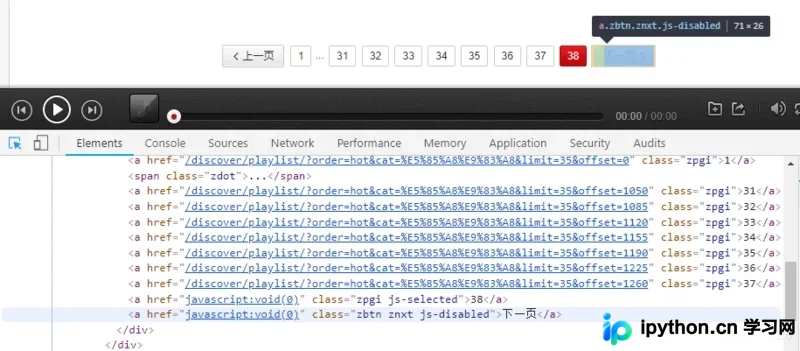
e. 爬取完所有符合条件的歌单信息后,将其保存至本地文件。
f. 全部工作完成后,通过以下伪代码回顾整体逻辑。
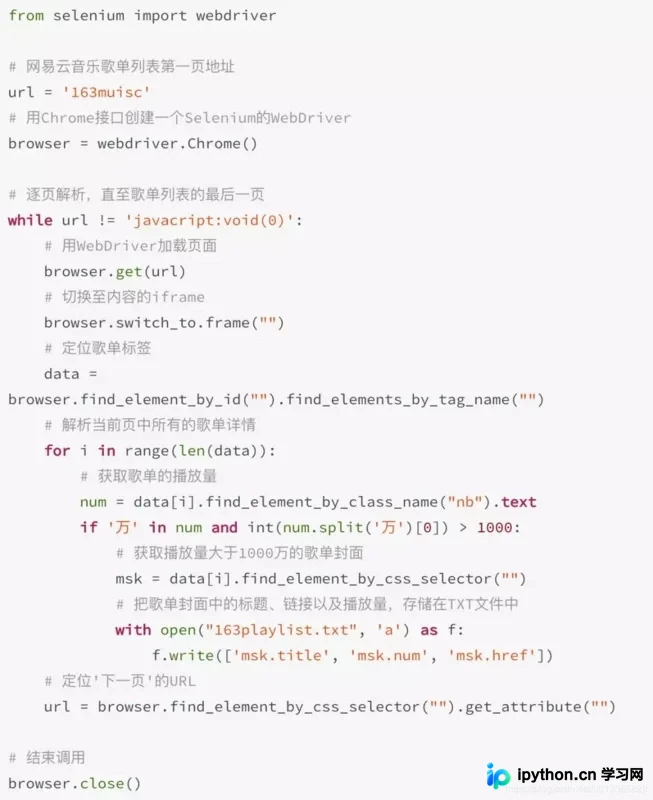
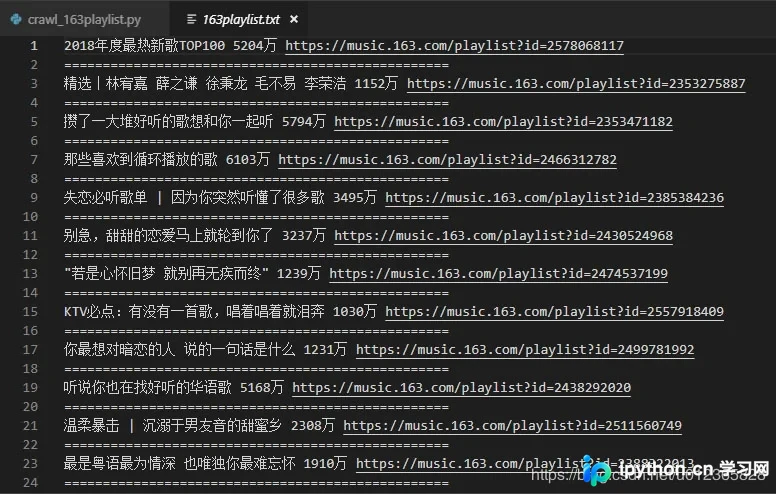
g. 爬取效果展示如下:
总结
4. 总结
本文旨在通过情人节场景引入爬虫概念,展示Python的强大功能。
以上就是本文的全部内容,希望能为您的学习或工作提供参考,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















