


Python实现抖音热搜定时爬取功能

本文详细介绍如何使用Python爬取抖音热搜榜数据。通过对比requests和selenium两种方法,演示如何获取排名、热度、标题及链接,并利用lxml解析数据保存至Excel。最后结合Windows任务计划程序实现每小时自动运行,打造高效的热榜监控工具。
大家好,我是丁小杰。
此前曾分享过利用Python定时抓取微博热搜的示例,这堪称一款极佳的摸鱼工具。若觉得单一热榜信息量不足,今天我们将目光转向抖音热搜榜的抓取,感兴趣的朋友不妨动手实践。
抖音热搜榜
访问链接:https://tophub.today/n/K7GdaMgdQy
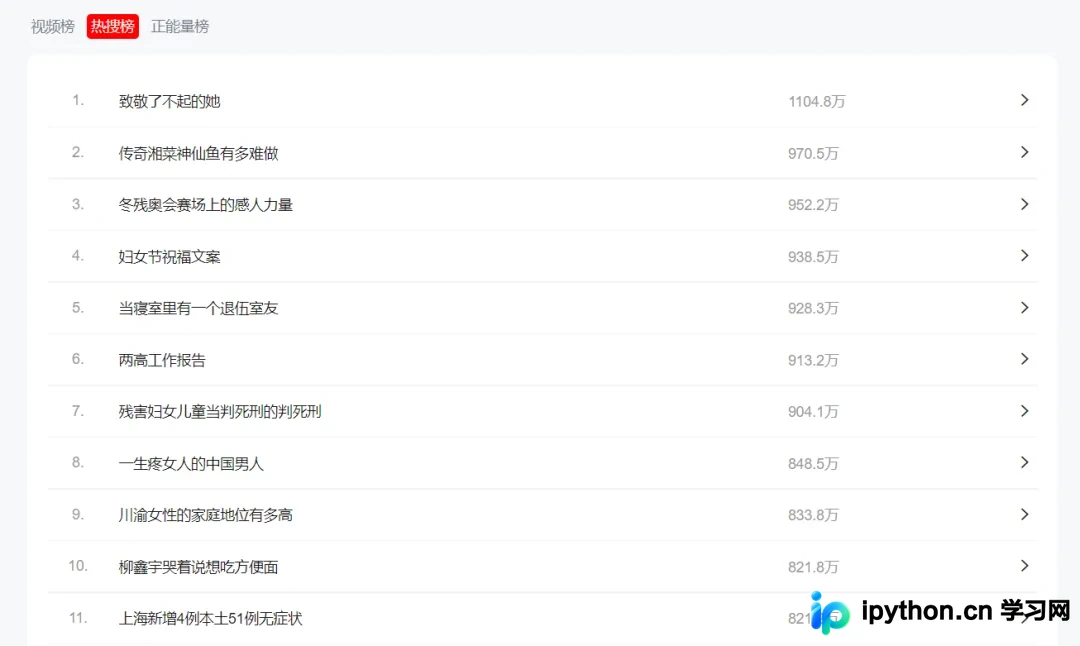
该热榜共计50条数据,本次抓取重点包括:排名、热度值、标题以及对应链接。
requests 爬取
使用requests是一种极为简便的方式。鉴于该页面未设置反爬机制,直接通过get方法请求页面即可获取内容。
import requests
import pandas as pd

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/94.0.4606.54 Safari/537.36'
}
url = 'https://tophub.today/n/K7GdaMgdQy'
page_text = requests.get(url=url, headers=headers).text
page_text
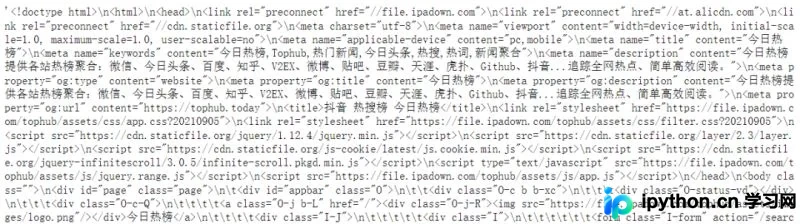
由此可见,仅需寥寥数行代码,便能轻松获取所需数据。
selenium 爬取
将selenium配置为无头浏览器模式,打开指定的url以获取页面数据。
from selenium import webdriver

option = webdriver.ChromeOptions()
option.add_argument('--headless')

driver = webdriver.Chrome(options=option)

url = 'https://tophub.today/n/K7GdaMgdQy'
driver.get(url)

page_text = driver.page_source
两种抓取方式均可成功获取数据,但requests方案相对更为简洁,且整体代码运行速度更快。若页面数据非动态加载,采用requests方式则更为便捷。
数据解析
接下来,利用lxml库对抓取到的数据进行解析,并将结果保存至excel文件中。
tree = etree.HTML(page_text)

tr_list = tree.xpath(
    '//*[@id="page"]/div[2]/div[2]/div[1]/div[2]/div/div[1]/table/tbody/tr')

df = pd.DataFrame(columns=['排名', '热度', '标题', '链接'])
for index, tr in enumerate(tr_list):
    hot = tr.xpath('./td[3]/text()')[0]
    title = tr.xpath('./td[2]/a/text()')[0]
    article_url = tr.xpath('./td[2]/a/@href')[0]
    df = df.append({
        '排名': index + 1,
        '热度': hot,
        '标题': title,
        '链接': article_url}, ignore_index=True)
df['链接'] = 'https://tophub.today' + df['链接']
df
运行结果
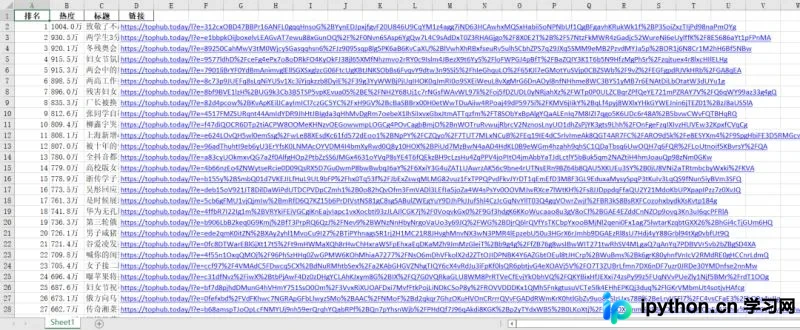
设置定时运行
至此,抓取代码部分已完成。若希望实现代码每小时自动执行,可借助任务计划程序进行配置。
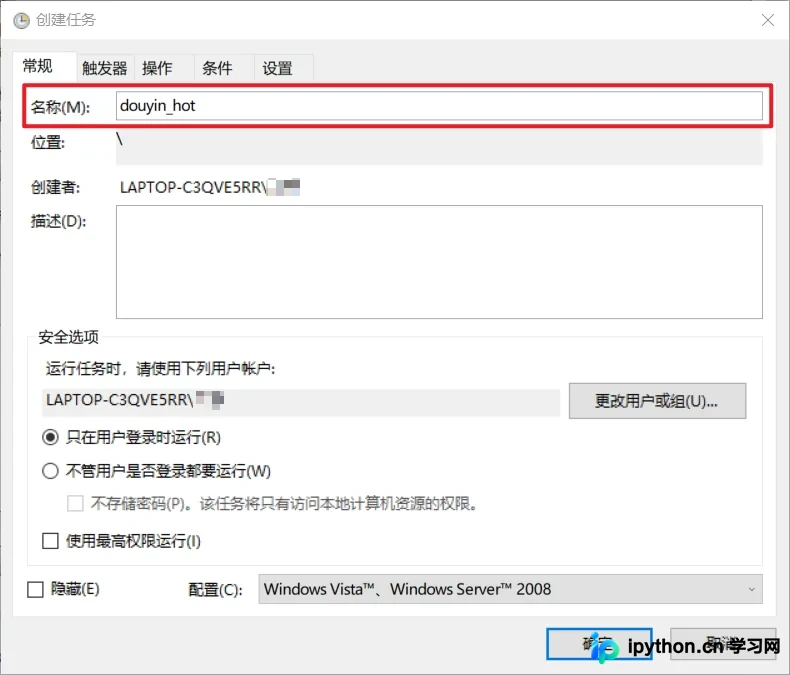
打开任务计划程序,点击【创建任务】。
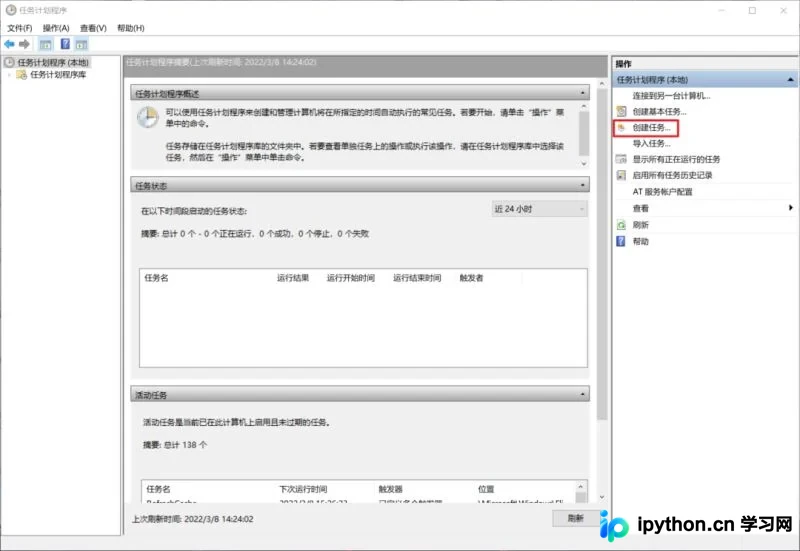
输入任务名称,名称可随意设定。
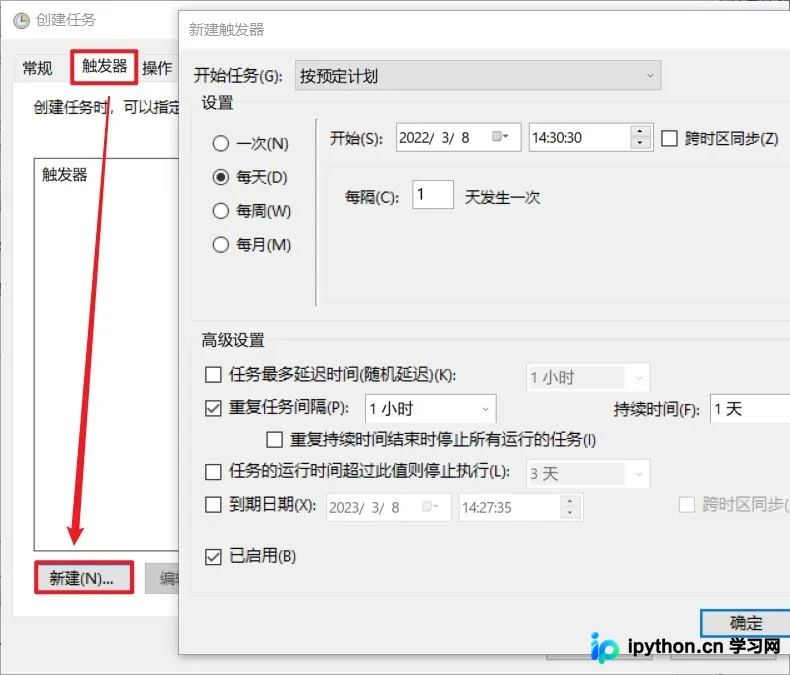
选择【触发器】选项卡,点击【新建】,随后【设置触发时间】。
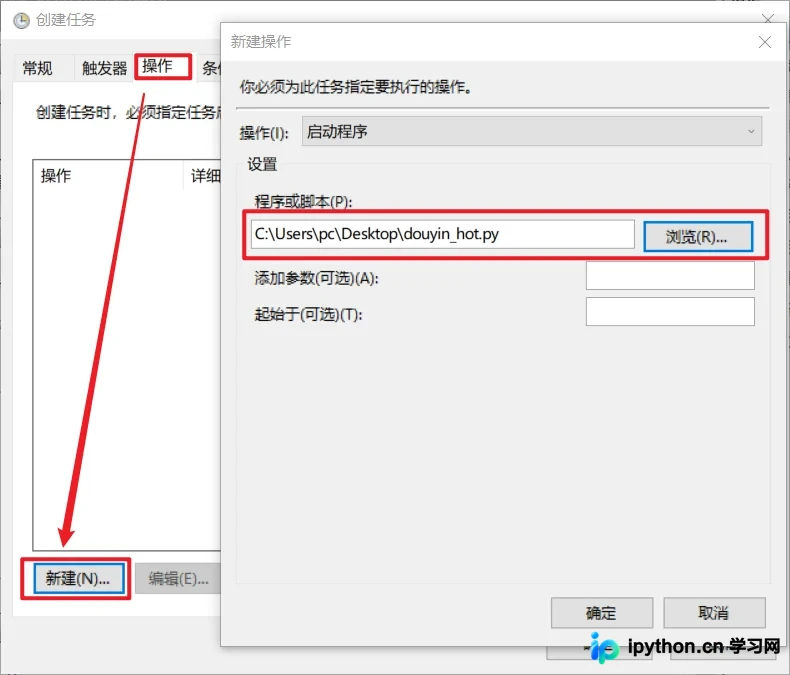
选择【操作】选项卡,点击【新建】,然后【选择程序或脚本】。
最后确认设置即可。到达设定时间后任务将自动运行,也可通过右键点击任务手动执行。
以上就是本次分享的全部内容,整体难度适中,希望能对大家有所帮助。文中代码拼接后即可直接运行!
以上就是Python实现抖音热搜定时爬取功能的详细内容,更多关于Python抖音热搜爬取的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















