


Python实现基于MD5的文件监听与过滤程序

本文介绍如何使用Python编写一个基于MD5算法的文件监听程序。通过计算文件哈希值并存储于字典中,实现对指定文件夹内文件增加、修改和删除操作的实时监控。程序支持通过配置文件(TOML格式)灵活设置监听路径,并支持按文件名包含或排除特定字符进行过滤,利用多线程技术同时监控多个目录。
Python实现基于MD5的文件监听与过滤程序
前言
本文编写了一个基于MD5算法的文件监听程序。该程序利用不同文件生成不同的哈希值,以此判断文件夹中文件的增加、修改、删除操作,并支持过滤包含特定字符的文件名。
需求说明
需求说明
主要需求是对指定文件夹下的文件增加、修改和删除进行监控,并在发生上述操作时发出提示。此外,程序需支持过滤掉文件名中包含特定字符的文件,或仅监听文件名中含有特定字符的文件。
实现思路简述
思路简述
首先,针对文件的增加、修改和删除反馈,可以利用MD5等加密算法。因为文件内容或文件名的任何修改都会导致生成的哈希值与之前不同,所以可以利用字典(dict)存储文件名与对应哈希值的映射关系。其中,文件增加对应新增一个键值对,文件删除对应移除一个键值对,而文件修改则可理解为先删除旧文件再增加新文件的过程。
MD5算法可直接利用Python第三方库hashlib实现。
MD5算法实现
 m = hashlib.md5()
 myFile = open(full_path, 'rb')
 for line in myFile.readlines(): #以行为单位不断更新哈希值,避免文件过大导致一次产生大量开销
  m.update(line) #最后可以得到整个文件的哈希值
文件名过滤逻辑
其次,关于过滤文件名中特定字符以及仅监听包含特定字符文件的功能,实现相对简单。只需使用列表分别存储需要过滤和必须存在的字符串,然后通过标志位和字符串子串包含性判断即可。只有满足条件的文件才会生成哈希值,进而被纳入监听范围。
判断字符串是否包含子串最常用的方法是in运算符和string模块中的find方法,具体实现可参考下方代码。
多线程监控机制
第三,由于需要同时监控多个文件夹,必须利用线程处理。这里创建一个线程池来存储线程,利用threading库实现一个线程类来处理具体的线程操作。
class myListener(threading.Thread):
thread1 = myListener(mydir, json_list_include, json_list_exclude) #生成线程配置文件说明
补充说明
需要额外说明的是,在传输需要监听的文件夹、必须包含的字段以及过滤字段时,本文采用配置文件的形式存储。具体来说,是利用TOML格式的数据进行传输。相比JSON格式,TOML格式具有更强的用户可读性,为了便于博客展示,因此选择了TOML格式。
首先利用代码生成了一个TOML格式的文件,后续使用时,程序打包后可以直接修改配置文件来控制程序行为。
TOML配置文件生成
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# Author: JYRoooy
import collections
import json
import toml
if __name__ == '__main__':
 myOrderDict = collections.OrderedDict
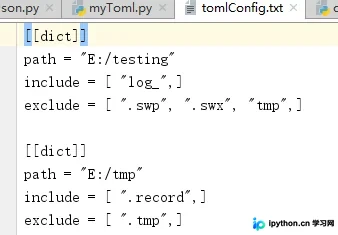
 myOrderDict = {'dict':[{'path':'E:/testing', 'include':['log_'], 'exclude': ['.swp', '.swx', 'tmp']},{'path':'E:/tmp', 'include':['.record'], 'exclude': ['.tmp']}]}
 myToml = toml.dump(myOrderDict, open('E:/python/code/PythonProject/tomlConfig.txt','w+'))
TOML文件示例
格式说明:一个字典(dict)对应一个监听文件夹及需要过滤(exclude)和包含(include)的字段。这里的字段仅指文件名部分。例如,监控E:/testing目录下的文件,要求文件名包含log_字段,且不包含.swp、.swx、.tmp字段的文件;同时监控E:/tmp目录下的文件,要求文件名包含.record字段,且不包含.tmp文件。
完整代码实现
代码实现
以下是完整程序的代码,具体解释可参见代码注释。
核心监听类代码
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# Author: JYRoooy
import toml
import hashlib
import os
import sys
import time
import importlib
import threading
importlib.reload(sys)

class myListener(threading.Thread):
 '''
 监听类
 '''
 def __init__(self, input_dir, filt_in, filt_ex): #文件夹路径,必须包含的字符,必须过滤的字符
 threading.Thread.__init__(self)
 self.input_dir = input_dir
 self.filt_in = filt_in
 self.filt_ex = filt_ex
 self.dict = {} #用来存储文件名和对应的哈希值
 self.file_list = [] #存储每一次扫描时的文件的文件名
 self.pop_list = [] #存储需要删除的文件名

 def run(self):
 while (1): #保证文件夹一直处于被监听的状态
  for cur_dir, dirs, files in os.walk(self.input_dir):
  if files != []:
   self.file_list = []
   for each_file_1 in files:
   each_file = each_file_1
   if self.filt_in: #判断文件名中是否有必须存在的字段
    flagone = 0
    for i in range(len(self.filt_in)):
    if self.filt_in[i] in each_file:
     flagone += 1
    if flagone == 0:
    continue

   if self.filt_ex: #判断文件名中是否有必须过滤掉的字段
    flagtwo = 0
    for i in range(len(self.filt_ex)):
    if self.filt_ex[i] in each_file:
     flagtwo = 1
    if flagtwo==1:
    continue

   self.file_list.append(each_file)
   full_path = os.path.join(cur_dir, each_file)
   m = hashlib.md5() #实例化md5算法

   myFile = open(full_path, 'rb')

   for line in myFile.readlines():
    m.update(line)
   if each_file not in self.dict.keys(): #如果当前的dict中没有这个文件,那么就添加进去
    self.dict[each_file] = m.hexdigest() #生成哈希值
    print('文件夹:' +cur_dir+ "中的文件名为:" + each_file + "的文件为新文件" + time.strftime('%Y-%m-%d %H:%M:%S',
           time.localtime(time.time())))
   if each_file in self.dict.keys() and self.dict[each_file] != m.hexdigest(): #如果当前dict中有这个文件,但是哈希值不同,说明文件被修改过,则需要对字典进行更新
    print('文件夹:' +cur_dir+ "中的文件名为:" + each_file + "的文件被修改于" + time.strftime('%Y-%m-%d %H:%M:%S',
           time.localtime(time.time())))
    self.dict[each_file] = m.hexdigest()
   myFile.close()
  pop_list = []
  for i in self.dict.keys():
   if i not in self.file_list: #当字典中有不在当前文件名列表中时,说明文件已经被删除
   print('文件夹:' +cur_dir+ '中的文件名为:' + i + "的文件已被删除!!!" + time.strftime('%Y-%m-%d %H:%M:%S',
          time.localtime(time.time())))
   pop_list.append(i)
  for i in pop_list:
   self.dict.pop(i)

  time.sleep(2)

if __name__ == '__main__':
 threads = [] #用来存储线程的线程池
 with open('E:/python/code/PythonProject/tomlConfig.txt','r+') as f: #读取toml格式的文件,并分解格式
 mytoml = toml.load(f)
 myList = mytoml['dict']
 for i in range(len(myList)): #因为可能同时需要监听多个文件夹,所以利用线程池处理多线程
  json_list_include = []
  json_list_exclude = []
  mydir = myList[i]['path']
  for sublist in range(len(myList[i]['include'])):
  json_list_include.append(myList[i]['include'][sublist])
  for sublist in range(len(myList[i]['exclude'])):
  json_list_exclude.append(myList[i]['exclude'][sublist])
  thread1 = myListener(mydir, json_list_include, json_list_exclude) #生成线程
  threads.append(thread1)

 for t in threads: #开启所有线程
  t.start();
运行结果验证
运行结果展示
两个监控文件夹中的初始文件列表
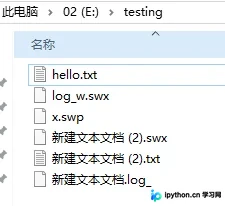
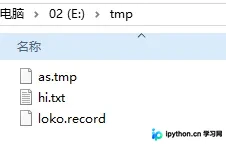
第一次运行程序,可以看到程序已按照预设的过滤规则完成了过滤和监听初始化。
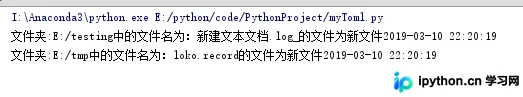
将loko.record文件重命名为loko.re,再次查看运行结果。
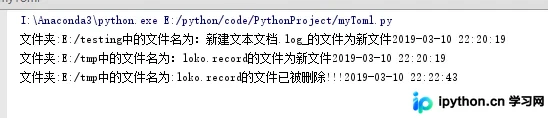
可以看到监听程序已做出响应。由于loko.re文件不符合预设的监听规则(原文件需包含.record),因此程序不对其直接监听。正如前文所述,文件修改相当于一个删除操作和一个新建操作,所以监听程序提示原文件被删除。
总结与资源
总结与展望
其他效果此处不再一一展示。
该程序并未实现过于复杂的功能,完整代码已上传至GitHub:https://github.com/JYRoy/MyFileListener(提供本地下载链接)。
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















