



Go 的错误处理一直在朝着更易读、更少样板代码的方向演进。`errors.Is` 和 `errors.As` 解决了包装错误难判断的问题,但在日常代码里,开发者仍然经常写出“先声明变量、再调用 `errors.As`”的固定模板。到了 Go 1.26,标准库新增 `errors.AsType`,正是针对这类重复动作下手。
它看起来只是一个小改动,实际影响却很直接:类型提取可以写进 `if` 初始化语句里,错误分支更紧凑,变量作用域也更准确。下面就按使用方式、底层行为和落地注意事项拆开来看,判断这个新 API 什么时候值得用、该怎么用才不出错。
从 errors.As 到 errors.AsType:写法到底变了什么
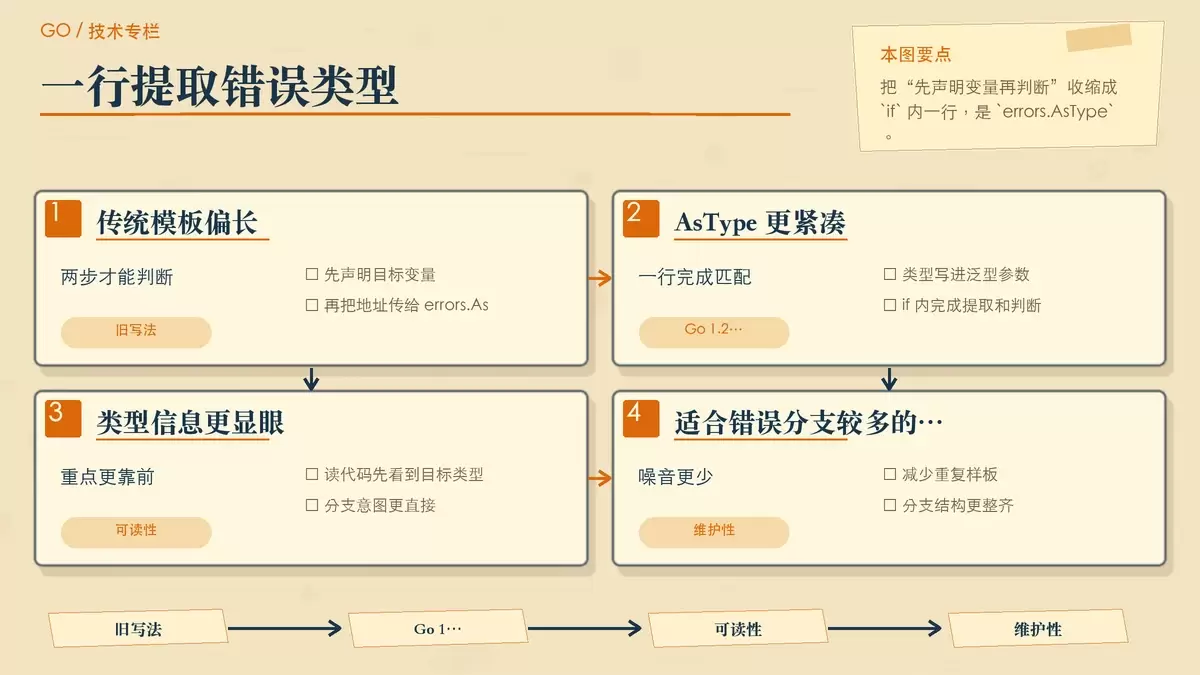
旧写法的问题不在功能,而在样板代码
在 Go 1.13 到 Go 1.25 之间,处理包装错误时最常见的写法是下面这样:
// 传统方式:需要预先声明变量
var pathErr *os.PathError
if errors.As(err, &pathErr) {
    fmt.Println("错误路径:", pathErr.Path)
    fmt.Println("错误操作:", pathErr.Op)
}
这套写法本身没有问题,`errors.As` 依旧是 Go 错误处理体系里的核心工具。但它有一个长期存在的使用成本:目标变量必须先声明,再把地址传进去。当项目里这类分支很多时,可读性会被这段固定模板持续稀释。
Go 1.26 把类型提取压缩进一行
Go 1.26 引入 `errors.AsType` 后,同样的逻辑可以收紧为:
// Go 1.26+:一行搞定
if pathErr, ok := errors.AsType[*os.PathError](err); ok {
    fmt.Println("错误路径:", pathErr.Path)
}
这里最明显的变化有两个:一是不用再提前声明 `pathErr`;二是类型信息直接写在泛型参数里,读代码时能立刻知道这段分支要匹配哪类错误。对于经常写文件、网络、数据库错误分支的代码,这种收缩会很快体现在整体观感上。
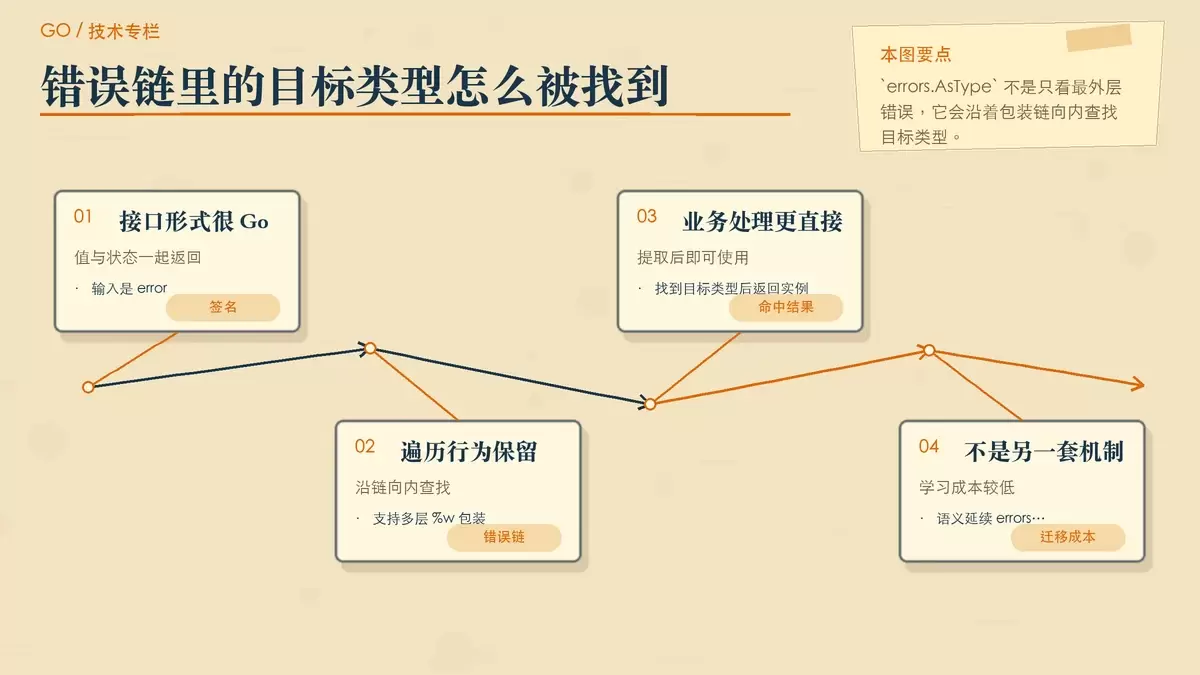
它不是语法糖:errors.AsType 仍然会遍历错误链
函数签名说明了它的设计重点
`errors.AsType` 的核心形式可以概括为:
func AsType[Target any](err error) (Target, bool)它接收一个 `error`,返回两部分结果:一个目标类型 `Target` 的值,以及一个表示是否匹配成功的 `bool`。这种接口形式和 Go 常见的“值 + 是否成功”习惯一致,因此用在 `if` 初始化语句里会非常自然。
多层包装下,提取行为和 errors.As 保持一致
它的意义并不只是少写一个 `var`。更重要的是,`errors.AsType` 继承了 `errors.As` 的核心能力,也就是沿着整个错误链查找目标类型。哪怕错误已经被多层 `%w` 包装,依然可以向内提取:
// 多层包装的错误
err1 := &MyError{Code: 500}
err2 := fmt.Errorf("中间层:%w", err1)
err3 := fmt.Errorf("最外层:%w", err2)

// AsType 仍然能提取到 MyError
if myErr, ok := errors.AsType[*MyError](err3); ok {
    fmt.Println("错误码:", myErr.Code) // 输出:500
}
这意味着你不需要把它理解成另一套新机制。更准确的判断是:它在保留原有错误链语义的前提下,把调用方式换成了更适合泛型时代的形态。
对日常开发最直接的三个好处
1. 同样逻辑,代码更短
对比最能说明问题:
// ❌ 传统方式:3 行代码
var dbErr *DatabaseError
if errors.As(err, &dbErr) {
    handleDBError(dbErr)
}

// ✅ AsType 方式:1 行代码
if dbErr, ok := errors.AsType[*DatabaseError](err); ok {
    handleDBError(dbErr)
}
单个分支只少了两行,看起来不算夸张,但在大型服务里,错误分类逻辑往往散落在 handler、service、repository 等多个层面。样板代码一多,阅读成本就会被持续放大,而 `errors.AsType` 恰好能把这部分噪音压下去。
2. 变量作用域更准确,减少误用空间
传统写法里,目标变量往往定义在 `if` 外层,即使判断失败,变量名仍然留在当前作用域内:
// 传统方式:变量作用域过大
var httpErr *HTTPError
if errors.As(err, &httpErr) {
    // 使用 httpErr
}
// httpErr 在这里仍然可见,可能造成误用

// AsType 方式:变量作用域精确控制
if httpErr, ok := errors.AsType[*HTTPError](err); ok {
    // 使用 httpErr
}
// httpErr 在这里已超出作用域,更安全
这不是形式上的洁癖,而是和维护性直接相关。变量只在命中分支里可见,后续代码就不会误把它当成一个已经成功提取的错误对象来使用。
3. 多类型分支判断更顺畅
当一个入口需要识别多种业务错误时,`errors.AsType` 的优势会更明显。每个分支都可以独立完成“提取 + 判断”,代码节奏更统一:
func handleError(err error) string {
    // 优雅的类型判断链
    if validationErr, ok := errors.AsType[*ValidationError](err); ok {
        return "验证错误:" + validationErr.Field
    }

    if authErr, ok := errors.AsType[*AuthError](err); ok {
        return "认证错误:" + authErr.Message
    }

    if netErr, ok := errors.AsType[*net.OpError](err); ok {
        return "网络错误:" + netErr.Op
    }

    return "未知错误:" + err.Error()
}
这种写法特别适合 API 层、网关层或命令行工具入口。每种错误都在本地完成解析,不需要在外面堆一串预声明变量,结构会清楚很多。
实践时最容易出错的地方:类型参数必须匹配实际存储类型
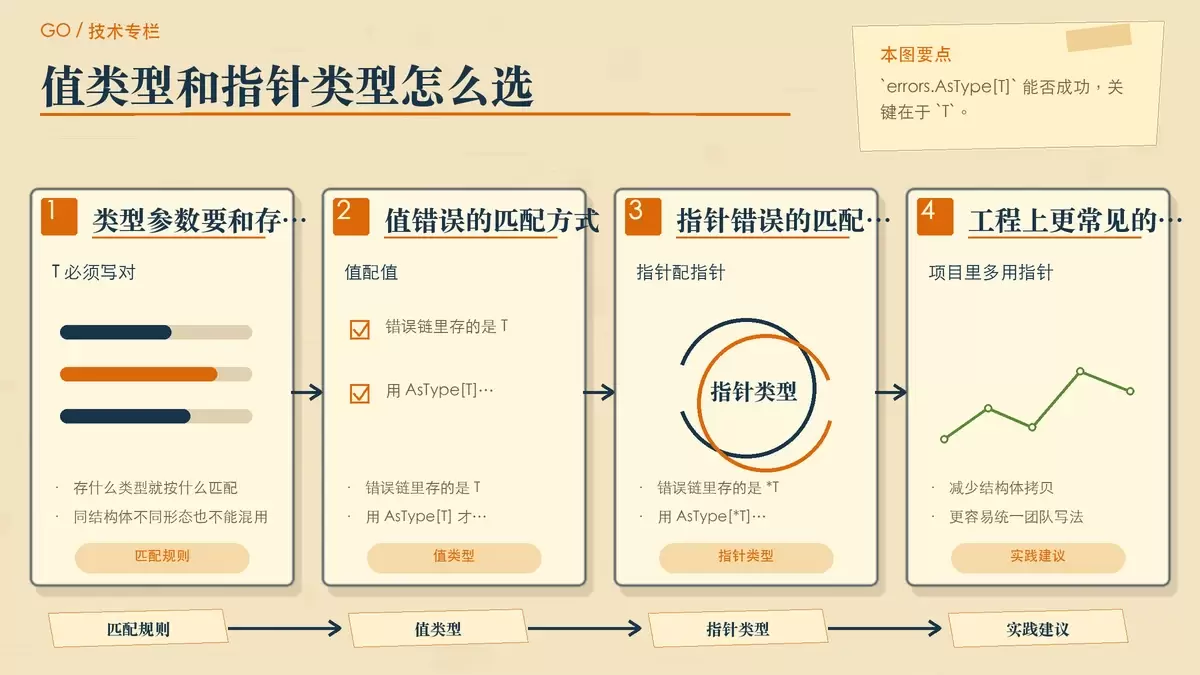
真正需要注意的,不是 `errors.AsType` 能不能用,而是泛型参数 `T` 该怎么填。它要求你传入的类型参数,必须和错误链里实际存储的类型一致。
// 值类型存储 → 用值类型匹配
valErr := MyError{Message: "值错误"}
err1 := fmt.Errorf("包装:%w", valErr)

if e, ok := errors.AsType[MyError](err1); ok {  // ✅ 成功
    fmt.Println(e.Message)
}

// 指针类型存储 → 用指针类型匹配
ptrErr := &MyError{Message: "指针错误"}
err2 := fmt.Errorf("包装:%w", ptrErr)

if e, ok := errors.AsType[*MyError](err2); ok {  // ✅ 成功
    fmt.Println(e.Message)
}核心原则可以直接记成一句话:`errors.AsType[T]` 里的 `T`,必须和错误链中的真实存储类型一致。
- 存储的是
T→ 用errors.AsType[T] - 存储的是
*T→ 用errors.AsType[*T]
如果这里写错,即使错误值本身来自同一个结构体,也不会匹配成功。这一点和很多人第一次接触 `errors.As` 时遇到的问题类似,只是到了 `AsType` 这里,类型选择直接写进了泛型参数里,更需要有意识地区分值类型和指针类型。
为什么实际项目里通常仍建议优先用指针错误
虽然值类型和指针类型都能工作,但从工程实践看,错误对象大多更适合以指针形式出现,常见原因包括:
- 避免结构体拷贝,性能更稳定
- 更容易和指针接收者的方法保持一致
- 需要时可以修改错误对象内部状态
因此在团队代码规范里,如果已经默认使用指针错误类型,那么迁移到 `errors.AsType` 时也应继续保持同样约定,不要在新旧写法混用过程中把类型风格弄乱。
这项更新值不值得跟进
`errors.AsType` 不会改变 Go 错误处理的基本模型,它解决的是另一类更实际的问题:样板代码偏多、作用域偏松、多分支判断不够利落。对于已经大量使用 `errors.As` 的项目来说,学习成本几乎可以忽略,因为底层语义没有变,变化主要集中在调用方式和可读性上。
如果你的代码库准备跟进 Go 1.26,这个新函数很适合优先落在错误分支密集的模块里,例如接口层、文件处理逻辑、网络调用封装和数据库访问封装。它不是颠覆式特性,但属于那种会在日常维护中不断回本的小改进。















