


Python操作MySQL数据库的两种方式实例分析【pymysql和pandas】

本文详细介绍Python操作MySQL数据库的两种常用方式。首先通过pymysql模块建立连接,详解connect参数及游标操作,实现基础增删改查;其次利用pandas库的read_sql和to_sql函数,结合SQLAlchemy引擎,将数据直接读写为DataFrame格式,便于后续数据处理与分析。
Python操作MySQL数据库概述
本文通过具体实例,解析Python连接MySQL数据库的两种主流实现方案,供开发者参考。
使用pymysql模块连接数据库
第一种方案:使用pymysql模块
具体实现代码如下:
import pymysql
#打开数据库连接
db=pymysql.connect(host='1.1.1.1',port=3306,user='root',passwd='123123',db='test',charset='utf8')
cursor=db.cursor()#使用cursor()方法获取操作游标
sql = "select * from test0811"
cursor.execute(sql)
info = cursor.fetchall()
db.commit()
cursor.close() #关闭游标
db.close()#关闭数据库连接
执行上述代码后,数据表test0811的原始内容与程序读取结果分别如下:
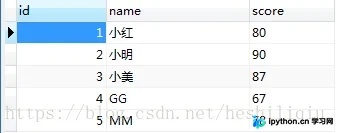
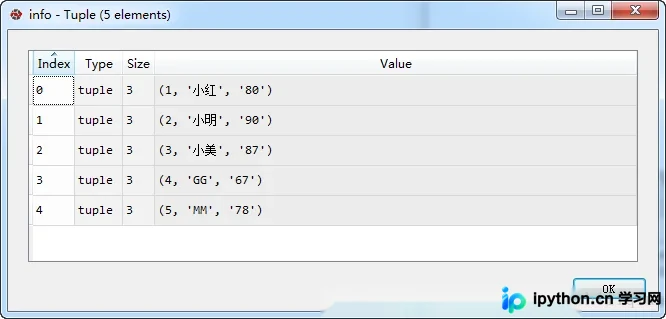
pymysql是Python中用于操作MySQL数据库的第三方模块。使用前需先引入该模块。
pymysql连接参数详解
import pymysql
通过pymysql的connect()方法建立数据库连接,该方法的参数含义如下:
- host:指定MySQL服务器地址。若数据库位于本地,可使用localhost或127.0.0.1;若位于远程服务器,则需填写对应IP地址。
- port:指定服务端口号,默认值为3306。若未显式指定,则使用默认值。
- user:登录数据库所使用的用户名。
- passwd:对应user账户的登录密码。
- db:指定需要操作的数据库名称。
- charset:设置为utf8编码,确保存入的汉字不会出现乱码。
注意:除port=3306可不加引号外,其他参数的值均需使用引号包裹。
代码中的db变量构成了Python与MySQL通信的桥梁。db.cursor()用于获取连接游标对象,通过该游标可执行SQL语句。此外,常用方法还包括:commit()用于提交数据库修改,rollback()用于回滚(取消当前操作),close()用于关闭连接。
上述内容介绍了连接对象db的相关方法,游标对象的方法同样关键,利用游标方法即可对数据库执行具体操作。游标对象的常用方法如下表所示:
游标对象常用方法
| 名称 | 描述 |
|---|---|
| close() | 关闭游标,之后游标不可用 |
| execute(query[,args]) | 执行一条SQL语句,可以带参数 |
| executemany(query,pseq) | 对序列pseq中的每个参数执行SQL语句 |
| fetchone() | 返回一条查询结果 |
| fetchall() | 返回所有查询结果 |
| fetchmany([size]) | 返回size条查询结果 |
| nextset() | 移动到下一条结果 |
| scroll(value,mode='relative') | 移动游标到指定行,如果mode='relative',则表示从当前行移动value条,如果mode=‘absolute',则表示从结果集的第一行移动value条 |
至此,pymysql的基本用法已阐述清晰。剩余的数据库操作(增删改查)主要依赖SQL语句。尽管SQL功能强大,但在某些场景下可能略显局限,结合Python的灵活性与SQL的强大能力可实现更多功能,而pymysql在此过程中主要充当工具与桥梁角色。从代码运行结果(第二幅图)可见,读取的数据存储在二维元组中,例如((1, '小红', '80'),(2, '小明', '90'),(3, '小美', '87'),(4, 'GG', '67'),(5, 'MM', '78'))。由于元组不可变,仅支持读取,数据处理稍显不便。因此,第二种方法将数据读取并存储于DataFrame中,以方便后续处理。
使用pandas库进行数据读写
第二种方案:使用pandas库
具体实现代码如下:
pandas.read_sql函数用法
import pandas as pd
from sqlalchemy import create_engine
from sqlalchemy.types import CHAR,INT
connect_info = 'mysql+pymysql://username:passwd@host:3306/dbname?charset=utf8'
engine = create_engine(connect_info) #use sqlalchemy to build link-engine
sql = "SELECT * FROM test0811" #SQL query
df = pd.read_sql(sql=sql, con=engine) #read data to DataFrame 'df'
#write df to table 'test1'
df.to_sql(name = 'test1',
      con = engine,
      if_exists = 'append',
      index = False,
      dtype = {'id': INT(),
          'name': CHAR(length=2),
          'score': CHAR(length=2)
          }
      )
pandas的DataFrame数据结构包含行索引和列索引,使用DataFrame存储数据库表数据十分便捷。通过pandas中的read_sql和to_sql函数,可实现从MySQL数据库读写数据。两个函数的具体介绍如下。
pandas.read_sql函数
代码示例如下:
pandas.read_sql(sql, con, index_col=None, coerce_float=True, params=None, parse_dates=None, columns=None, chunksize=None)
pandas.read_sql的官方文档提供了详细的参数英文说明(建议直接阅读英文文档,虚心向官方资料学习),参考资料链接为http://pandas.pydata.org/pandas-docs/stable/generated/pandas.read_sql.html
常用参数包括sql(SQL命令或表名)和con(数据库连接引擎,可通过SQLAlchemy或pymysql建立)。从数据库读取数据的基本用法只需提供sql和con即可。其余参数均为默认值,仅在特殊需求时使用,有兴趣者可查阅文档。
代码中的con是通过SQLAlchemy构建的数据库连接引擎,即sqlalchemy.create_engine()。该函数基于URL生成引擎对象,URL通常包含数据库相关信息,典型格式为:
SQLAlchemy引擎构建
dialect+driver://username:password@host:port/database
dialect表示数据库类型,如sqlite、mysql、postgresql、oracle、mssql等;driver是用于连接数据库的DBAPI名称,此处使用pymysql(Python 3.x环境,Python 2.x环境中通常使用mysqldb)。若未指定此项,系统将使用默认DBAPI。
除了使用SQLAlchemy创建engine外,还可以直接使用DBAPI创建engine,代码如下:
直接使用DBAPI创建引擎
con = pymysql.connect(host=localhost, user=username, password=password, database=dbname, charset='utf8')
df = pd.read_sql(sql, con)
pandas.DataFrame.to_sql函数用法
pandas.DataFrame.to_sql函数
代码示例如下:
DataFrame.to_sql(name, con, schema=None, if_exists='fail', index=True, index_label=None, chunksize=None, dtype=None)
主要参数介绍如下,详细文档请参考http://pandas.pydata.org/pandas-docs/stable/generated/pandas.DataFrame.to_sql.html
- name:输出的目标表名。
- con:连接数据库的引擎对象。
- if_exists:包含三种模式{“fail”,“replace”,"append"},默认值为"fail"。fail:若表已存在,引发ValueError错误;replace:若表已存在,覆盖原表数据;append:若表已存在,将数据追加至原表数据之后。
- index:是否将DataFrame的index单独写入一列,默认值为“True”。
- index_label:当index为True时,指定哪一列作为DataFrame的index输出。
- dtype:指定列的数据类型,以字典形式存储{column_name: sql_dtype}。常见数据类型为sqlalchemy.types.INT()和sqlalchemy.types.CHAR(length=x)。注意:INT和CHAR需大写,INT()无需指定长度。
参考资料:
//www.jb51.net/article/157984.htm
http://pandas.pydata.org/pandas-docs/stable/generated/pandas.read_sql.html
http://docs.sqlalchemy.org/en/latest/core/engines.html
http://pandas.pydata.org/pandas-docs/stable/generated/pandas.DataFrame.to_sql.html
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python常见数据库操作技巧汇总》、《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















