



在 Go 1.18 之前,开发者经常会遇到一个别扭的问题:明明只是想复制字符串或字节切片,却只能靠类型转换、copy 或 strings.Builder 之类的绕路写法来表达。代码能跑,但读起来不够直接,遇到子串、切片截取和并发传递时,还容易把共享底层内存的问题埋进实现细节里。
Go 1.18 引入 strings.Clone 和 bytes.Clone 之后,这件事终于有了标准答案。下面就按“过去为什么麻烦、Clone 具体解决了什么、哪些场景该用”这条线梳理一遍,帮助你判断它们是语法层面的便利,还是值得主动采用的代码习惯。
Clone 出现前,复制意图为什么总写得不够直接
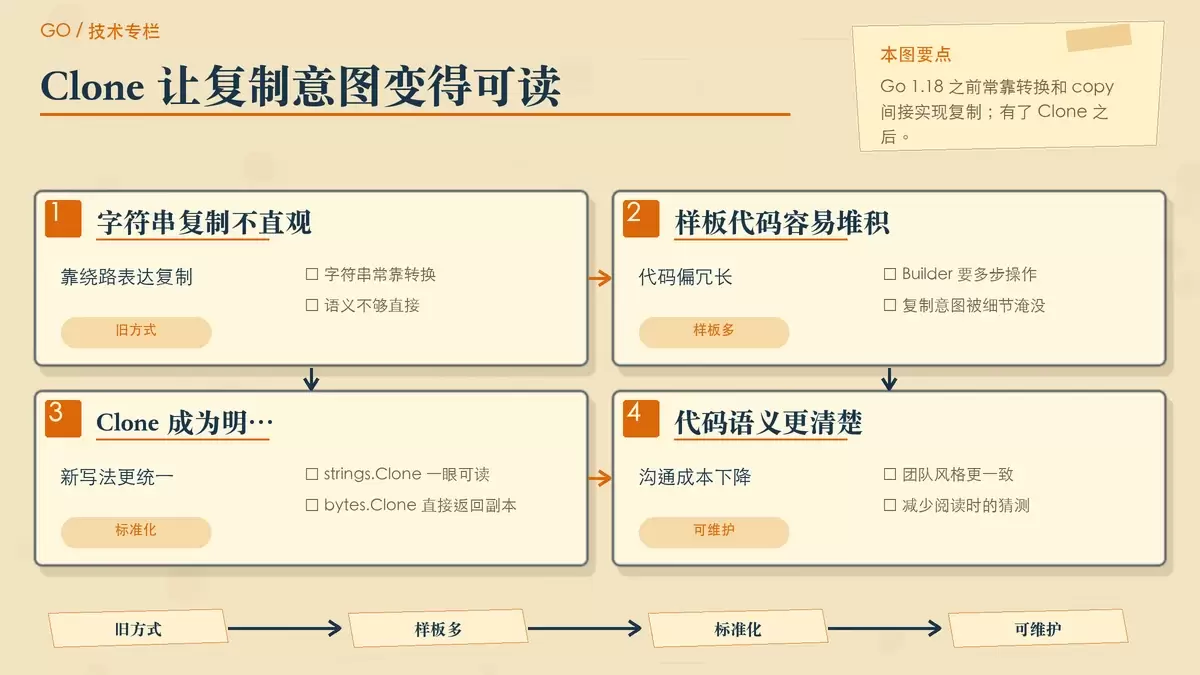
在 Go 1.18 之前,标准库没有提供专门的字符串复制函数。开发者如果想拿到一个独立副本,只能借助其他写法间接完成。
字符串复制常见的变通写法
最常见的一种方式,是先转成字节切片再转回字符串:
func copyString(s string) string {
    return string([]byte(s))
}
这段代码确实能得到新的字符串副本,但问题在于,它表达的是“类型转换”,而不是“我要复制字符串”。阅读者通常需要多想一步,才能确认作者是在主动断开底层共享关系。
如果再追求一些看起来更“正规”的实现,有些代码会借助 strings.Builder:
func copyString(s string) string {
    b := &strings.Builder{}
    b.Grow(len(s))
    b.WriteString(s)
    return b.String()
}
这种写法的问题不是不能用,而是过于啰嗦。为了完成一次复制,要额外组织分配、写入和返回流程,业务意图反而被样板代码淹没了。
字节切片复制也依赖手写模板
字节切片的情况稍好一些,因为 Go 本身有 copy,但仍然没有一个“一眼就知道是在克隆”的标准表达。通常只能写成:
func copyBytes(b []byte) []byte {
    result := make([]byte, len(b))
    copy(result, b)
    return result
}
这类代码很常见,但也很机械:先 make,再 copy,最后返回。只要项目里类似逻辑多起来,重复样板就会迅速堆积。
真正麻烦的不是代码长,而是共享底层内存的隐患
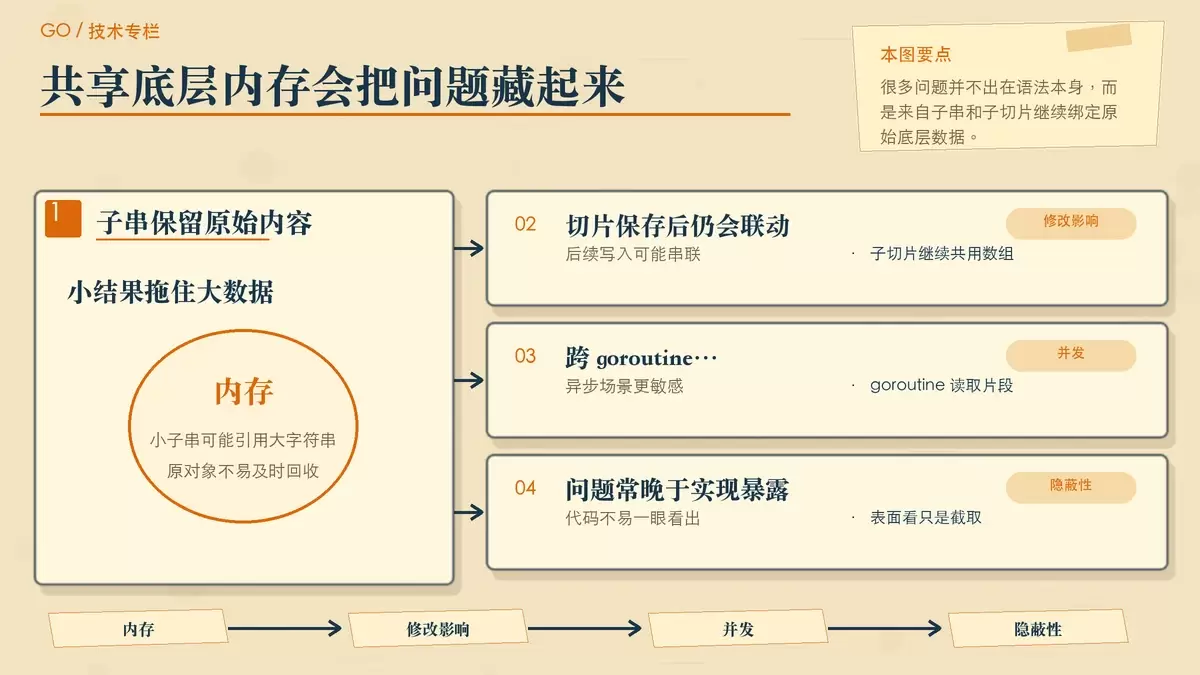
复制写法不统一只是表面问题,更实际的麻烦在于:Go 的字符串和切片都可能与原始数据共享底层存储。只要你取的是子串、子切片,而不是明确拷贝出的新值,就可能把原本应该短生命周期的数据一起拖住,或者让后续修改产生意料之外的影响。
子串可能把大对象一并留在内存里
当你从一个很大的字符串里提取一小段内容时,表面上看只返回了少量文本,实际上它可能仍然引用着原始大字符串的底层数据:
func extractLine(logs string, lineNum int) string {
    lines := strings.Split(logs, "n")
    return lines[lineNum-1]  // 与原始日志共享底层数据
}
如果 logs 很大,而你只想长期保存其中一行,那么这种共享关系就可能让整块原始日志迟迟不能被回收。
切片截取后保存,后续修改可能互相影响
切片更容易碰到这个问题。下面的代码只截取了 buf 中的一段数据,但 data 仍然和原切片共用底层数组:
func processBuffer(buf []byte) {
    data := buf[100:200]
    globalData = data  // 与 buf 共享底层数组
}
这意味着,只要后面继续复用或修改 buf,globalData 的内容也可能随之变化。对调用方而言,这种影响往往并不直观。
并发传递时还可能放大数据竞争风险
在 goroutine 间传递切片片段时,共享底层内存的问题会更敏感:
func handleRequest(data []byte) {
    requestID := data[:16]
    go func() {
        process(requestID)  // 可能与 data 共享内存
    }()
}
如果外层代码随后复用了 data,或者其他逻辑继续修改这块缓冲区,异步处理中的 requestID 就可能读到变化后的内容,严重时还会演变成数据竞争。
Go 1.18 的 Clone,补上了“显式复制”的标准写法
Go 1.18 引入的 strings.Clone 和 bytes.Clone,解决的核心问题并不复杂:当你需要一个独立副本时,终于可以用标准库直接表达出来。
strings.Clone:把“复制字符串”写成一眼可读的代码
strings.Clone 的签名非常简单:
func Clone(s string) string它最重要的价值,不只是少写几行代码,而是语义足够明确:这里就是在创建一个完全独立的字符串副本。
以上面的日志提取场景为例,改写后会清楚很多:
func extractLine(logs string, lineNum int) string {
    lines := strings.Split(logs, "n")
    // 明确表达复制意图,释放原始日志内存
    return strings.Clone(lines[lineNum-1])
}
现在,阅读者不用再猜测一次转换是不是为了复制,代码本身已经把意图说清楚了。同时,如果原始 logs 很大,而返回值需要被单独保留,strings.Clone 也能帮助尽早断开对原数据的引用。
bytes.Clone:让切片副本既简洁又安全
bytes.Clone 对字节切片的作用是同一类问题的标准答案:返回一个拥有全新底层数组的副本。
func processBuffer(buf []byte) {
    // 创建独立副本
    data := bytes.Clone(buf[100:200])
    globalData = data
    // buf 可以被安全复用
}
相比手写 make 加 copy,它的优势仍然是两点:第一,短;第二,更重要的是,明确。调用 bytes.Clone 时,任何读代码的人都知道,这里是在主动切断共享关系。
它改善的不只是写法,还有代码沟通成本
很多语言特性的价值,不在于让程序“从不能运行变成能运行”,而在于让原本分散、隐晦、风格不一的写法收敛成统一表达。Clone 就属于这种改进。
过去你可能需要从 string([]byte(s))、strings.Builder、make + copy 这些写法里猜作者意图;现在看到 strings.Clone 或 bytes.Clone,基本不需要额外解释。对团队代码来说,这种一致性本身就是可维护性的提升。
哪些场景该主动使用 Clone,哪些场景可以不用
Clone 并不是“凡是字符串和切片都要复制”的新规范。它依然会带来一次额外分配,所以关键不在于滥用,而在于把它放在真正需要独立副本的地方。
适合使用 Clone 的情况
如果你遇到下面这些场景,通常就值得优先考虑 strings.Clone 或 bytes.Clone:
从大字符串或大切片中截取出一小部分,并且这小部分要保留更久;跨 goroutine 传递可能被后续修改的数据;返回某个局部变量派生出的子串或子切片,但又不希望调用方继续绑定到底层原始存储。
这些情况下,虽然会有轻微的内存分配开销,但因为能够更早释放原内存、减少共享状态、降低 GC 压力,整体效果往往更稳,也更符合长期运行服务的需求。
可以不使用 Clone 的情况
相对地,如果数据只是临时使用、生命周期很短、尺寸也很小,或者你非常确定原始数据本来就会长期存在,那么是否克隆就需要按场景权衡。
比如函数里临时切一段数据立即返回给下游继续处理,且整个链路都很短;又或者在极度敏感的性能热点中,已经确认不存在泄漏和共享风险,这时直接使用原切片或原子串也可以接受。
换句话说,Clone 不是默认动作,而是一种明确声明:“这里比起省下一次分配,我更需要独立性和可预测性。”
从技巧性写法到标准表达,这是 Go 风格的一次小升级
strings.Clone 和 bytes.Clone 也许不算 Go 1.18 中最显眼的功能,但它们很好地体现了 Go 一贯的设计取向:把常见需求收敛成简单、直接、可读的标准工具。
从过去那些略显绕弯的复制写法,到现在一句 Clone 就能说明意图,变化看似不大,实际影响的是代码表达方式。对日常工程开发来说,这类小而准的改进,往往比炫目的新特性更能持续提升代码质量。















