


Python Selenium 自动化抓取网易云音乐歌单名称实战

发布时间:2026-10-13 |
3人浏览过
本文详解如何使用 Python 和 Selenium 库自动化抓取网易云音乐公开歌单列表。重点讲解如何定位 iframe 框架、处理页面延迟加载以及通过判断按钮状态实现自动翻页,最终完整获取多页歌单名称数据。
Selenium 抓取网易云音乐歌单流程
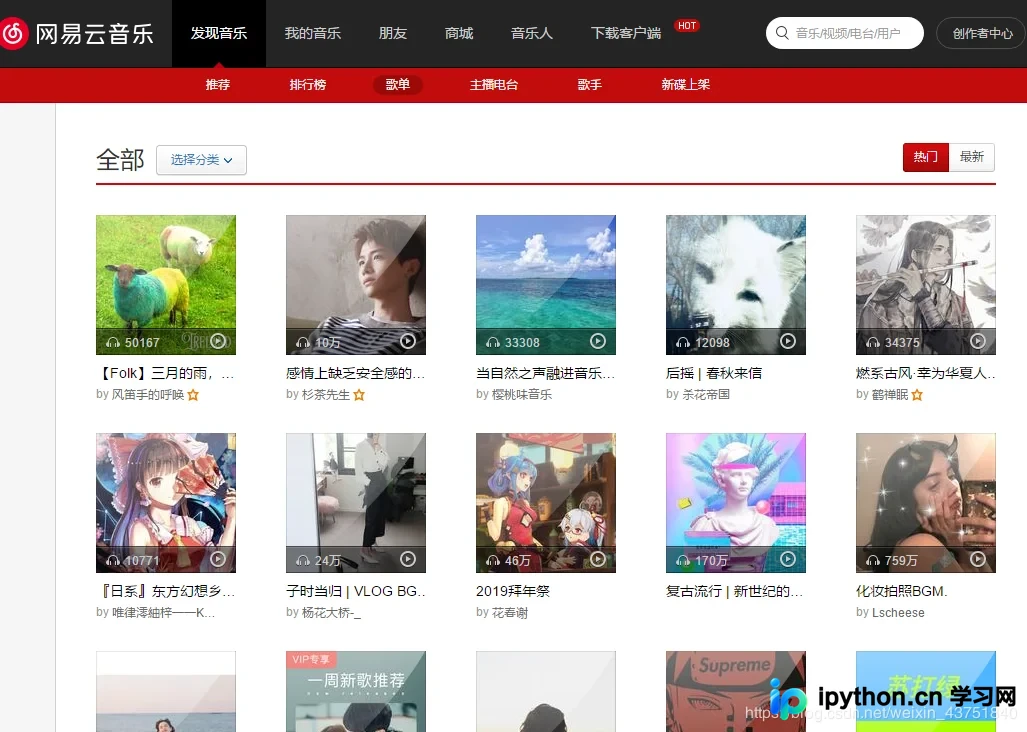
本次操作的目标网站为网易云音乐发现页。
核心代码与 iframe 处理
第一步是获取初始页面的数据,关键在于必须先将浏览器上下文切换到对应的 iframe 框架内,否则无法定位内部元素。
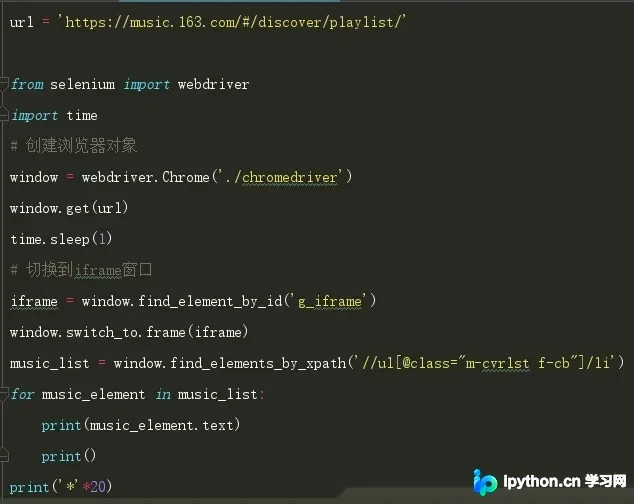
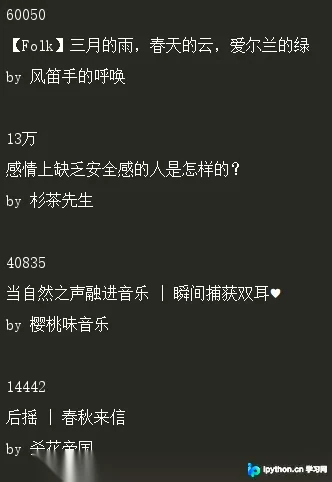
执行打印语句以验证当前获取到的歌单列表内容。
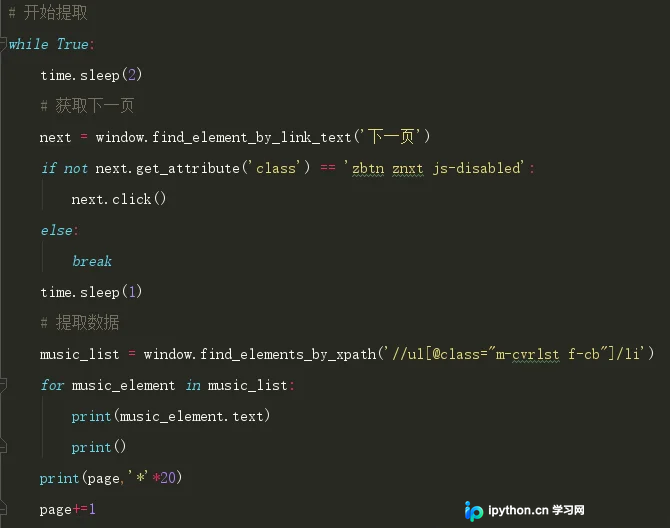
自动翻页与延迟控制
为了获取剩余所有页面的数据,在点击“下一页”按钮前必须设置适当的等待时间(如 time.sleep),否则因页面加载未完成会导致操作报错。
运行上述逻辑后的控制台输出结果如下。
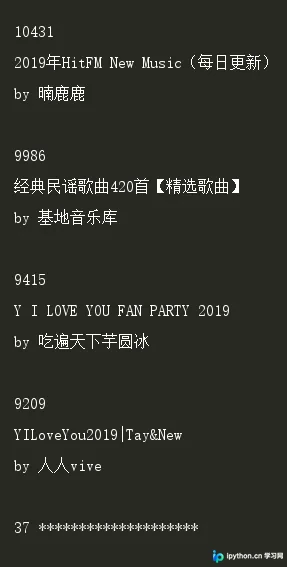
经统计,该分类下共计 37 页数据。待所有页面数据爬取完成后,需调用 quit 方法关闭浏览器进程。
完整代码示例
以下是完整的实现代码。
url = 'https://music.163.com/#/discover/playlist/'

from selenium import webdriver
import time
# 创建浏览器对象
window = webdriver.Chrome('./chromedriver')
window.get(url)
time.sleep(1)
# 切换到iframe窗口
iframe = window.find_element_by_id('g_iframe')
window.switch_to.frame(iframe)
music_list = window.find_elements_by_xpath('//ul[@class="m-cvrlst f-cb"]/li')
for music_element in music_list:
 print(music_element.text)
 print()
print('*'*20)

page = 1
# 开始提取
while True:
 time.sleep(2)
 # 获取下一页
 next = window.find_element_by_link_text('下一页')
 if not next.get_attribute('class') == 'zbtn znxt js-disabled':
  next.click()
 else:
  break
 time.sleep(1)
 # 提取数据
 music_list = window.find_elements_by_xpath('//ul[@class="m-cvrlst f-cb"]/li')
 for music_element in music_list:
  print(music_element.text)
  print()
 print(page,'*'*20)
 page+=1
# 退出浏览器
window.quit()
以上为利用 Python Selenium 爬取网易云音乐歌单名的详细步骤与代码整合,希望能为读者提供帮助。如有疑问欢迎留言,小编将及时回复,感谢对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















