



在 Go 日常开发里,for range 往往是最先上手、也最容易被低估的一组语法。很多人记得它能遍历 slice 和 map,但一到字符串中的中文字符、通道消费,或者想只拿索引不拿值时,就容易写得含糊。本文按类型拆开说明 for range 到底能遍历什么、每次返回的是什么,以及哪些行为看起来顺手、实际上最容易埋坑。
先看最常见的两种遍历
遍历切片:返回索引和元素值
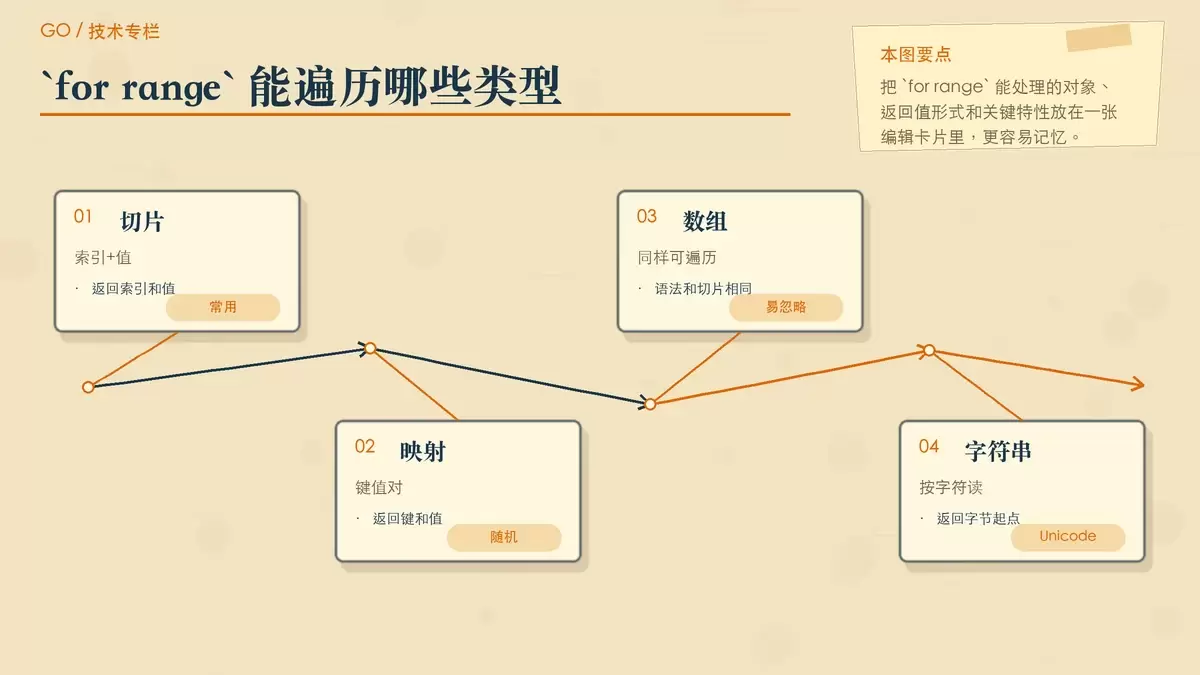
切片是 for range 最常见的使用对象。遍历时会依次返回当前元素的索引和值,适合按顺序读取列表内容。
slice := []string{"Go", "Python", "Java"}
for index, value := range slice {
    fmt.Printf("索引: %d, 值: %sn", index, value)
}
// 输出:
// 索引: 0, 值: Go
// 索引: 1, 值: Python
// 索引: 2, 值: Java
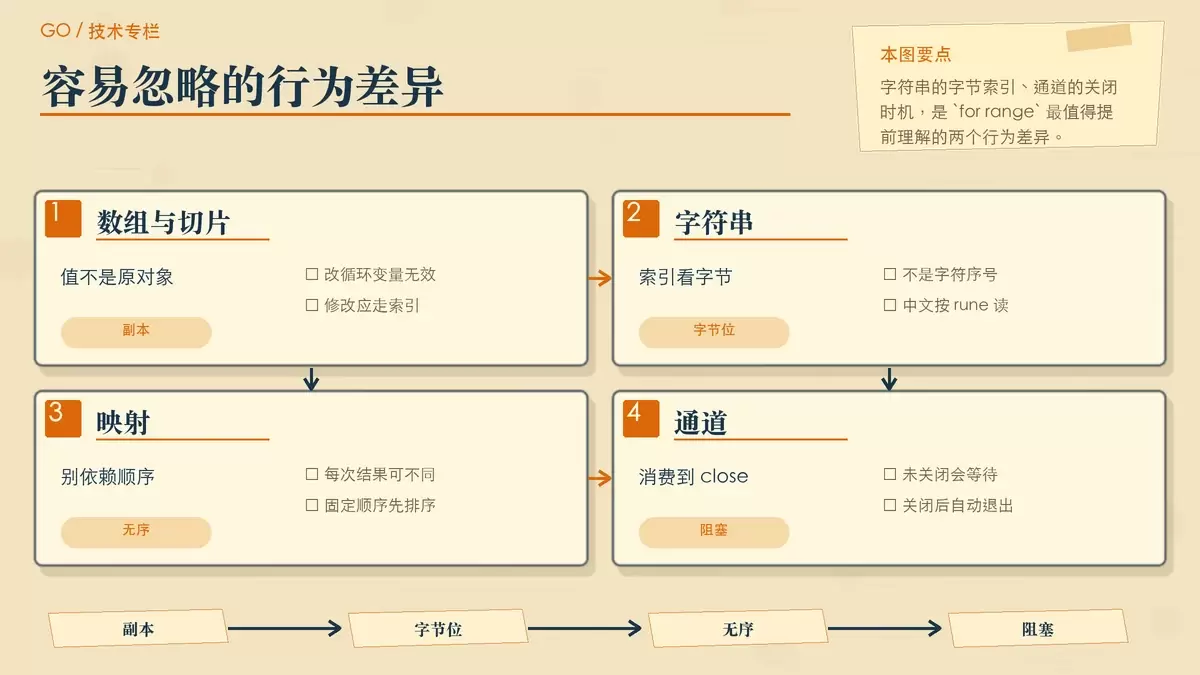
这种写法适合读操作。如果你后面要修改原切片中的元素,不能只改 value,因为这里拿到的是当前元素的副本,应该通过索引回写原切片。
遍历映射:返回键和值,但顺序不固定
遍历 map 时,for range 会返回键和值,这也是 Go 中处理字典数据最直接的方式。
m := map[string]int{"a": 1, "b": 2, "c": 3}
for key, value := range m {
    fmt.Printf("键: %s, 值: %dn", key, value)
}
// 可能的输出(顺序随机):
// 键: a, 值: 1
// 键: b, 值: 2
// 键: c, 值: 3注意:map 的遍历顺序是随机的,每次运行都可能不同。只要你的业务逻辑依赖固定顺序,就不能直接 range,而应该先取出键,再排序后访问。
不止 slice 和 map:还有三种高频对象
遍历数组:语法一样,但值仍然是副本
数组的遍历方式和切片几乎一致,同样返回索引和元素值:
array := [3]int{1, 2, 3}
for i, v := range array {
    fmt.Printf("索引: %d, 值: %dn", i, v)
}
// 输出:
// 索引: 0, 值: 1
// 索引: 1, 值: 2
// 索引: 2, 值: 3
这里要特别记住一点:遍历数组时拿到的 v 也是元素副本。你在循环里修改 v,并不会改动原数组。这个规则和切片遍历时的元素值处理方式是一致的。
遍历字符串:返回字节起始位置和 rune
字符串是最容易被忽略、但在中文场景里最实用的一类。对字符串执行 for range 时,返回的不是“第几个字符”,而是字符的起始字节索引,以及对应的 Unicode 码点,也就是 rune。
str := "Hello 世界"
for index, char := range str {
    fmt.Printf("索引: %d, 字符: %cn", index, char)
}
// 输出:
// 索引: 0, 字符: H
// 索引: 1, 字符: e
// 索引: 2, 字符: l
// 索引: 3, 字符: l
// 索引: 4, 字符: o
// 索引: 5, 字符:
// 索引: 6, 字符: 世
// 索引: 9, 字符: 界
这个结果有两个关键信息值得单独记住:
- 它会自动按 Unicode 字符处理内容,中文、emoji 这类多字节字符都能被当成一个完整的
rune读取。 index表示的是该字符在字符串中的起始字节位置,不是人眼理解的字符序号。
这也是为什么上面的 世 和 界 索引分别是 6 和 9。如果直接按字节处理 UTF-8 字符串,往往会把多字节字符拆坏,而 for range 正好帮你避开了这个问题。
遍历通道:会持续接收,直到通道关闭
对通道使用 for range,是 Go 并发代码里很典型的一种写法。它会不断从通道中取值,直到通道被关闭后自动退出循环。
ch := make(chan int, 3)
ch <- 1
ch <- 2
ch <- 3
close(ch)

for value := range ch {
    fmt.Println("从通道接收:", value)
}
// 输出:
// 从通道接收: 1
// 从通道接收: 2
// 从通道接收: 3
它的优点是写法足够简洁,不需要手动反复判断接收结果,因此非常适合消费一批已经明确结束的数据。
但这里也有三个必须清楚的行为:
- 遍历通道时只会返回值,没有索引。
- 如果通道一直没关闭,循环就会继续阻塞等待新值。
- 通道一旦关闭,
for range会自动结束,不需要额外写退出条件。
所以在生产者已经发送完所有数据的场景下,记得及时 close(ch),否则消费者可能一直卡在那里等待。
几种很实用的简写方式
只取索引
如果你只关心位置,不关心元素内容,可以忽略值:
for i := range slice {
    fmt.Println("索引:", i)
}
只取值
如果你只需要元素值,可以用下划线占掉索引位置:
for _, v := range slice {
    fmt.Println("值:", v)
}
只利用遍历次数
对于数组或切片,甚至可以既不要索引,也不要值,只借用它的长度来执行固定次数循环:
for range slice {
    fmt.Println("执行一次")
}
这种写法虽然简单,但前提是你的循环次数确实要和切片或数组长度绑定。若只是想做固定次数循环,代码可读性上仍要结合上下文判断是否合适。
写起来顺手,实际更该注意的几个问题
遍历得到的值往往是副本
无论是数组、切片还是字符串,for range 取到的当前值都更适合用于读取,而不是原地修改。你改的是循环变量,不是底层数据本身。需要修改时,应通过索引访问原对象。
不要依赖 map 的遍历顺序
map 的顺序不稳定,这是 Go 的语言行为,不是偶发现象。只要逻辑依赖顺序,就先排序,再按排序结果取值。
通道不关闭就可能一直阻塞
对通道使用 for range 最大的风险不在语法,而在生命周期管理。发送端如果没有在合适时机关闭通道,接收端就会持续等待,程序表现出来往往就是“卡住不动”。
遍历 map 时不要顺手增删元素
Go 允许在遍历 map 的过程中修改它,但结果并不适合依赖。增加或删除元素后,当前遍历过程可能受到影响,行为不稳定,实际项目里通常应避免这样写。
最后用一张表把行为差异记清楚
for range 的价值不只是“少写一点循环代码”,而是它针对不同数据类型提供了不同层次的遍历能力。真正好用的前提,是你清楚每种类型返回的内容和边界条件。
| 类型 | 返回值 | 特性 |
|---|---|---|
| 数组 | 索引、元素值 | 元素是副本 |
| 切片 | 索引、元素值 | 元素是副本 |
| 字符串 | 索引、rune | 自动处理 Unicode |
| 映射 | 键、值 | 遍历顺序随机 |
| 通道 | 值 | 阻塞直到关闭 |
如果你的场景是字符串处理,for range 对 Unicode 的原生支持非常实用;如果你的场景是通道消费,它又能把接收循环写得足够自然。反过来,一旦涉及修改原数据、依赖顺序,或者通道关闭时机不明确,就应该先想清楚再下手。















