



和 AI 连续聊上十几轮后,模型突然接不上前文,或者接口直接因为 Token 超限报错,这类问题在实际接入里很常见。要解决它,核心不是一味扩大上下文,而是根据对话长度、业务类型和成本约束,决定该保留什么、压缩什么。下面就结合 Go 里的常见实现,把三种主流方案和一套更稳妥的组合思路讲清楚。
为什么 AI 对话一定要做上下文压缩
大模型的上下文窗口始终是有限资源。比如 GPT-3.5 只有 4K tokens,GPT-4 最多 32K,Claude 3 虽然能到 200K,但在连续对话里,历史消息一旦累积起来,10 轮上下就可能吃掉几千 Token。
这也是很多应用在上线后很快遇到的现实问题:对话越长,历史越多,请求越贵,也越容易超限。
压缩带来的直接收益
- 控制成本:Token 越少,API 调用费用越低。
- 减少失败:避免因为上下文过长直接触发接口报错。
- 维持连贯性:把真正重要的信息保留下来,回复质量通常比“全量硬塞”更稳定。
所以,上下文压缩并不是可选优化,而是长对话产品里迟早要补上的一层能力。
三种主流压缩策略怎么选
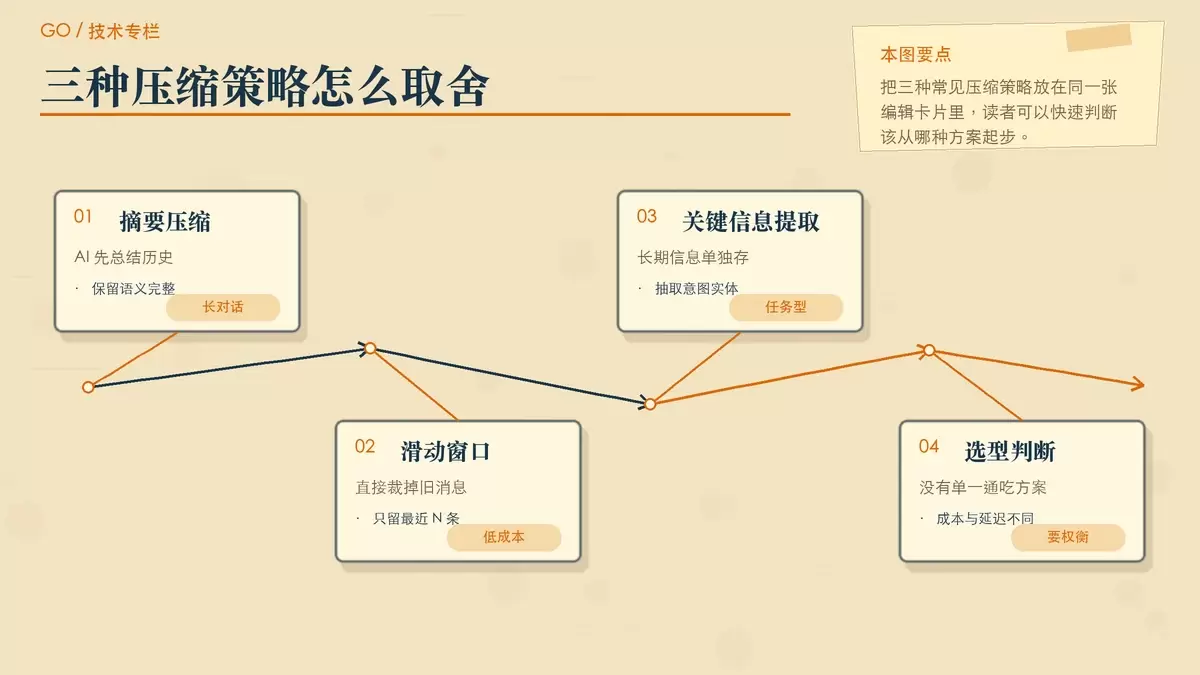
常见做法大致可以分成三类,它们解决的是不同问题,没有哪一种适合所有场景。
1. 摘要压缩
做法是让 AI 自己把历史对话总结成一段较短的摘要,再用摘要替换掉原来的长历史。它更适合客服机器人、知识问答这类长链路场景。
优点是语义保留相对完整,缺点是要额外发起一次 API 调用,成本和延迟都会增加。
2. 滑动窗口
做法是只保留最近 N 条消息,超过窗口的旧消息直接丢弃。这种方案实现最简单,适合实时性要求高、上下文依赖相对靠近当前轮次的聊天场景。
优点是零额外成本、实现直接;缺点是早期的重要信息可能被截断。
3. 关键信息提取
做法是从对话里抽取实体、意图、偏好、状态等结构化信息,单独保存下来。它尤其适合订票、下单、咨询这类任务型对话。
优点是核心数据不容易随对话增长而丢失;缺点是需要提前设计清楚信息模型,提取逻辑也要能落地。
三种策略分别怎么实现
摘要压缩:适合长对话,但要接受细节损失
摘要压缩的思路并不复杂:先收集历史消息,再构造提示词,让模型输出一段保留关键信息的简洁摘要,最后拿摘要替换原有历史。
原文里的 Go 核心代码如下:
func summarizeHistory(messages []Message) (string, error) {
    prompt := "请将以下对话压缩成简洁摘要,保留关键信息:n"
    for _, msg := range messages {
        prompt += fmt.Sprintf("%s: %sn", msg.Role, msg.Content)
    }
    // 调用 AI API 生成摘要...
    return callAI(prompt)
}
这个方案的关键不在“能不能总结”,而在“什么时候触发”。比较常见的两种触发方式是:
- 按轮次触发,比如对话超过 15 轮后开始压缩。
- 按 Token 占比触发,比如上下文使用量超过总窗口的 70% 时再压缩。
它的主要问题也很明确:摘要天然会损失细节。如果用户后面追问“我刚才提到的那个餐厅叫什么”,而这类细节没有进入摘要,模型就可能答不上来。
因此,摘要压缩通常要配合“追问兜底”一起设计。比如模型在不确定时主动补一句:“抱歉,能再告诉我一次吗?”这样至少不会在缺失信息时硬答。
滑动窗口:实现成本最低,但别把重要设定一起丢掉
如果你的场景更偏即时聊天,滑动窗口往往是最先能上线的方案。它只做一件事:保留最近 N 条消息。
type Conversation struct {
    Messages []Message
    MaxSize  int
}

func (c *Conversation) AddMessage(msg Message) {
    c.Messages = append(c.Messages, msg)
    if len(c.Messages) > c.MaxSize {
        c.Messages = c.Messages[len(c.Messages)-c.MaxSize:]
    }
}
窗口大小一般建议先从 5-10 条开始试。太小,前后文接不上;太大,又失去压缩意义。这个值最好结合你的实际业务数据做调整,而不是写死成经验数。
这里有一个很容易被忽略的点:系统消息必须始终保留。System Prompt 定义的是模型角色、语气、边界和行为准则,如果把它也随着窗口一起裁掉,回复质量通常会明显波动。
滑动窗口的短板也很直接。比如用户在最开始说“我叫张三”,如果 10 轮之后这条消息被裁掉了,模型自然就不知道这个信息了。因此它适合“近因上下文”强、长期记忆弱的场景,不适合任务状态需要长期保存的流程。
关键信息提取:把长期记忆改成结构化存储
对于任务型对话,更稳的做法通常不是让模型死记整段对话,而是把真正会影响结果的信息抽出来单独保存。
常见提取项包括:
- 用户信息:姓名、联系方式、身份。
- 意图识别:用户当前到底想完成什么。
- 实体抽取:地点、时间、物品、金额等关键对象。
- 偏好记录:喜欢什么、不喜欢什么,有没有限制条件。
示例代码如下:
type UserInfo struct {
    Name     string   `json:"name"`
    Intent   string   `json:"intent"`
    Entities []string `json:"entities"`
}

func extractKeyInfo(dialog string) (*UserInfo, error) {
    prompt := "从对话中提取关键信息,返回 JSON 格式:" + dialog
    // 调用 AI 提取并解析 JSON...
    return &UserInfo{}, nil
}
比如用户说:“我想订一张明天从北京到上海的机票,预算 1000 以内”。那么可以提取出这样的结构化结果:
意图:订机票
出发地:北京
目的地:上海
日期:明天
预算:1000 元以内
这些信息一旦独立保存,就不会因为历史对话被裁剪或摘要化而消失。这类做法本质上是在把“上下文记忆”变成“业务状态管理”,比单纯堆消息更适合可执行任务。
实际项目更稳妥的做法:组合策略
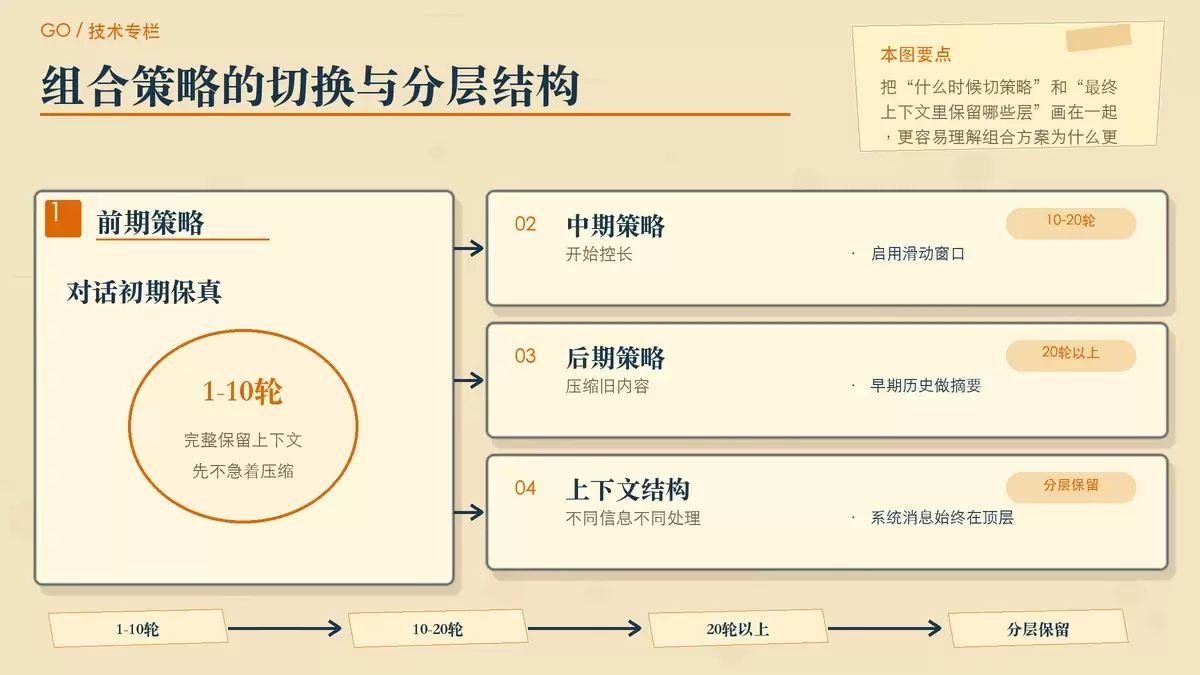
单一策略各有长短,真正落地时,通常更建议按对话阶段动态切换。
一种比较实用的组合思路是:
- 对话初期(1-10 轮):先不压缩,完整保留上下文。
- 对话中期(10-20 轮):开始启用滑动窗口,同时提取关键信息。
- 对话后期(20 轮以上):对更早的历史做摘要压缩,关键信息继续单独保存。
对应的 Go 逻辑可以写成这样:
func (m *Manager) Compress(messages []Message) []Message {
    switch {
    case len(messages) > 20:
        return compressBySummary(messages)  // 摘要压缩
    case len(messages) > 10:
        return messages[len(messages)-10:]  // 滑动窗口
    default:
        return messages  // 不压缩
    }
}
如果再进一步整理,一个更完整的上下文结构通常会是下面这样:
系统消息(始终保留)
↓
关键信息摘要(用户姓名、意图、偏好等)
↓
历史对话摘要(早期对话的总结)
↓
最近 N 条对话(滑动窗口)
↓
当前用户输入
这种分层方式的价值在于,不同信息有不同的保留策略:系统设定长期固定,业务关键数据结构化保存,早期历史压成摘要,最近消息则保留原文。这样既能控长,也能尽量维持对话稳定性。
落地时最容易踩的几个坑
先做 Token 估算,不要等报错再处理
压缩策略能否及时触发,前提是你对上下文大小有基本估算。文中给出的经验值是:中文大约 1.5-2 个字一个 Token,英文约 4 个字符一个 Token。
示例函数如下:
func estimateTokens(text string) int {
    return len(text) / 2  // 中文粗略估算
}
这当然只是粗估,但足够作为触发阈值的第一层判断。不要把压缩做成“报错后的补救逻辑”,而要把它前置成请求发送前的常规检查。
系统消息不能丢
这一点值得单独再强调一次。无论你用摘要压缩、滑动窗口还是关键信息提取,系统消息(System Prompt)都必须保留。它决定的是模型如何理解任务,而不是普通聊天内容。
压缩别每轮都做
每轮都触发摘要,会带来额外延迟和成本,也会让对话状态变得更难追踪。更合理的方式是:
- 每次对话后只做长度检查;
- 达到设定阈值时再真正压缩;
- 针对不同业务设置不同触发点。
给信息丢失留兜底机制
任何压缩都会有信息损失,只是程度不同。因此应用层最好允许模型在不确定时主动追问,而不是编造答案。比如:“抱歉,能再告诉我一次您的联系方式吗?”
这类设计看起来简单,但对真实体验影响很大。因为用户通常可以接受模型“再确认一次”,却很难接受模型“记错并且说得很肯定”。
怎么根据场景做最终判断
如果你的应用偏长对话、重语义连续性,摘要压缩更合适;如果偏即时聊天、强调低成本和低延迟,滑动窗口往往够用;如果是订票、购物、表单填写这类任务型流程,关键信息提取通常比保留整段聊天更有价值。
从工程实践看,最稳妥的方案仍然是组合使用:前期保留原文,中期用窗口控长,后期把旧历史压成摘要,同时把用户姓名、意图、偏好、实体等信息结构化保存。这样既能控制 Token 成本,也更容易把对话质量维持在可预期范围内。















