


Python爬虫实现爬取百度百科词条功能实例

本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
Python爬虫概述与工作原理
本文通过一个具体的Python爬虫实例,详细讲解如何爬取百度百科中的词条内容。该示例旨在为读者提供可参考的代码实现与思路,帮助理解爬虫开发的基本流程。
网络爬虫(Spider)是一种自动提取网页数据的程序,主要服务于搜索引擎,用于从互联网中下载网页内容。爬虫的工作始于一个或多个初始URL,获取这些页面后,会从中提取新的URL并加入待抓取队列。在抓取过程中,系统会根据特定的网页分析算法过滤掉与主题无关的链接,仅保留有用链接。随后,爬虫依据预设的搜索策略从队列中选取下一个目标URL进行抓取,并重复此过程,直到满足停止条件。所有抓取的网页会被存储、分析、过滤并建立索引,以便后续查询。常见的爬虫框架包括Scrapy等。
一个自定义的爬虫程序通常由四个核心部分组成:URL管理器、网页下载器、网页解析器以及输出处理器。
百度百科词条爬取实例实现
接下来,我们将通过一个具体的代码实例,展示如何爬取百度百科的词条信息。
爬虫主程序入口
这是爬虫程序的主入口文件,负责协调各个组件的工作。
主程序代码实现
from crawler_test.html_downloader import UrlDownLoader
from crawler_test.html_outer import HtmlOuter
from crawler_test.html_parser import HtmlParser
from crawler_test.url_manager import UrlManager
# 爬虫主程序入口
class MainCrawler():
  def __init__(self):
    # 初始值,实例化四大处理器:url管理器,下载器,解析器,输出器
    self.urls = UrlManager()
    self.downloader = UrlDownLoader()
    self.parser = HtmlParser()
    self.outer = HtmlOuter()
  # 开始爬虫方法
  def start_craw(self, main_url):
    print('爬虫开始...')
    count = 1
    self.urls.add_new_url(main_url)
    while self.urls.has_new_url():
      try:
        new_url = self.urls.get_new_url()
        print('爬虫%d,%s' % (count, new_url))
        html_cont = self.downloader.down_load(new_url)
        new_urls, new_data = self.parser.parse(new_url, html_cont)
        # 将解析出的url放入url管理器,解析出的数据放入输出器中
        self.urls.add_new_urls(new_urls)
        self.outer.conllect_data(new_data)
        if count >= 10:# 控制爬取的数量
          break
        count += 1
      except:
        print('爬虫失败一条')
    self.outer.output()
    print('爬虫结束。')
if __name__ == '__main__':
  main_url = 'https://baike.baidu.com/item/Python/407313'
  mc = MainCrawler()
  mc.start_craw(main_url)
URL管理器模块
URL管理器负责维护待抓取和已抓取的URL集合,防止重复抓取并管理抓取顺序。
URL管理器代码
# URL管理器
class UrlManager():
  def __init__(self):
    self.new_urls = set() # 待爬取
    self.old_urls = set() # 已爬取
  # 添加一个新的url
  def add_new_url(self, url):
    if url is None:
      return
    elif url not in self.new_urls and url not in self.old_urls:
      self.new_urls.add(url)
  # 批量添加url
  def add_new_urls(self, urls):
    if urls is None or len(urls) == 0:
      return
    else:
      for url in urls:
        self.add_new_url(url)
  # 判断是否有url
  def has_new_url(self):
    return len(self.new_urls) != 0
  # 从待爬取的集合中获取一个url
  def get_new_url(self):
    new_url = self.new_urls.pop()
    self.old_urls.add(new_url)
    return new_url
网页下载器模块
网页下载器负责根据给定的URL获取网页的HTML内容。
网页下载器代码
from urllib import request
# 网页下载器
class UrlDownLoader():
  def down_load(self, url):
    if url is None:
      return None
    else:
      rt = request.Request(url=url, method='GET')   # 发GET请求
      with request.urlopen(rt) as rp:         # 打开网页
        if rp.status != 200:
          return None
        else:
          return rp.read()            # 读取网页内容
网页解析器模块
网页解析器利用BeautifulSoup等工具,从HTML内容中提取新的链接和词条数据。
网页解析器代码
import re
from urllib import parse
from bs4 import BeautifulSoup
# 网页解析器,使用BeautifulSoup
class HtmlParser():
  # 每个词条中,可以有多个超链接
  # main_url指url公共部分,如“https://baike.baidu.com/”
  def _get_new_url(self, main_url, soup):
    # baike.baidu.com/
    # <a target="_blank" href="/item/%E8%AE%A1%E7%AE%97%E6%9C%BA%E7%A8%8B%E5%BA%8F%E8%AE%BE%E8%AE%A1%E8%AF%AD%E8%A8%80" rel="external nofollow" >计算机程序设计语言</a>
    new_urls = set()
    # 解析出main_url之后的url部分
    child_urls = soup.find_all('a', href=re.compile(r'/item/(\%\w{2})+'))
    for child_url in child_urls:
      new_url = child_url['href']
      # 再拼接成完整的url
      full_url = parse.urljoin(main_url, new_url)
      new_urls.add(full_url)
    return new_urls
  # 每个词条中,只有一个描述内容,解析出数据(词条,内容)
  def _get_new_data(self, main_url, soup):
    new_datas = {}
    new_datas['url'] = main_url
    # <dd class="lemmaWgt-lemmaTitle-title"><h1>计算机程序设计语言</h1>...
    new_datas['title'] = soup.find('dd', class_='lemmaWgt-lemmaTitle-title').find('h1').get_text()
    # class="lemma-summary" label-module="lemmaSummary"...
    new_datas['content'] = soup.find('div', attrs={'label-module': 'lemmaSummary'},
                     class_='lemma-summary').get_text()
    return new_datas
  # 解析出url和数据(词条,内容)
  def parse(self, main_url, html_cont):
    if main_url is None or html_cont is None:
      return
    soup = BeautifulSoup(html_cont, 'lxml', from_encoding='utf-8')
    new_url = self._get_new_url(main_url, soup)
    new_data = self._get_new_data(main_url, soup)
    return new_url, new_data
输出处理器模块
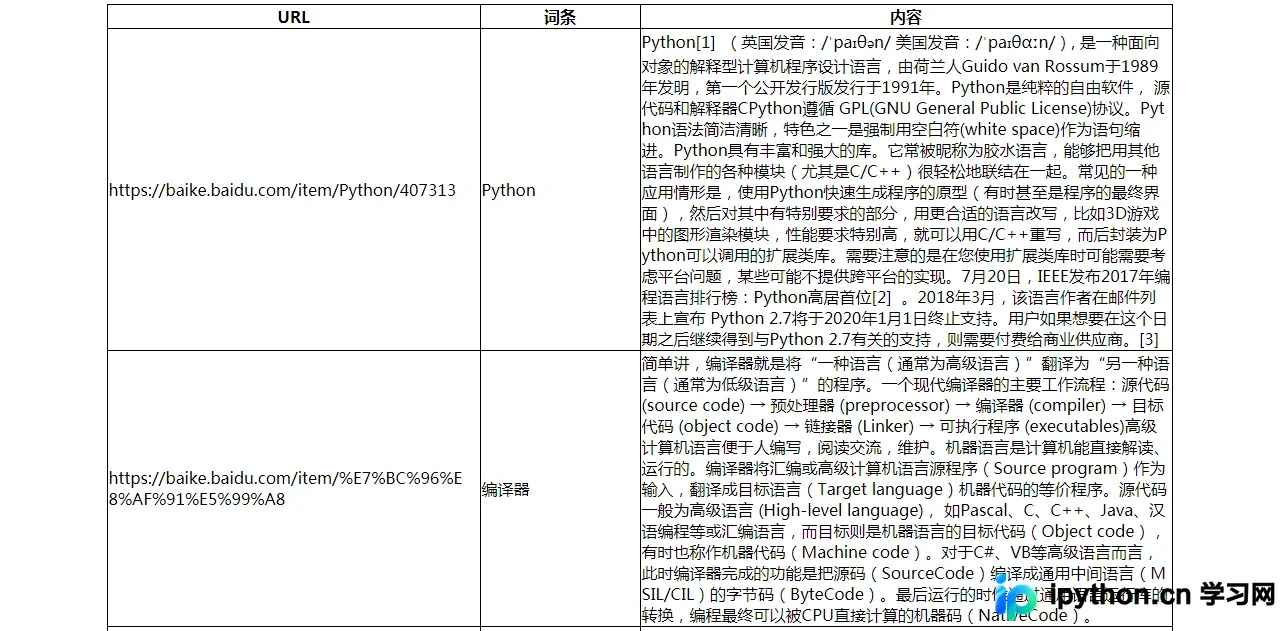
输出处理器负责收集解析后的数据,并将其格式化为HTML表格进行保存。
输出处理器代码
# 输出器
class HtmlOuter():
  def __init__(self):
    self.datas = []
  # 先收集数据
  def conllect_data(self, data):
    if data is None:
      return
    self.datas.append(data)
    return self.datas
  # 输出为HTML
  def output(self, file='output_html.html'):
    with open(file, 'w', encoding='utf-8') as fh:
      fh.write('<html>')
      fh.write('<head>')
      fh.write('<meta charset="utf-8"></meta>')
      fh.write('<title>爬虫数据结果</title>')
      fh.write('</head>')
      fh.write('<body>')
      fh.write(
        '<table style="border-collapse:collapse; border:1px solid gray; width:80%; word-break:break-all; margin:20px auto;">')
      fh.write('<tr>')
      fh.write('<th style="border:1px solid black; width:35%;">URL</th>')
      fh.write('<th style="border:1px solid black; width:15%;">词条</th>')
      fh.write('<th style="border:1px solid black; width:50%;">内容</th>')
      fh.write('</tr>')
      for data in self.datas:
        fh.write('<tr>')
        fh.write('<td style="border:1px solid black">{0}</td>'.format(data['url']))
        fh.write('<td style="border:1px solid black">{0}</td>'.format(data['title']))
        fh.write('<td style="border:1px solid black">{0}</td>'.format(data['content']))
        fh.write('</tr>')
      fh.write('</table>')
      fh.write('</body>')
      fh.write('</html>')
运行效果与扩展资源
以下是部分运行效果的展示。
如果您对Python技术感兴趣,可以进一步查阅本站的相关教程,包括《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望本文提供的代码示例和分析对您学习Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















