


Python模拟豆瓣6.0登录实战:从抓包到代码实现

本文详解如何使用Python的requests库模拟豆瓣6.0新版网站的登录过程。通过开发者工具分析POST请求接口与数据格式,利用Session保持Cookie状态,成功获取个人首页内容。针对新版反爬策略,提供了完整的代码示例与关键步骤解析,帮助开发者解决登录失败问题。
背景与问题分析
近期在研究Python爬虫技术时,参考了网上关于模拟豆瓣登录的教程。尝试运行后发现原有代码无法正常工作,经对比分析发现,豆瓣网站已进行更新并增强了反爬策略,导致旧方法失效。
登录接口分析
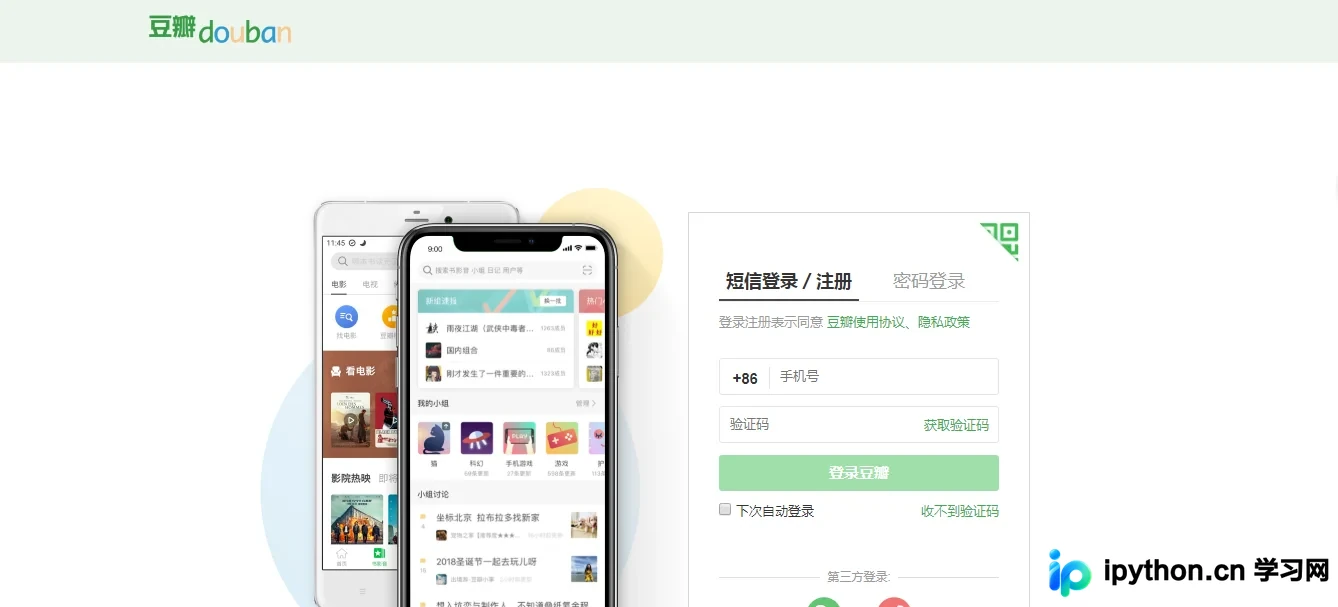
为了成功模拟登录,首先需要明确目标网站的登录入口。
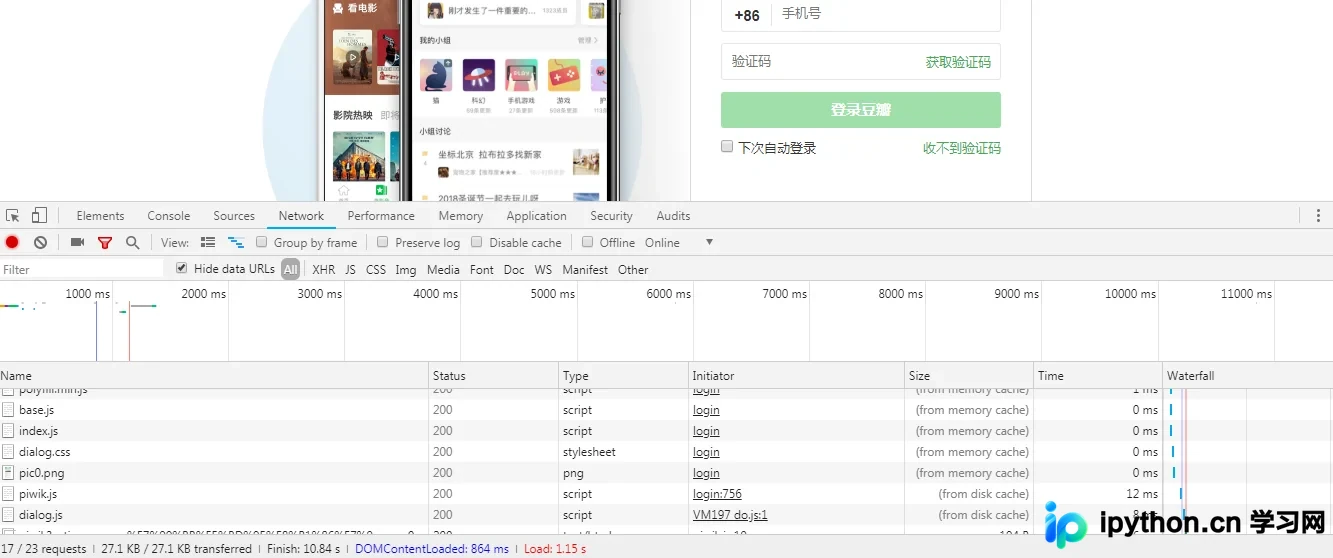
通过浏览器开发者工具开启网络监控模式。
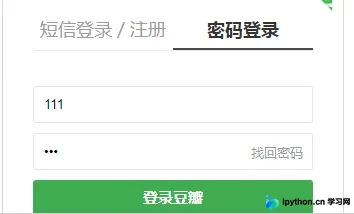
在登录页面的账号和密码输入框中随机填入测试数据。
提交表单后,观察网络面板中发出的请求类型。
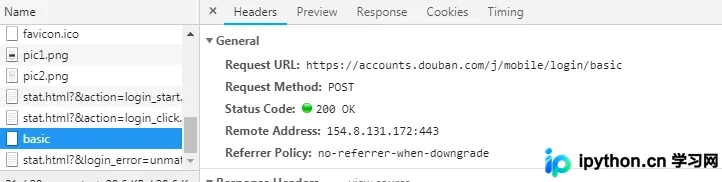
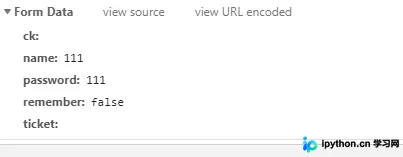
可以确认,登录接口地址为:https://accounts.douban.com/j/mobile/login/basic
提交的数据格式为JSON结构。
代码实现步骤
基于上述分析,我们可以开始编写Python代码来实现登录逻辑。
import requests

def main():
  url_basic = 'https://accounts.douban.com/j/mobile/login/basic'
  url = 'https://www.douban.com/'
  ua_headers = { "User-Agent":'Mozilla/4.0 (compatible; MSIE 8.0; Windows NT 6.0; Trident/4.0)'}
  data = {
    'ck': '',
    'name': '自己的账号',
    'password': '自己的密码',
    'remember': 'false',
    'ticket': ''
  }

  s = requests.session()
  s.post(url=url_basic, headers=ua_headers, data=data)
  response = s.get(url=url, headers=ua_headers)
  with open('douban.html' , 'wb') as f:
    f.write(response.content)

if __name__ == '__main__':
  main()
第一步操作如下:
初始化一个session对象:s = requests.session()
该操作的核心目的是跨请求保持参数状态。具体而言,使用该session对象发出的所有HTTP请求都会自动共享并维持相同的cookies,从而模拟浏览器登录后的会话状态。
第二步操作如下:
利用已创建的session对象,携带账号和密码信息向登录接口发送POST请求。
需要注意的是,改版后的豆瓣不再通过HTTP重定向来响应登录成功,而是直接返回JSON格式的数据。因此,我们需要手动处理这一变化,确保后续请求能正确携带登录凭证。
第三步操作如下:
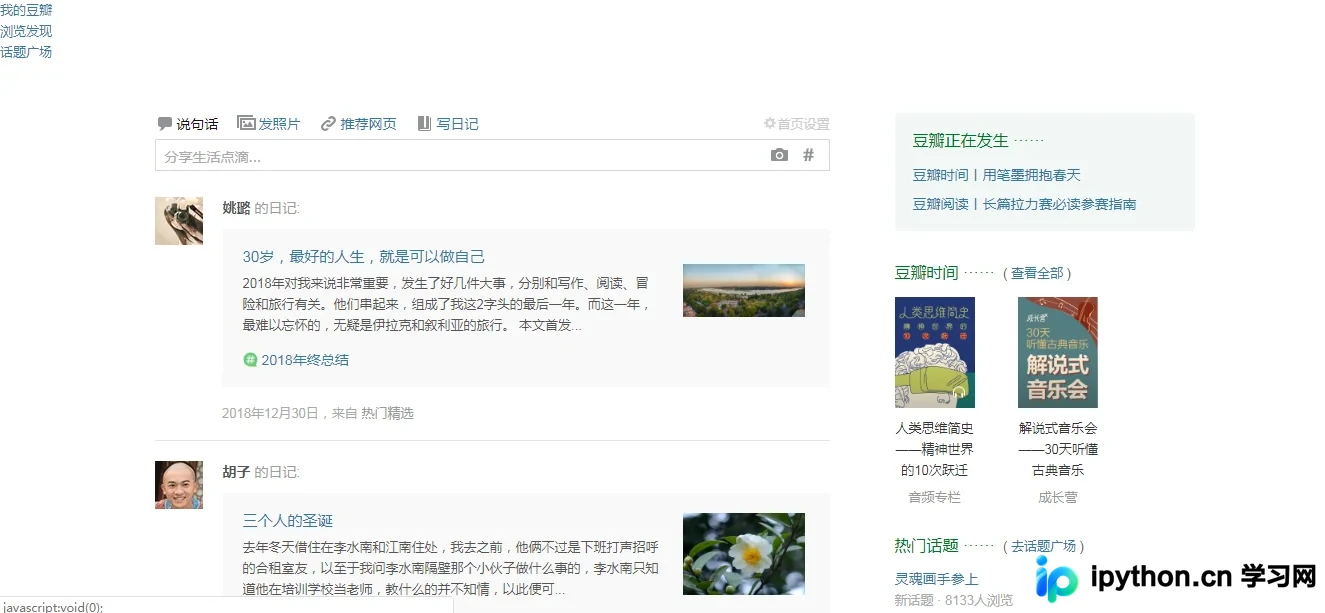
在登录成功后,session中已保存有效的cookie。此时携带该cookie访问豆瓣首页,即可获取并展示用户个人的首页内容。
最终成功获取个人首页页面。
以上介绍了使用Python模拟豆瓣登录的完整流程与代码实现,希望能对读者有所帮助。如有疑问欢迎留言交流,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















