


Python爬虫实现文件下载的三种方法及原理详解

本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
本文主要探讨当网页中包含图片、视频或文档等文件资源时,如何利用Python爬虫技术将这些资源自动下载至本地。
1、如何定位网络资源:
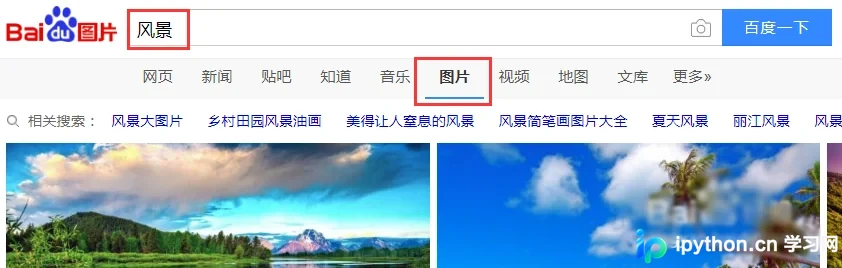
以百度图片搜索为例,当你在搜索框输入特定关键词并执行搜索后,页面会展示大量与该主题相关的图片结果。
此外,若你希望获取英语学习资料,可能会访问提供大量MP3听力文件的网站,这些内容同样属于可抓取的目标资源。
在互联网时代,只要具备搜索意识,绝大多数公开资源都能被找到。
2、如何识别网页中的资源链接:
继续以上述百度图片搜索结果为例。虽然可以手动逐张保存图片,但这种方式效率低下且耗时。为了实现自动化下载,程序需要识别资源的特征并定位其地址。
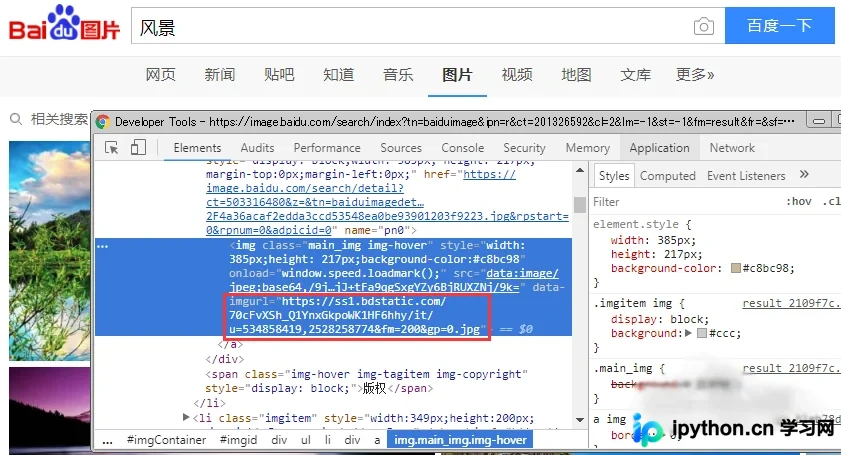
启用浏览器的开发者调试工具(不同浏览器操作略有差异,具体可参考相关教程)。通过检查元素找到目标资源的实际URL路径,如截图所示。若需批量下载相似资源,必须总结出识别这些资源地址的规律,并将其转化为代码逻辑。
3、资源下载方法一:
实现代码非常简洁,具体如下:
from urllib.request import urlretrieve

urlretrieve("图片URL", "./image.jpg")
利用urlretrieve函数,可以直接将指定URL对应的图片文件下载至当前工作目录(./),并将其重命名为image.jpg。
4、资源下载方法二:
直接参考以下代码实现:
import requests

resource = requests.get("图片URL")

with open("./image.jpg", mode="wb") as fh:

  fh.write(resource.content)
该方法依赖Python的requests库,其功能与方法一基本一致。安装requests库可通过pip命令完成,过程简单,此处不再赘述。
5、资源下载方法三:
具体代码如下:
import requests

resource = requests.get("图片URL", stream=True)

with open("./image.jpg", mode="wb") as fh:

  for chunk in resource.iter_content(chunk_size=100):

    fh.write(chunk)
与方法二的主要区别在于,在调用get方法时传入了参数stream=True。同时,文件写入过程改为分块进行。
具体含义如下:
前两种方法是将整个文件内容加载至内存后,再一次性写入硬盘文件。
方法三则是每次下载指定大小(此处示例为100字节)的数据块,随即写入硬盘文件,直至整个文件下载完毕。
方法三的优势在于,当处理大容量文件时,能够有效避免内存占用过高导致的系统压力。
6、资源下载说明一:
上述示例均以图片资源为例,但文档、视频等其他类型资源的下载逻辑相同。核心在于准确识别网页中资源对应的URL地址,因为部分资源可能使用相对路径或经过加密处理。
7、资源下载说明二:
前述示例仅涉及单一资源的下载。若需在同一网页中批量下载多个资源,可遵循以下思路:
1. 提取所有待下载资源的URL,构建资源URL集合;
2. 将下载函数中的资源URL和保存路径设计为参数;
3. 遍历资源集合,通过循环调用下载函数,从而实现批量下载。
总结:以上内容涵盖了Python爬虫下载文件的核心知识点,感谢阅读。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















