


Python ElementTree处理XML文件完整指南

本文详细介绍如何使用Python内置的ElementTree库处理XML文件。通过导入模块、获取根节点、使用find和findall方法提取子节点及遍历元素等步骤,展示完整的XML数据读取流程。文末附带UI库XML解析的编程练习题,帮助读者巩固XML节点操作与类设计能力。
Python ElementTree处理XML文件完整指南
近期有开发者咨询如何利用Python解析XML文件,为此整理了一份简洁的操作指南,供参考学习。
首先准备一个示例XML文件,其内容结构如下。将该文件保存为:student.xml
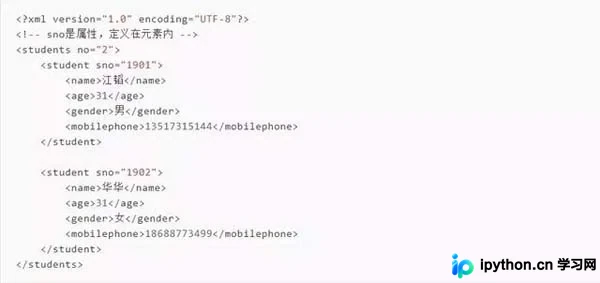
若需提取该XML文件中的数据,需借助Python内置的ElementTree模块进行处理。
XML文件基础操作与节点解析
具体操作步骤如下:
1、导入所需模块(该模块为Python内置自带)

2、打开文件,并获取根节点的属性及节点名称
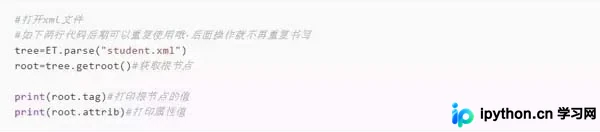
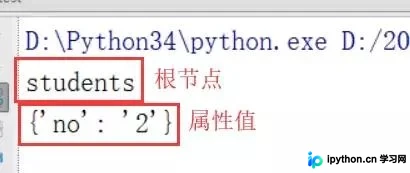
执行代码后,输出结果如下:
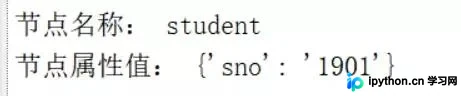
3、使用find方法获取子节点(注意:此方法仅能根据指定名称获取第一个匹配的子节点)
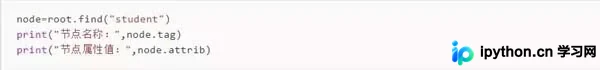
执行结果如下:
4、使用findall方法获取所有子节点,返回结果将存储在一个列表中
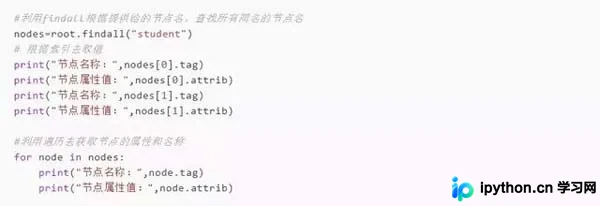
执行结果如下:
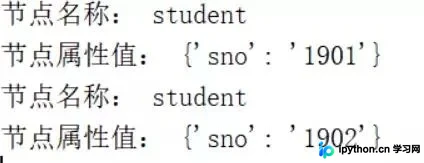
5、使用findall方法获取所有三级子节点,返回结果同样存储在一个列表中
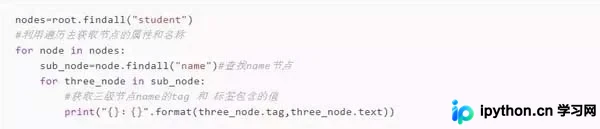
执行结果如下:
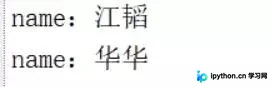
6、通过遍历方式直接访问子节点下的所有元素
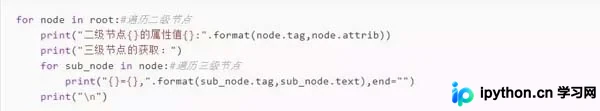
执行结果如下:
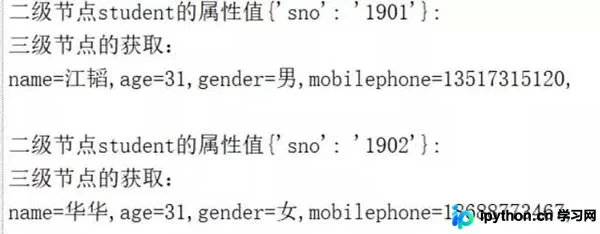
至此,XML文件的基础处理流程已全部完成。
实战练习:UI库XML解析与类设计
留给大家一个练习题:存在一个XML文件,内容如下,保存为:UILibrary.xml
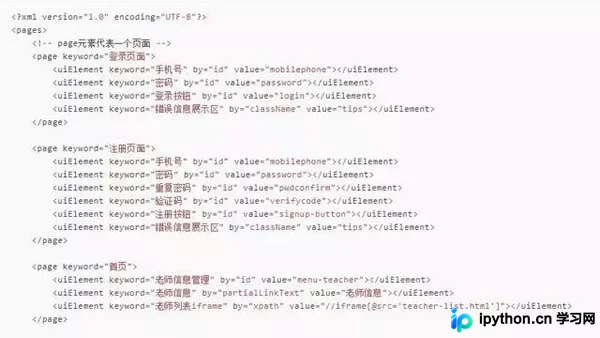
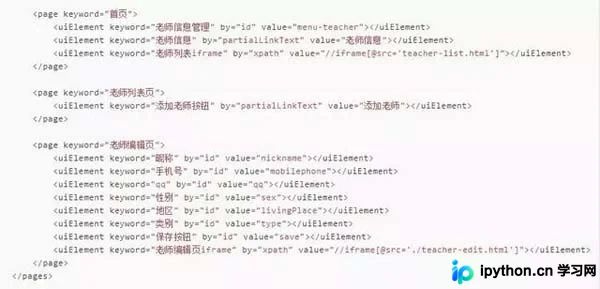
针对上述XML文件,需满足以下要求:
◆ 编写一个XmlUtil类
在该类中定义一个函数:get_page
该函数接收一个参数file_path
实现元素读取功能,返回列表形式的数据,且列表内存储每个page节点的相关信息;
◆ 编写一个page类
该类包含2个属性:page_key_word,
用于存储页面信息;uiElement用于存储列表数据
◆ 编写一个UiElement类
该类包含1个属性:用于存储列表类型的数据,将每一条信息作为列表中的一个元素。
以上就是本文的全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















