


Python ElementTree 美化 XML 输出格式详解

Python 的 ElementTree 模块生成的 XML 默认紧凑无缩进,难以阅读。本文介绍如何遍历 Element 对象的 tag、attrib、text 和 tail 属性,通过递归修改 text 和 tail 添加换行与缩进,实现 XML 文档的美化输出,并讨论了 Windows 换行符兼容性及 XML 与 JSON 的使用场景差异。
在 Python 中利用 ElementTree 处理 XML 文件时,默认生成的输出内容通常合并在一行,导致可读性较差。
例如生成的 XML 结构如下:
<root><aa>aatext<cc>cctext</cc></aa><bb>bbtext<dd>ddtext<ee>eetext</ee></dd></bb></root>
虽然 minidom 模块中的 toprettyxml 和 writexml 方法提供了优化 XML 输出的参数,但存在两个主要问题:
a. 若输入的 XML 已经经过美化,执行该方法会产生大量多余的空行。
b. 该方法会将文本内容独立成行,输出效果如下:
<root>
  <aa>
    aatext
  </aa>
  <bb>
    bbtext
  </bb>
</root>
而期望的输出格式应如:
<root>
  <aa>aatext</aa>
  <bb>bbtext</bb>
</root>
因此,需要自行编写一个用于美化 XML 的方法。
首先分析 ElementTree 模块中的 Element 类,通过 getroot 方法获取的即为 Element 类实例。
该对象包含四个关键属性:tag、attrib、text 和 tail,它们在 XML 结构中的对应关系如图所示:
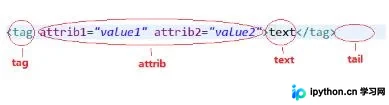
整个 XML 文档可视为一个顶层 Element,内部嵌套了多个子 Element。
Element 对象支持通过 for 循环进行迭代遍历。
通过在 text 和 tail 属性中插入换行符和制表符,即可实现 XML 的美化排版。
具体美化代码实现如下:
def prettyXml(element, indent, newline, level = 0): # elemnt为传进来的Elment类,参数indent用于缩进,newline用于换行
  if element: # 判断element是否有子元素
    if element.text == None or element.text.isspace(): # 如果element的text没有内容
      element.text = newline + indent * (level + 1)
    else:
      element.text = newline + indent * (level + 1) + element.text.strip() + newline + indent * (level + 1)
  #else: # 此处两行如果把注释去掉,Element的text也会另起一行
    #element.text = newline + indent * (level + 1) + element.text.strip() + newline + indent * level
  temp = list(element) # 将elemnt转成list
  for subelement in temp:
    if temp.index(subelement) < (len(temp) - 1): # 如果不是list的最后一个元素,说明下一个行是同级别元素的起始,缩进应一致
      subelement.tail = newline + indent * (level + 1)
    else: # 如果是list的最后一个元素, 说明下一行是母元素的结束,缩进应该少一个
      subelement.tail = newline + indent * level
    prettyXml(subelement, indent, newline, level = level + 1) # 对子元素进行递归操作

from xml.etree import ElementTree   #导入ElementTree模块
tree = ElementTree.parse('test.xml')  #解析test.xml这个文件,该文件内容如上文
root = tree.getroot()         #得到根元素,Element类
prettyXml(root, '\t', '\n')      #执行美化方法
ElementTree.dump(root)         #显示出美化后的XML内容
执行上述代码后的输出结果如下:
<root>
  <aa>
    aatext
    <cc>cctext</cc>
  </aa>
  <bb>
    bbtext
    <dd>
      ddtext
      <ee>eetext</ee>
    </dd>
  </bb>
</root>
该方法仍存在以下遗留问题:
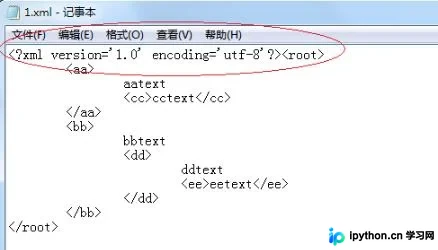
Windows 系统下的换行符为 "\r\n",只需将 prettyXml 方法的第三个参数调整为 "\r\n",使用记事本打开生成的 XML 文件基本正常。
然而,XML 声明与根元素开始符之间如何插入 "\r\n" 尚未解决。
补充知识:Python xml 模块生成 XML 文档
一、XML 模块概述
XML(可扩展标记语言)是一种通过标签组织数据的语言,允许自定义文档结构。相比 JSON,XML 的应用场景更广泛,但语法格式更为复杂。
在前后台数据交互场景中,推荐使用 JSON 格式。
当需要自定义文档结构时(例如 Java 中常使用 XML 作为配置文件),通常由程序读取配置信息,而修改、增加或删除操作多由用户手动完成。
XML 中的组件通常被称为 node(节点)、element(元素)或 tag(标签)。
示例需求:从 countrys 数据中获取所有国家名称。
==========================>countrys
<data>
  <country name="Liechtenstein">
    <rank updated="yes">2</rank>
    <year>2009</year>
    <gdppc>141100</gdppc>
    <neighbor direction="E" name="Austria" />
    <neighbor direction="W" name="Switzerland" />
  </country>
  <country name="Singapore">
    <rank updated="yes">5</rank>
    <year>2012</year>
    <gdppc>59900</gdppc>
    <neighbor direction="N" name="Malaysia" />
  </country>
  <country name="Panama">
    <rank updated="yes">69</rank>
    <year>2012</year>
    <gdppc>13600</gdppc>
    <neighbor direction="W" name="Costa Rica" />
    <neighbor direction="E" name="Colombia" />
  </country>
</data># 取别名可以用于简化书写
import xml.etree.ElementTree as ET
tree = ET.parse('countrys')
#获取根标签#第一种获取标签的方式
#全文查找
iter()
# 获取迭代器 如果不指定参数 则迭代器迭代的是所有标签
print(root.iter())
# 获取迭代器 如果指定参数 则迭代器迭代的是所有名称匹配的标签
for e in root.iter("rank"):
  print(e)

#第二种获取标签的方式
#在当前标签下(所有子级标签)寻找第一个名称匹配的标签
print(root.find("rank")) #第一个名称不匹配所以返回None#第三种获取标签的方式
#在当前标签下(所有子级标签)寻找所有名称匹配的标签
print(root.findall("rank")) #[]
练习题:定位新加坡(Singapore)中的 year 标签。
#print(e.tag) #标签名称
#print(e.attrib) #属性 字典类型
#print(e.text) #文本内容import xml.etree.ElementTree as ETtree = ET.parse("countrys")
# 获取根标签
root = tree.getroot()
for e in root.iter("country"):
  if e.attrib["name"] == "Singapore":
    y = e.find("year")
    print(y.text) #2012
在程序中修改文档内容:将所有 year 标签的文本值加 1。
import xml.etree.ElementTree as ETtree = ET.parse("countrys")
root = tree.getroot()
for e in root.iter("year"):
  e.text = str(int(e.text) + 1)

#做完修改后要将修改后的内容写入文件
tree.write('countrys')
删除新加坡国家节点:
import xml.etree.ElementTree as ETtree = ET.parse("countrys")
root = tree.getroot()for e in root.findall("country"):
  print(e)
  if e.attrib["name"] == "Singapore":
    #删除时要通过被删除的父级标签来删除
    root.remove(e)tree.write('countrys')
通过程序将中国信息写入文档:
import xml.etree.ElementTree as ETtree = ET.parse("countrys")
root = tree.getroot()
#添加时也需要将要添加的数据做成一个Element
c = ET.Element("country",{"name":"china"})# 在国家下有一堆子标签
ranke = ET.Element("ranke",{"updated":"yes"})
c.append(ranke)year = ET.Element("year")
year.text = "2018"
c.append(year)#添加到root标签中
root.append(c)
tree.write("countrys")
总结:通常不建议通过程序直接修改、删除或添加 XML 节点,这类操作多由用户手动完成。
何时应使用 XML 格式:
当需要自定义文档结构时(这是 XML 的核心优势),应优先选择 XML。
前后台数据交互不应使用 XML,而应使用 JSON 格式。
代码生成 XML 文档示例:
import xml.etree.ElementTree as ET# 创建根标签
root = ET.Element("root")
root.text = "这是一个XML文档!"c = ET.Element("country",{"name":"china"})
root.append(c)tree = ET.ElementTree(root)
# 参数: 文件名称 编码方式 是否需要文档声明
tree.write("new.xml",encoding="utf-8",xml_declaration=True)=========================>new.xml 内容为
<?xml version='1.0' encoding='utf-8'?>
<root>这是一个XML文档!<country name="china" /></root>
以上关于 Python 使用 ElementTree 美化 XML 格式的操作即为全部内容,希望能提供参考,并欢迎大家支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















