


Python+Selenium实现自动化百度搜索关键词

发布时间:2026-10-13 |
2人浏览过
本文介绍如何利用Python配合Selenium库实现自动化打开Chrome浏览器进行百度关键词搜索。内容涵盖Python及Selenium的安装、chromedriver的配置、爬虫代理接口的获取,以及包含IP池管理的完整自动化搜索代码示例与运行效果。
Python Selenium自动化搜索实现
利用Python结合爬虫接口与Selenium库,可以实现自动化启动Chrome浏览器,并执行百度关键词搜索操作。
环境配置与依赖安装
第一步,安装Python 3。访问Python官网选择对应系统版本进行安装,当前最新版本为3.7。
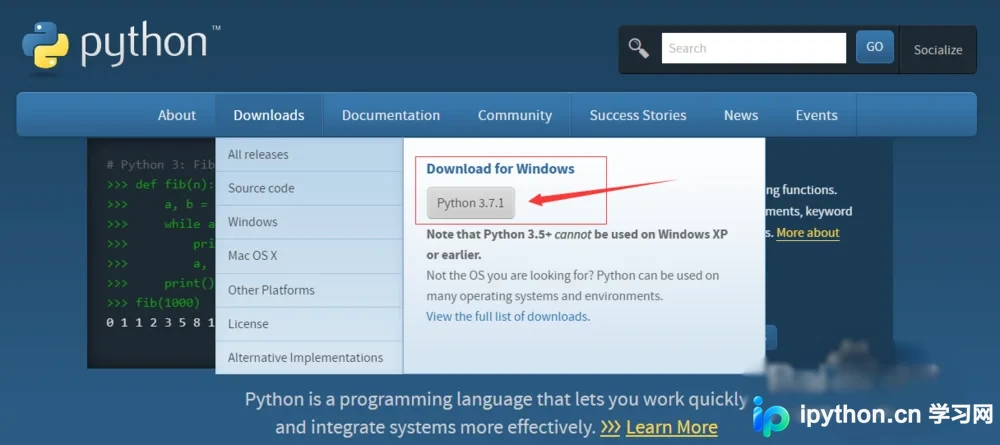
第二步,安装Selenium库。
通过执行命令 pip install selenium 即可完成安装。
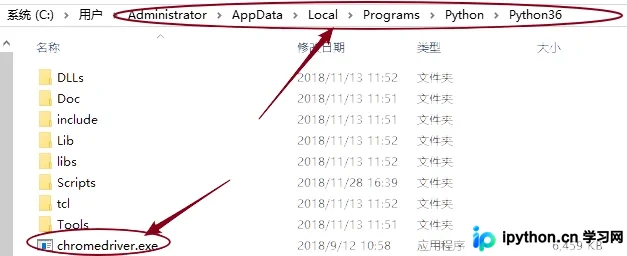
同时需下载chromedriver驱动,并将其放置在Python安装目录下,具体位置参考图示。
爬虫代理接口获取
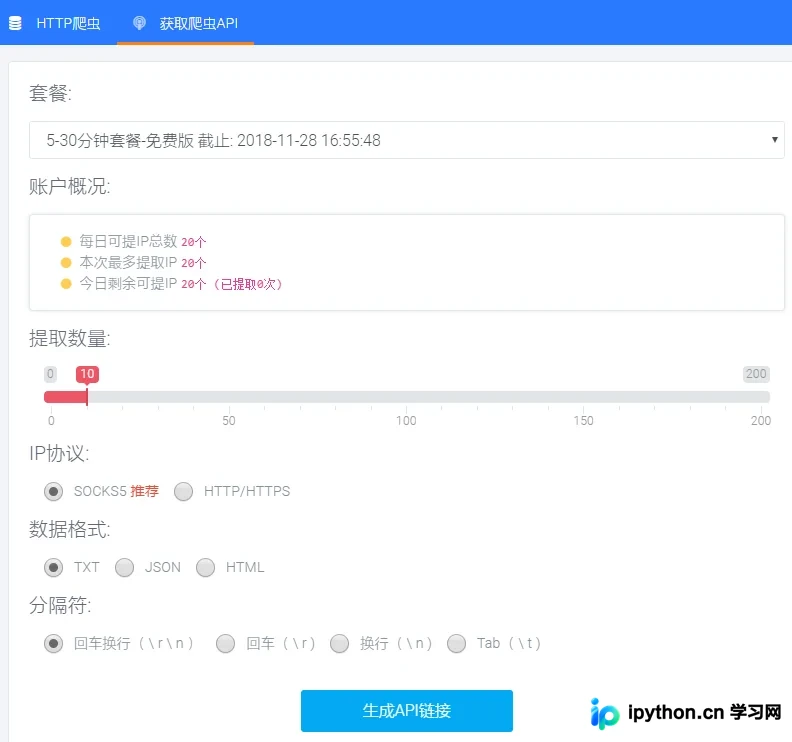
第三步,获取爬虫代理接口链接。
注册相关账号,点击爬虫代理选项,即可领取每日试用额度。
from selenium import webdriver

import requests,time

 #自建IP池

def get_proxy():

  r = requests.get('http://127.0.0.1:5555/random')

  return r.text

import random

FILE = './tuziip.txt'

# 读取的txt文件路径

# 获取代理IP

def proxy_ip():

  ip_list = []

  with open(FILE, 'r') as f:

    while True:

      line = f.readline()

      if not line:

        break

      ip_list.append(line.strip())

  ip_port = random.choice(ip_list)

  return ip_port

def bd():

  chromeOptions = webdriver.ChromeOptions()

  # 设置代理

chromeOptions.add_argument("--proxy-server=http://"+proxy_ip())

# 一定要注意,=两边不能有空格,不能是这样--proxy-server = http://202.20.16.82:10152

  browser = webdriver.Chrome(chrome_options = chromeOptions)

# 查看本机ip,查看代理是否起作用

  browser.get("https://www.baidu.com/")

  browser.find_element_by_id("kw").send_keys("ip")

  browser.find_element_by_id("su").click()

  time.sleep(2)

  browser.find_element_by_id("kw").clear()

  time.sleep(1)

  browser.find_element_by_id("kw").send_keys("百度")

  browser.find_element_by_id("su").click()

  time.sleep(2)

  browser.find_element_by_id("kw").clear()

  time.sleep(1)

  browser.find_element_by_id("kw").send_keys("百度")

  browser.find_element_by_id("su").click()

  time.sleep(2)

  browser.find_element_by_id("kw").clear()

  time.sleep(1)

  browser.close()

# 退出,清除浏览器缓存

  browser.quit()

if __name__ == "__main__":

  while True:

    bd()
程序运行与效果
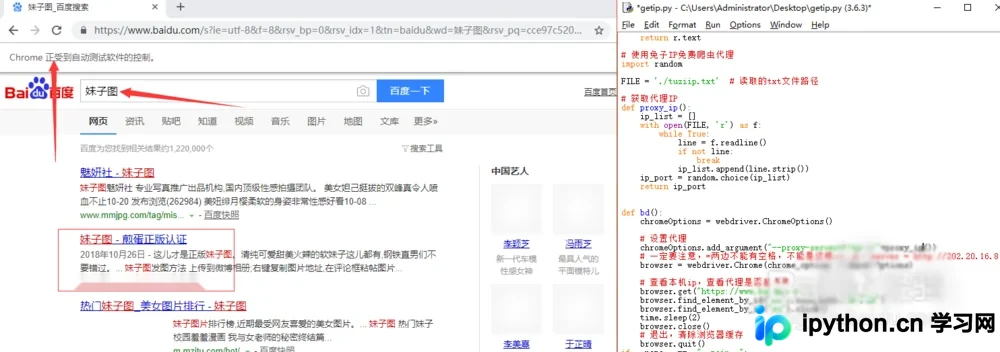
第五步,运行程序。执行上述代码后,如示例截图所示,即可实现自动化搜索功能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















