


Python高效处理超大二进制浮点数据:从struct解析到split切割

本文详解Python中利用struct包将二进制文件转换为浮点数的方法。针对小文件,演示一次性读取并reshape为矩阵;针对38.1G超大文件,提出结合Linux split命令按大小切割文件,再通过Python循环逐块使用struct.unpack解析并保存为.npy格式的高效处理方案,解决内存溢出问题。
本文运行环境基于以下配置:
Python 3.6.5 |Anaconda custom (64-bit)|
引言与基础环境
引言
在实际开发中,有时需要直接读取二进制文件。Python标准库中的struct包是处理此类任务的核心工具,其主要方法包括unpack、pack和calcsize。具体用法可参考Python Struct官方文档。本文将重点探讨如何将二进制数据转换为浮点数。
在Python中,一个float类型的数据占用4个字节。
将二进制数据转换为float类型,可以使用struct.unpack()函数来实现。
小文件读取与struct.unpack应用
小文件读取策略
对于体积较小的文件,可以直接一次性读取全部内容。
首先,需要导入必要的库:
import numpy as np
import struct
Python
假设需要读取一个名为filename的文件,该文件存储了形状为[100,1025]的浮点数数据。可以采用以下代码实现:
# 加载测试数据
f = open('filename','rb')
# 102500为文档中包含的数字个数,而一个浮点数占4个字节
data_raw = struct.unpack('f'*102500,f.read(4*102500))
f.close()
verify_data = np.asarray(verify_data_raw).reshape(-1,1025)
超大二进制文件切割与批量处理方案
大文件处理策略
当需要处理的数据量极大时,例如文件大小达到38.1G,且存储了形状为[10000000,1025]的向量数据。
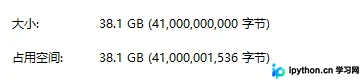
参考网上的一些文章,发现直接转换大二进制文件为浮点数的方法往往无法有效处理此类规模的数据。
因此,这里介绍一种替代方案:
利用Linux命令对文件进行切割
使用split命令将38.1G的大文件按照指定的大小进行分割。
split -b 820000k -a 2 filename data_ 上述代码的含义是:指定每个分割块的大小为820000k,-a 2参数表示文件名后缀使用2位数字命名,'data_'作为文件名的前缀。
最终生成49个文件(按字典序从aa到bw),其中前48个文件每个包含204800行数据,最后一个文件包含169600行数据。
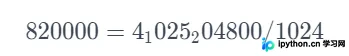
通过Python循环读取分割后的文件
首先构建用于生成文件名的词汇表:
voc = ['a','b','c','d','e','f','g','h','i','j','k','l',
'm','n','o','p','q','r','s','t','u','v','w','x',
'y','z']
voc_short = ['a','b','c','d','e','f','g','h','i','j','k','l',
'm','n','o','p','q','r','s','t','u','v']
为了便于后续处理,将分割后的49个二进制文件转换为Numpy专用的二进制格式*.npy。
for i in voc:
data_name = 'data_a'+str(i)
f = open(data_name,'rb')
data_raw = struct.unpack('f'*209920000,f.read(4*209920000))
f.close()
data = np.asarray(data_raw).reshape(-1,1025)
np.save(data_name+'.npy',data) # 保存data_a*.npy文件
for i in voc_short:
data_name = 'data_b'+str(i)
f = open(data_name,'rb')
data_raw = struct.unpack('f'*209920000,f.read(4*209920000))
f.close()
data = np.asarray(data_raw).reshape(-1,1025)
np.save(data_name+'.npy',data) # 保存data_b*.npy文件
data_name = 'data_bw'
f = open(data_name,'rb')
data_raw = struct.unpack('f'*173840000,f.read(4*173840000))
np.save(data_name+'.npy',data_raw) # 保存data_bw.npy文件
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















