



写 Go 程序时,很多人第一次接触严重错误处理,都会把 log.Panic 和 log.Fatal 当成“都会退出程序”的两个近义写法。真正到排查启动失败、资源没释放、defer 没执行这类问题时,差别就会变得非常实际。下面按行为机制、使用场景和工程实践拆开讲清楚,帮助你判断什么时候该给调用方恢复机会,什么时候才该直接结束进程。
先看结论:两者都中断流程,但退出机制不同
先看一个最直接的例子:
package main
import "log"

func main() {
    // log.Panic示例
    log.Panic("这是一个Panic错误")

    // log.Fatal示例
    log.Fatal("这是一个Fatal错误")
}
只看表面,这两个函数都会先输出日志,再让程序停下来。但它们停下来的方式并不一样:
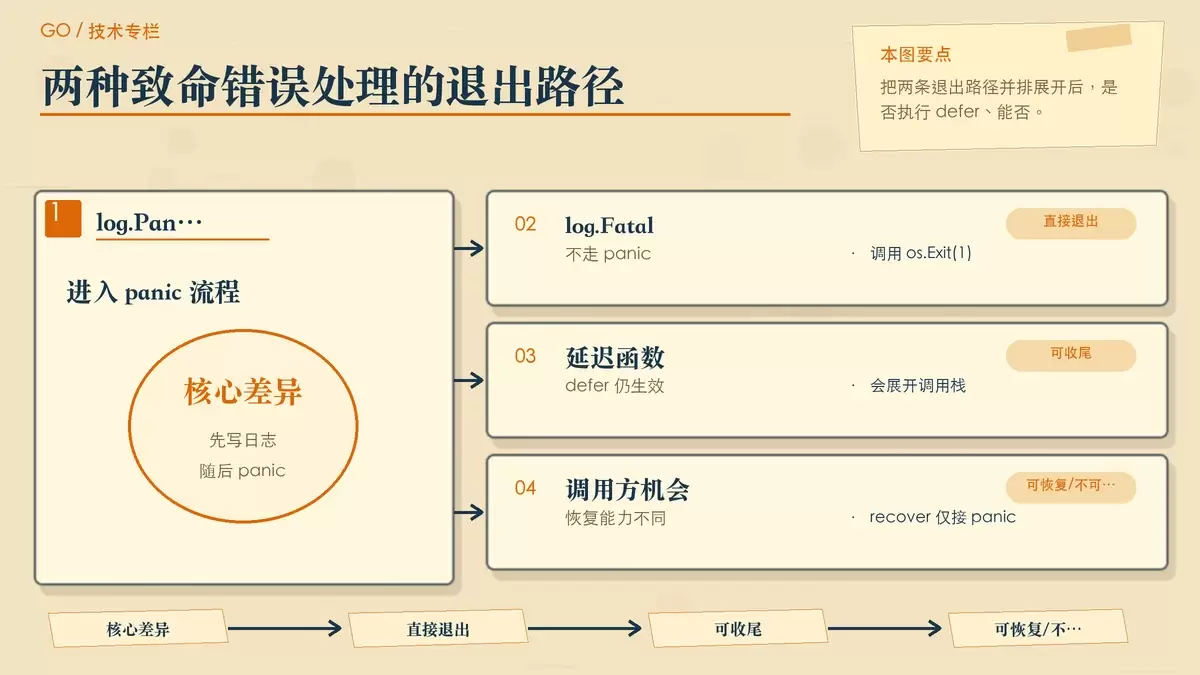
log.Panic会在写日志后调用panic()log.Fatal会在写日志后直接调用os.Exit(1)
这也是后续所有差异的来源。前者进入 Go 的恐慌机制,后者则是立刻结束进程。是否还能执行 defer、是否有机会用 recover() 接住错误,都由这里决定。
log.Panic 做了什么:会触发 panic,也可能被恢复
调用后的执行路径
当代码调用 log.Panic 时,通常会发生下面几步:
- 先把错误信息写入日志
- 调用
panic()触发恐慌 - 开始按当前 goroutine 的调用栈展开,执行已经注册的
defer - 如果没有被
recover()捕获,最终打印堆栈并退出程序
这意味着,log.Panic 并不只是“报错退出”,它会把程序带入一条可观察、可回收、可调试的异常路径。
defer 和 recover 会生效
下面这段代码最能说明它的行为:
package main
import "log"

func main() {
    defer func() {
        if err := recover(); err != nil {
            log.Println("捕获到panic:", err)
        }
    }()

    log.Panic("触发panic")
}
这里的 recover() 成功接住了 panic,所以程序不会按照“未处理 panic”那条路径直接崩掉。换句话说,log.Panic 给了上层或延迟函数一个介入处理的机会。
这也是它适合用于调试、边界保护、框架内部保护层等场景的原因。你不仅能记录错误,还能保留更多上下文,必要时继续做补救或收尾。
log.Fatal 为什么更决绝:直接 os.Exit(1)
它不会进入 panic 流程
log.Fatal 的处理路径短得多,也更强硬:
- 先记录错误日志
- 立即调用
os.Exit(1) - 进程直接结束,不会执行任何 defer
也就是说,它不是抛出一个可被恢复的异常,而是直接结束整个进程生命周期。
defer 不会执行
看下面这段代码:
package main
import "log"

func main() {
    defer func() {
        log.Println("这行不会被执行")
    }()

    log.Fatal("致命错误")
}结果很明确:defer 中的日志不会打印。因为程序已经被 os.Exit(1) 直接终止,Go 运行时没有机会再去展开调用栈,更谈不上 recover()。
这也是很多线上问题的根源之一。开发者本来以为退出前会自动关闭连接、刷新缓冲区、释放句柄,结果由于用了 log.Fatal,清理逻辑根本没有执行。
怎么选:看错误是否需要恢复和清理
适合使用 log.Panic 的情况
如果你希望错误还能被更上层感知、记录或接管,log.Panic 更合适,常见情况包括:
- 错误有恢复空间:调用方可能决定兜底处理,而不是立刻结束整个程序
- 需要堆栈信息:排查问题时,希望得到更完整的调用路径
- 项目本身使用 panic/recover 机制:例如某些框架边界层会统一 recover,再转成错误响应或统一日志
不过这里要强调一点,panic 本身仍然不是常规错误处理手段。能正常返回 error 的地方,优先还是应该返回 error。
适合使用 log.Fatal 的情况
如果程序已经不具备继续运行的前提,而且退出前也不依赖当前栈上的清理逻辑,那么 log.Fatal 才比较合理:
- 不可恢复的致命错误:程序继续跑下去只会产生更大问题
- 启动阶段失败:例如配置缺失、关键依赖初始化失败,应用根本无法进入工作状态
- 明确需要立刻终止:并且你已经接受不会执行
defer这一后果
因此,它更像是一种“最后的退出动作”,而不是日常业务逻辑里随手可用的错误处理方式。
工程里更稳妥的写法:尽量返回 error,把退出留在 main
在实际项目中,很多人会在底层函数里直接调用 log.Fatal,这样写虽然省事,但代价很大:函数失去复用性,调用方无法决定如何处理错误,资源清理也可能被绕过。
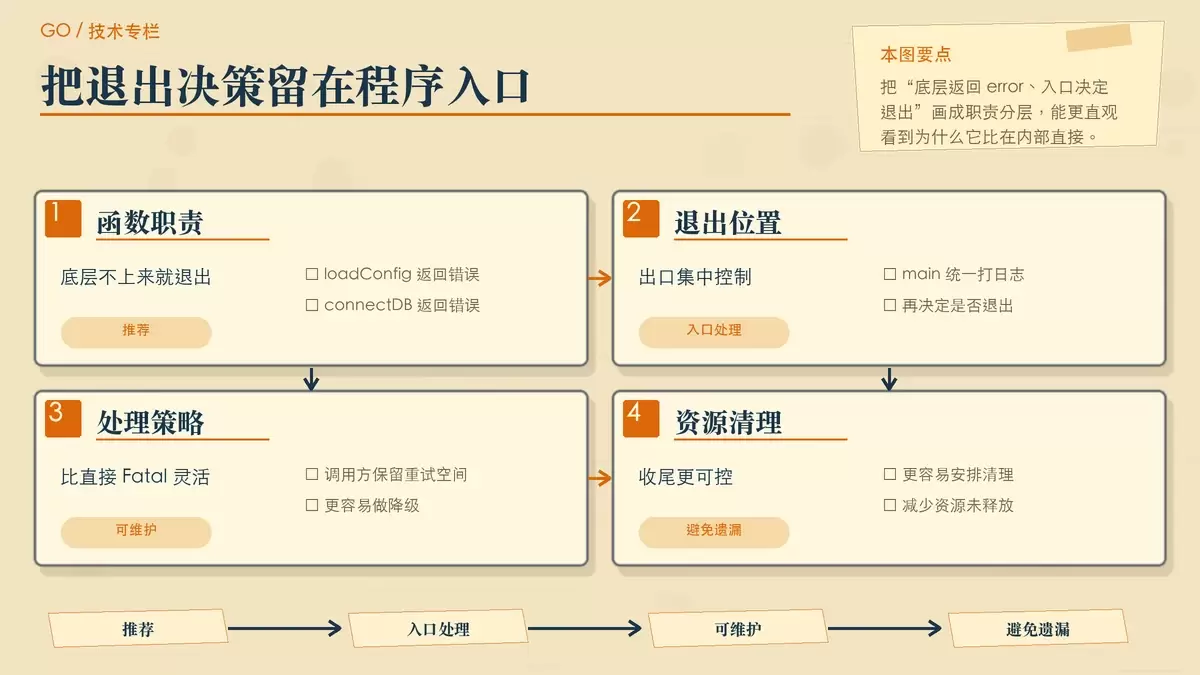
更稳妥的方式通常是:底层函数返回 error,由 main 或进程入口统一决定记录日志、清理资源以及最终是否退出。原文里的这段示例就更接近工程实践:
// 良好的实践示例
func initializeApp() error {
    if err := loadConfig(); err != nil {
        return fmt.Errorf("配置加载失败: %w", err)
    }

    if err := connectDB(); err != nil {
        return fmt.Errorf("数据库连接失败: %w", err)
    }

    return nil
}

func main() {
    if err := initializeApp(); err != nil {
        log.Printf("程序启动失败: %v", err)
        // 可以选择记录日志后优雅退出
        os.Exit(1)
    }

    // 应用程序主循环
    // ...
}
这种写法有几个明显好处:
- 初始化逻辑和进程退出逻辑分离,职责更清楚
- 调用方保留了决定权,可以选择重试、降级或退出
- 退出前如果还有额外清理动作,也更容易安排
所以从可维护性来看,真正值得优先考虑的顺序通常是:先返回 error;确实无法继续时,再在入口处决定是否 os.Exit(1);只有在非常明确的异常语义下,才考虑 panic 或 log.Panic。
最后记一个实用判断标准
log.Panic 和 log.Fatal 都能处理严重错误,但它们服务的是两种完全不同的退出策略。
- 如果你希望调用方还有机会恢复、记录更多上下文、执行
defer,选log.Panic - 如果错误已经无法挽回,程序也不需要继续清理当前调用栈上的资源,才考虑
log.Fatal
一句话概括就是:想保留恢复和收尾能力,用 log.Panic;确认只能立刻结束进程,再用 log.Fatal。把这条边界分清楚,Go 程序的错误处理会稳很多。















