



写 Go 时,数组和切片几乎都会遇到,但很多初学者真正踩坑,往往不是语法不会写,而是没弄清它们在类型、复制行为和底层共享上的差别。本文按“先理解本质,再看扩容与避坑,最后给选择建议”的顺序梳理一遍,帮你在实际开发里判断什么时候该用数组,什么时候更适合切片。
先分清:数组是固定值,切片是动态视图
数组和切片看起来都像“存一组数据”,但设计目标并不一样。
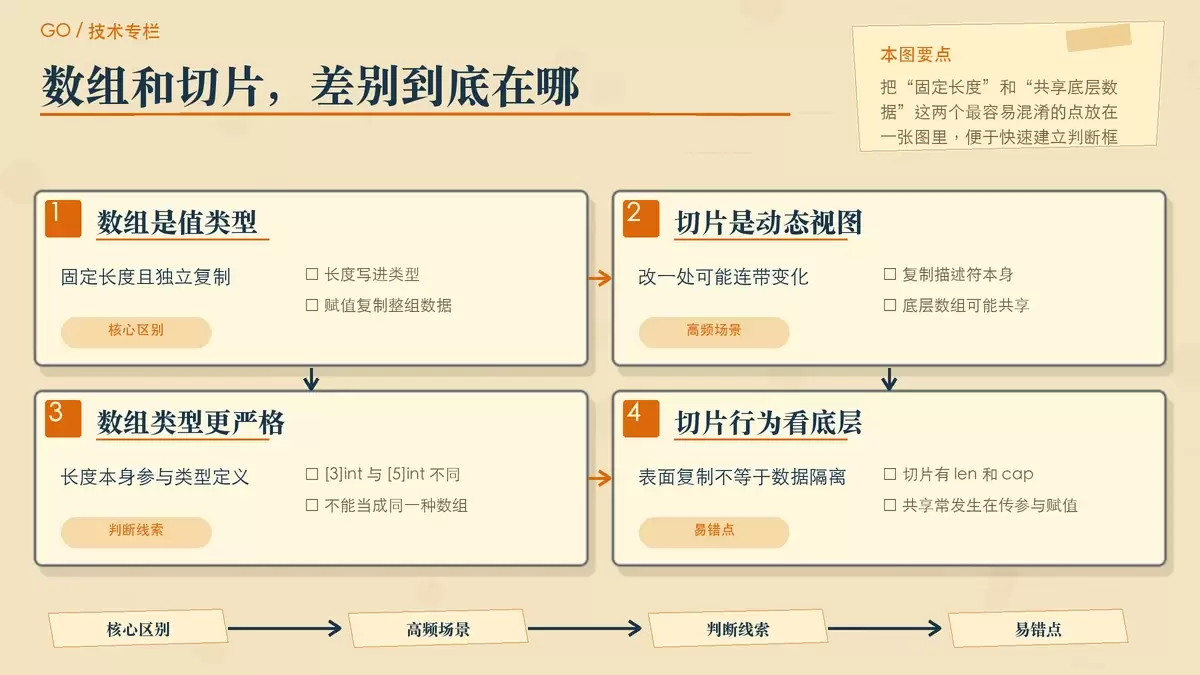
数组适合固定长度的数据集合。一旦创建,长度不能改变,而且长度本身就是类型的一部分:
// 数组声明示例
var arr1 [3]int          // 声明长度为3的int数组
arr2 := [3]int{1, 2, 3}  // 声明并初始化
arr3 := [...]int{1,2,3} // 编译器推导长度这里最容易忽略的一点是,[3]int 和 [5]int 在 Go 中是两种不同类型,因此不能直接互相赋值,也不能按同一种数组来看待。
切片则是建立在底层数组之上的动态视图,更适合长度不确定、需要后续扩展的数据:
// 切片声明示例
var s1 []int              // 未初始化的切片(nil切片)
s2 := make([]int, 3)      // 长度和容量都为3的切片
s3 := []int{1, 2, 3}      // 声明并初始化
切片没有把长度写进类型里,因此使用上更灵活。日常业务代码中,大多数“列表型”数据最终都会落到切片上,而不是数组。
真正影响代码行为的核心:复制的是数据,还是描述符
数组和切片最关键的区别,不在“能不能装数据”,而在赋值和传参时到底复制了什么。
数组是值类型,赋值和传参都会完整复制
数组变量本身就代表整组数据,所以把一个数组赋值给另一个变量,或者传入函数时,复制的是整个数组内容:
func main() {
    arr1 := [3]int{1, 2, 3}
    arr2 := arr1          // 整个数组被复制
    arr2[0] = 100         // 只修改arr2,不影响arr1
    fmt.Println(arr1)     // [1, 2, 3]
    fmt.Println(arr2)     // [100, 2, 3]
}
这意味着数组天然具备值语义。你拿到的是一份独立副本,改副本不会波及原值。这种特性在需要固定结构、明确边界的数据场景里很有用。
切片是引用类型,复制后通常仍共享底层数据
切片本身并不是完整数据集合,而是一个描述符,通常包含三部分:
- 指针:指向底层数组的起始位置
- 长度:当前切片里有多少元素
- 容量:从起始位置开始,到底层数组末尾还能容纳多少元素
因此,切片赋值或作为参数传递时,复制的只是这个描述信息,底层数组仍然可能是同一块内存:
func main() {
    slice1 := []int{1, 2, 3}
    slice2 := slice1       // 只复制切片描述符
    slice2[0] = 100        // 修改会影响两个切片
    fmt.Println(slice1)    // [100, 2, 3]
    fmt.Println(slice2)    // [100, 2, 3]
}
这也是为什么很多 Go 新手会觉得切片“像值传递,又不像值传递”。表面上变量被复制了,实际上底层数据往往还是共享的。只要理解这一层,很多联动修改的问题就不难解释了。
切片为什么更常用:动态扩容和实际场景更匹配
切片在 Go 中用得更多,核心原因不是语法简洁,而是它能处理真实业务里最常见的需求:数据量一开始不确定,后续还可能继续增长。
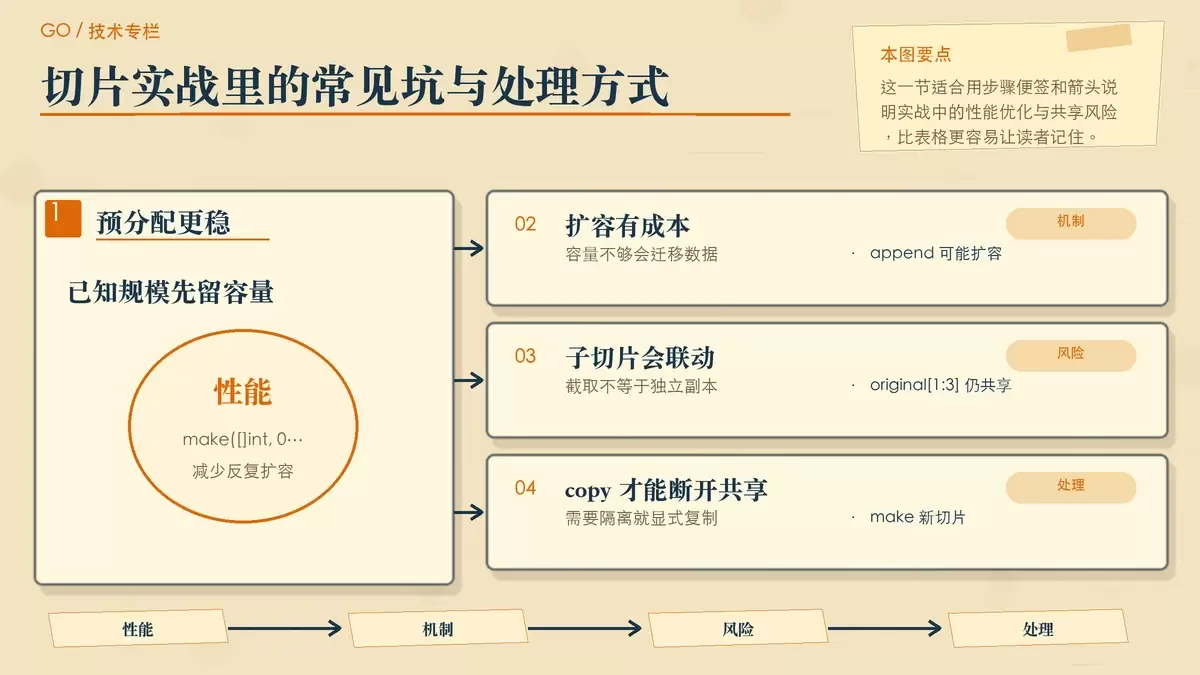
append 会在容量不足时自动扩容
当使用 append 添加元素时,如果当前容量不够,Go 会分配更大的底层数组,并把原有数据迁移过去:
s := []int{1, 2, 3}
fmt.Println(len(s), cap(s)) // 3, 3
s = append(s, 4)           // 触发扩容
fmt.Println(len(s), cap(s)) // 4, 6(通常2倍扩容)
常见扩容策略是:容量小于 1024 时通常翻倍,超过 1024 后一般按 1.25 倍增长。具体实现会随版本和场景调整,但这个经验足够帮助你理解性能变化。
什么时候优先考虑数组
- 数据长度在编译时就确定,比如颜色值
[3]byte - 需要严格控制内存布局,比如和 C 语言交互
- 需要值语义,希望赋值后就是一份独立副本
什么时候默认使用切片
- 数据数量不固定,这是最常见的情况
- 需要频繁追加、裁剪或组织动态集合
- 作为函数参数传递,希望减少大块数据复制
- 实现队列、栈等动态数据结构
如果只是写普通业务逻辑,经验上可以先把切片当默认选项;只有在“固定长度”和“值语义”都很明确时,再回头考虑数组。
实战里最容易踩的 3 个坑
理解概念之后,真正拉开差距的是对细节的处理。下面这几个问题,在 Go 项目里非常常见。
预分配容量,减少反复扩容
如果你大致知道最终会放多少数据,最好提前分配容量,避免在循环里不断触发扩容和复制:
// 低效方式
var s []int
for i := 0; i < 1000; i++ {
    s = append(s, i)
}

// 高效方式
s := make([]int, 0, 1000) // 预分配容量
for i := 0; i < 1000; i++ {
    s = append(s, i)
}
这类优化不一定每次都要做,但在高频循环、批量构造结果集、日志聚合或数据处理中,通常能减少额外内存分配。
子切片可能和原数据共享底层数组
切片最常见的坑之一,就是看起来“截出来一段”,其实底层仍然连着原数组:
original := []int{1,2,3,4,5}
subSlice := original[1:3]    // [2,3]
subSlice[0] = 99             // 会影响original!
fmt.Println(original)        // [1,99,3,4,5]
如果你需要一份独立数据,就不要只做切片表达式,而是用 copy 明确复制:
subSlice := make([]int, 2)
copy(subSlice, original[1:3]) // 独立复制数据
subSlice[0] = 99              // 不影响original
这个区别在函数返回局部结果、缓存局部视图、处理并发读写时尤其重要。很多“数据怎么被改了”的问题,最后都能追到这里。
空切片和 nil 切片不是一回事
两者都能表示“当前没有元素”,但语义上并不完全相同:
var nilSlice []int        // nil切片,未指向任何底层数组
emptySlice := []int{}     // 空切片,有底层数组但为空

fmt.Println(nilSlice == nil)   // true
fmt.Println(emptySlice == nil) // false
通常可以这样理解:
- 返回错误或尚未得到结果时,返回
nil切片更自然 - 需要表达“结果存在,但为空集合”时,使用空切片更清晰
在接口返回值、JSON 编码结果和调用约定上,这个细节经常会影响上层逻辑,因此最好在项目里保持一致风格。
最后怎么选:一个够用的判断规则
如果把两者放在一起看,可以抓住几条最实用的结论:
| 特性 | 数组 | 切片 |
|---|---|---|
| 长度 | 固定,类型一部分 | 动态可变 |
| 内存分配 | 直接存储数据 | 存储描述符+底层数组 |
| 传递行为 | 值传递,完整复制 | 引用传递,共享底层数组 |
| 容量概念 | 无 | 有,可自动扩容 |
| 使用场景 | 固定大小数据 | 动态大小数据 |
对大多数 Go 开发者来说,默认优先使用切片,通常是更贴近实际开发的选择。只有当你明确需要固定大小、稳定内存布局,或者就是要值语义带来的独立副本时,再使用数组会更合适。
简化成一句经验法则就是:大小不确定,用切片;需要精确控制和独立值语义,用数组。 只要记住这条,再结合上面的共享、扩容和复制规则,日常编码里基本就不容易选错。















