



在 Go 并发开发里,goroutine 很容易把任务拆开执行,但异常处理也会随之变得不直观。很多人第一次遇到“子协程 panic,主协程 recover 抓不到”时,往往会误以为是写法问题;实际上,关键在于 panic/recover 的作用范围只限于当前 goroutine。下面从复现代码、运行机制到可落地的处理方式,逐步说明为什么会这样,以及实际项目里该怎么兜住这类异常。
先看现象:主协程的 recover 为什么没生效
先看这段最常见的复现代码:
package main

import (
    "fmt"
    "time"
)

func main() {
    defer func() {
        if r := recover(); r != nil {
            fmt.Println("主协程捕获到panic:", r)
        }
    }()

    go func() {
        fmt.Println("子协程开始执行")
        panic("子协程发生panic了!")
    }()

    time.Sleep(time.Second)
    fmt.Println("程序结束")
}
直觉上,很多人会觉得主协程已经放了 defer + recover,子协程里即使出现 panic,也应该能被接住。但实际运行时,主协程里的 recover 并不会捕获到这个异常,程序仍然会崩溃退出。
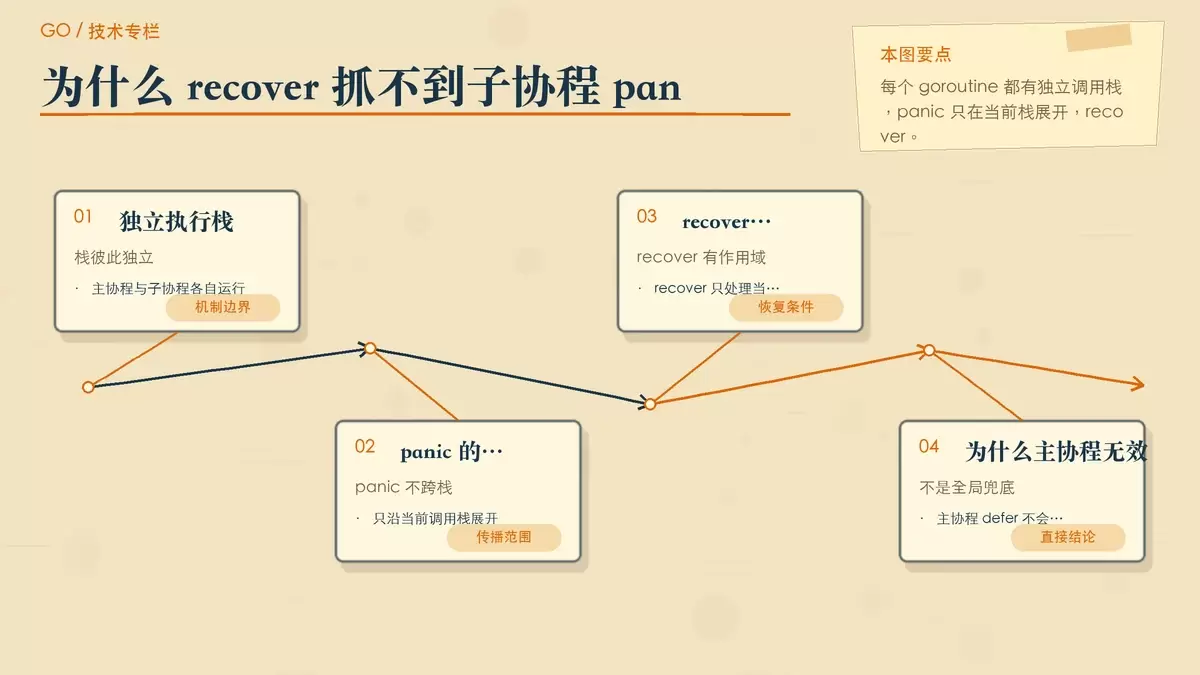
这里最容易忽略的一点是:recover 不是一个全局异常捕获器,它并不会替你兜住整个进程里所有 goroutine 的 panic。它只能处理当前调用栈上正在展开的那次 panic。
根本原因:goroutine 之间的调用栈彼此隔离
这个问题的核心,其实可以归结为两条规则。
每个 goroutine 都有独立的执行栈
Go 中的每个 goroutine 都是独立的执行单元,拥有自己的调用栈和上下文。主协程和子协程虽然运行在同一个进程中,但它们不是共用一条函数调用链。
panic 只会沿当前 goroutine 的栈向上展开
当某个 goroutine 调用了 panic(),Go 运行时只会在这个 goroutine 自己的调用栈里,按层级执行已经注册的 defer。而 recover 也只能在这条栈上生效,无法跨 goroutine 去处理别处发生的异常。
所以,子协程里发生的 panic,不会“冒泡”到主协程的 defer 中;主协程里的 recover 再完整,也接不到另一条执行栈上的异常。
从运行时机制看:recover 为什么不能跨协程工作
如果从 Go 的底层实现去看,这个边界会更清楚。
当代码调用 panic() 时,Go 运行时会创建一个 _panic 数据结构,并把它挂到当前 goroutine 上。随后,程序开始沿着当前 goroutine 的调用栈逐层执行 defer。
recover() 做的事情并不复杂,本质上是读取当前 goroutine 的 _panic 状态,并把这次 panic 标记为已恢复。因此,它天然只能处理“当前 goroutine 身上挂着的那次 panic”,没法去访问别的 goroutine 的异常状态。
// gorecover的内部实现简化的逻辑
func gorecover(argp uintptr) interface{} {
    gp := getg() // 获取当前goroutine
    p := gp._panic // 获取当前goroutine的panic结构

    if p != nil && !p.recovered && argp == uintptr(p.argp) {
        p.recovered = true // 仅标记当前goroutine的panic为已恢复
        return p.arg
    }
    return nil
}这段简化逻辑已经说明问题:getg() 拿到的是“当前 goroutine”,后续读取和恢复的也是这个 goroutine 上的 _panic。因此,所谓“主协程 recover 子协程 panic”在机制上就不成立。
不只是跨协程:这些场景下 recover 也会失效
除了“子协程 panic,主协程 recover”这种典型误区,recover 还有几种常见失效场景,排查时也要一起考虑。
recover 不在 defer 中调用
recover 只有放在 defer 中调用才有效。普通函数体里直接调用,拿不到正在展开的 panic。
recover 不是在 defer 中直接调用
即使写在 defer 里,如果又套了一层函数间接调用,也可能无法正常恢复。它要求的不是“最终调到了 recover”,而是“在 defer 函数中直接调用 recover”。
某些运行时错误本身不可恢复
文中提到的并发写入 map、内存不足等问题,属于更重的运行时错误场景。遇到这类问题时,不能简单依赖 recover 当作统一兜底,还是要优先从并发模型、资源控制和数据同步上解决。
子协程 panic 怎么处理更稳妥
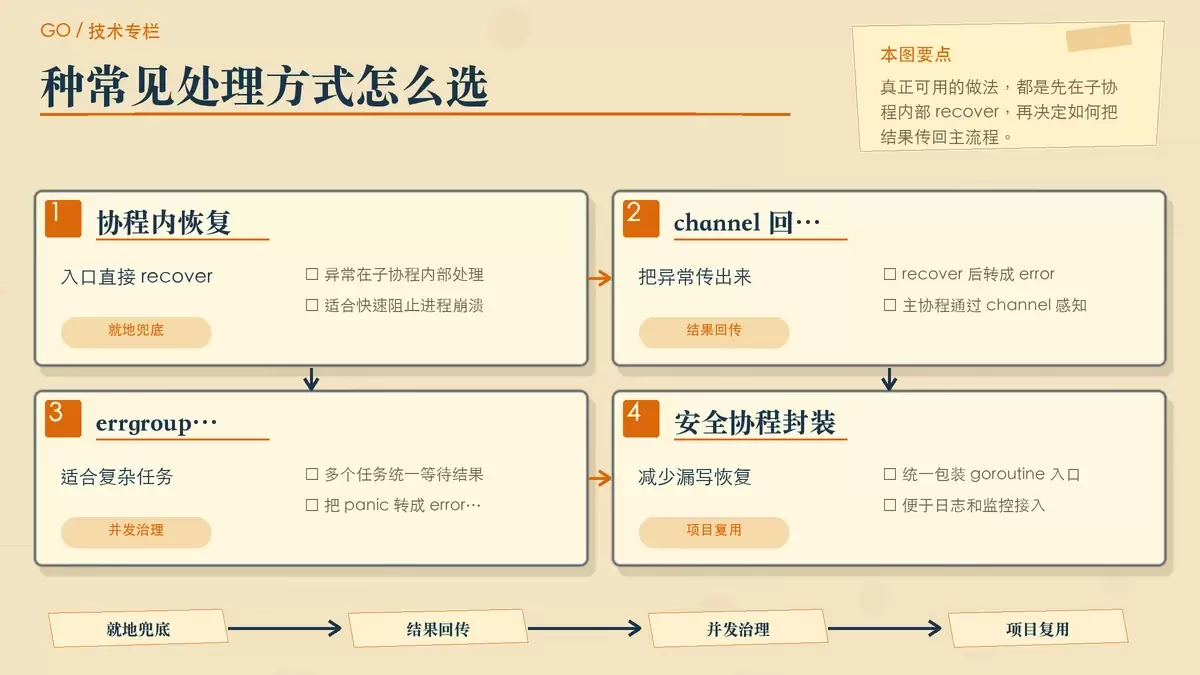
既然 recover 不能跨 goroutine 使用,那就要把异常处理放回子协程自己的入口处。下面几种方式都比较常见,适用范围也不同。
方法一:在子协程内部直接 recover
这是最直接、也最符合机制的一种写法:在哪个 goroutine 里可能发生 panic,就在哪个 goroutine 入口处加上 defer 恢复。
go func() {
    defer func() {
        if r := recover(); r != nil {
            fmt.Println("子协程捕获到panic:", r)
        }
    }()

    // 你的业务逻辑代码
    panic("模拟panic")
}()
这种方式适合快速兜底,至少可以避免某个子协程异常后把整个程序直接带崩。
方法二:通过 channel 把错误传回主协程
如果主协程还需要感知子协程执行结果,仅仅在子协程里打印日志还不够。更常见的做法是:子协程内部先 recover,再把错误包装后通过 channel 传出去。
func main() {
    errCh := make(chan error, 1)

    go func() {
        defer func() {
            if r := recover(); r != nil {
                errCh <- fmt.Errorf("recovered from panic: %v", r)
            }
        }()

        panic("子协程发生panic")
    }()

    err := <-errCh
    if err != nil {
        fmt.Println("接收到错误:", err)
    }
}
这样做的重点不是“让主协程去 recover”,而是把子协程内部已经处理过的异常结果,转成主协程可消费的 error 信号。
方法三:用 errgroup 管理并发任务
并发任务一多,手动维护多个 goroutine、channel 和退出时机就会变得混乱。这个时候,golang.org/x/sync/errgroup 更适合用来统一管理任务结果。
import "golang.org/x/sync/errgroup"

func main() {
    var g errgroup.Group

    g.Go(func() (err error) {
        defer func() {
            if r := recover(); r != nil {
                // 将panic转换为error返回
                err = fmt.Errorf("panic: %v", r)
            }
        }()
        // 业务逻辑
        panic("业务panic")
    })
    if err := g.Wait(); err != nil {
        fmt.Println("执行出错:", err)
    }
}
这里的关键思路是把 panic 转成 error 返回,让上层调用者仍然使用统一的错误处理路径。对于服务端项目来说,这种方式通常比散落的日志输出更容易维护。
方法四:封装统一的安全协程入口
如果项目里经常直接起 goroutine,可以再往前走一步,把“启动协程 + recover + 日志/监控”封装成统一入口,减少重复代码,也降低漏写恢复逻辑的概率。
func GoSafe(fn func()) {
    go func() {
        defer func() {
            if r := recover(); r != nil {
                fmt.Printf("goroutine panic: %vn", r)
                // 这里还可以记录日志、上报监控等
            }
        }()

        fn()
    }()
}

// 使用方式
GoSafe(func() {
    // 你的业务逻辑
})
这种封装适合团队协作环境,尤其是在任务消费、异步回调、定时任务这类容易散落 goroutine 的场景中,更容易把异常兜底、日志记录和监控上报纳入统一规范。
实际开发里更值得遵守的处理原则
理解了机制之后,真正重要的是不要把 panic/recover 当成日常错误处理手段。
预期内错误优先走 error
业务可预期的失败,比如参数不合法、远程调用失败、文件不存在,应该返回 error。panic 更适合表示真正异常、无法继续按正常路径执行的问题。
每个 goroutine 入口都要明确异常策略
凡是独立启动的 goroutine,都应该提前想清楚:这里是否需要 recover,恢复后是记日志、发监控,还是转成 error 通知上层。不要等线上崩溃后再补。
recover 之后要保留足够的排查信息
如果只是简单打印一句“panic 了”,排查价值很有限。至少要把 panic 内容、任务上下文和必要日志保留下来,复杂场景下还应接入监控或告警。
并发共享资源要先解决同步问题
像并发写 map 这类问题,本质上不是“如何 recover 更漂亮”,而是并发访问模型本身有缺陷。该加锁、该改数据结构、该收敛共享状态,就不要寄希望于异常恢复机制兜底。
总结
子协程里的 panic 之所以不能被主协程里的 recover 捕获,根本原因是 Go 的 panic/recover 只在当前 goroutine 的调用栈内生效。每个 goroutine 都有独立的执行栈和异常上下文,异常不会跨栈传播。
因此,正确姿势不是在主协程里写一个“总 recover”,而是在每个可能出问题的 goroutine 入口处主动处理:简单场景就地 recover,需要上报结果就通过 channel 或 errgroup 返回,项目级别则可以封装统一的安全协程入口。把这个边界理解透了,Go 并发程序的稳定性会好很多。















