



在 Go 项目里,`recover()` 常被当作最后一道保险:只要包一层 `defer`,程序似乎就能把异常吞下来继续跑。但遇到 `fatal error: concurrent map read and map write` 时,这套思路会直接失效。本文把 `panic`、`recover` 和 Go 运行时的致命错误拆开说明,再结合 nil map、普通 map 和并发访问的差异,帮助你判断这类问题到底能不能恢复,以及该用什么方式从根上处理。
fatal error: concurrent map read and map writerecover 为什么接不住 map 并发读写错误
一个很常见的误区是:只要用了 recover(),所有异常都能被拦下来。于是有人会在并发访问 map 的代码外层套上这样的逻辑:
defer func() {
    if r := recover(); r != nil {
        fmt.Println("捕获到异常:", r)
    }
}()
// ... 并发操作map的代码
实际结果却不是“打印错误后继续执行”,而是进程照样崩溃。原因不在于 recover() 写法有问题,而在于这类错误压根不属于它能处理的范围。
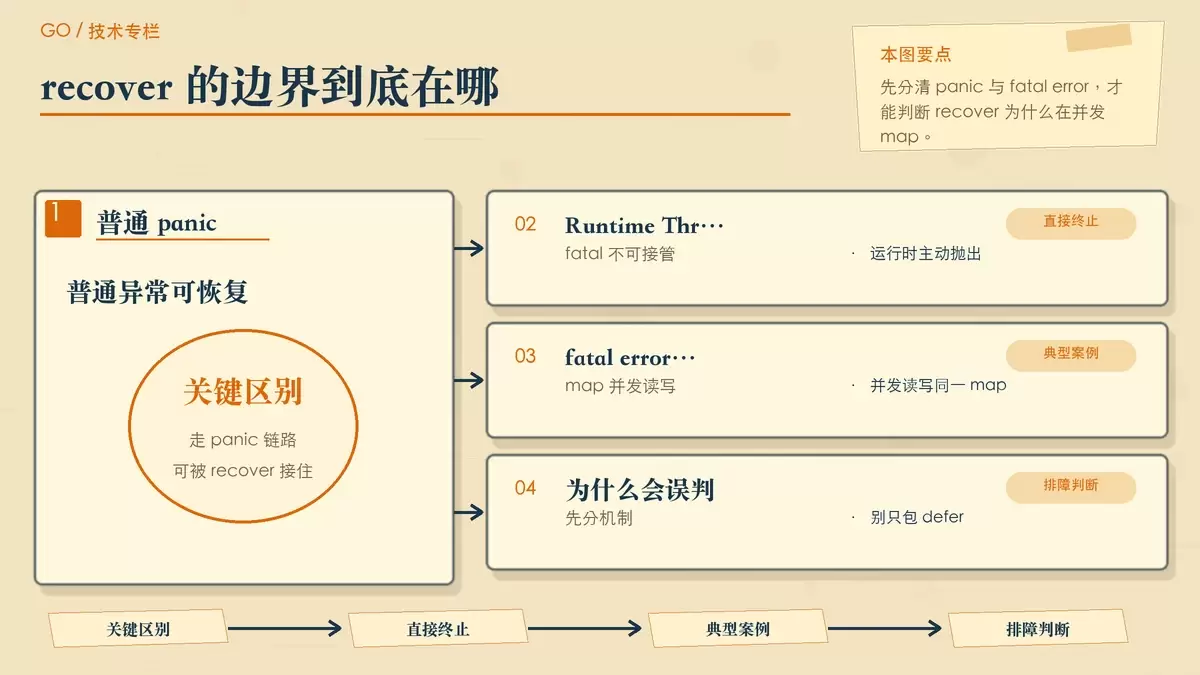
Go 里至少要区分两类会让程序中断的情况:
- 普通 panic:既可能由
panic()主动触发,也可能来自空指针解引用、数组越界等运行时错误。这类情况可以被recover捕获。 - Runtime Throw:这是 Go 运行时抛出的致命错误,通常会以
fatal error的形式出现,不会进入panic/recover这条恢复链路,而是直接终止进程。
map 的并发读写,属于第二类。 也就是说,它不是“可以恢复的 panic”,而是运行时为了阻止更严重后果主动中止程序。
// 这个例子会导致无法恢复的fatal error
m := make(map[int]int)
go func() {
    for i := 0; i < 1000; i++ {
        m[i] = i // 并发写
    }
}()
go func() {
    for i := 0; i < 1000; i++ {
        _ = m[i] // 并发读
    }
}()

// fatal error: concurrent map read and map write
这里的关键不是“读”和“写”哪个更危险,而是多个 goroutine 同时对同一个已初始化 map 做未同步访问。Go 运行时检测到这种状态后,会直接抛出 fatal error,防止 map 内部结构被破坏,进一步引发更隐蔽的数据错误或内存安全问题。
nil map 和已初始化 map,行为为什么不一样
这类问题里最容易混淆的一点,是 nil map 的表现并不完全相同。很多人因此误以为“既然 map 出错有时能 recover,那并发读写也应该可以”,但这其实是两种不同情况。
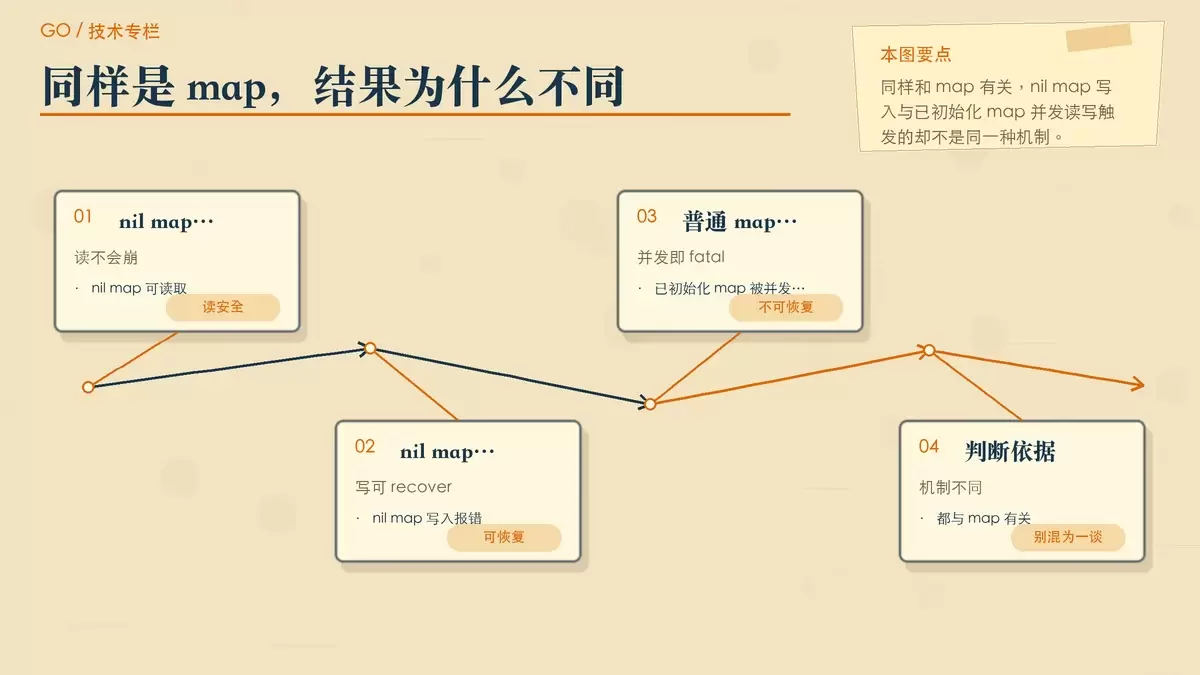
| Map状态 | 读写类型 | 运行时行为 | 是否可recover |
|---|---|---|---|
| nil map | 读 | 安全,返回零值 | 无需recover |
| 写 | 普通 panic | ✅ 可recover | |
| 已初始化map | 并发读写 | Runtime Throw (fatal) | ❌ 不可recover |
其中最值得单独拿出来说的是:向 nil map 写入会触发普通 panic。这类错误确实能被 recover 捕获,因为它走的仍然是 panic 机制。
var nilMap map[int]int // nil map

defer func() {
    if r := recover(); r != nil {
        fmt.Println("捕获到panic:", r) // 这里会执行
    }
}()
nilMap[1] = 100 // 这会触发普通panic,可被recover捕获
所以判断能不能恢复,不能只看“是不是 map 出错”,而要看它触发的是哪种运行时机制。nil map 写入和并发读写都与 map 有关,但一个是普通 panic,一个是 runtime throw,处理方式完全不同。
Go 为什么这样设计,正确解法又是什么
从语言设计角度看,Go 没有把 map 并发读写做成可恢复错误,是一个非常明确的取舍。因为这类问题通常不是单点异常,而是并发模型本身出了错。若允许开发者用 recover 把它吞掉,程序虽然表面还能继续运行,但底层数据状态可能已经不可信,后续问题只会更难定位。
换句话说,Go 在这里强调的是:尽早暴露并发 bug,而不是把它包装成“还能继续处理的异常”。
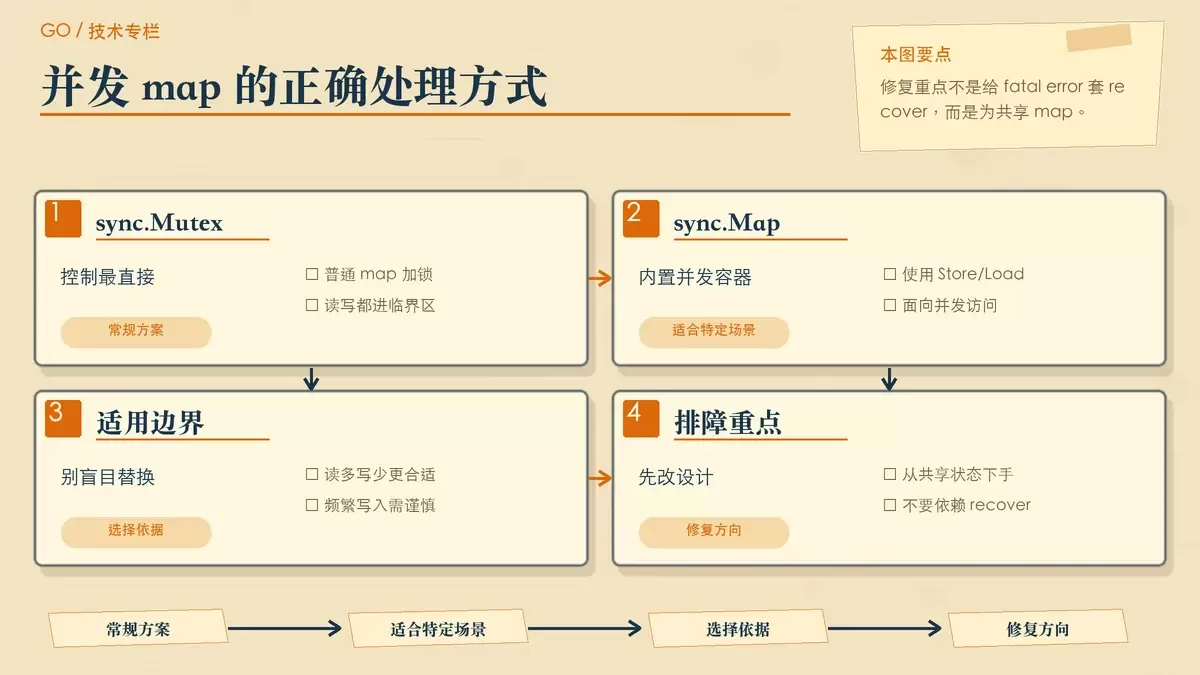
真正需要解决的,不是“怎么把 fatal error 接住”,而是“怎么避免 map 在并发下失控”。常见做法有两种。
使用互斥锁保护普通 map
var m = make(map[int]int)
var mu sync.Mutex

// 写操作
mu.Lock()
m[key] = value
mu.Unlock()

// 读操作
mu.Lock()
value := m[key]
mu.Unlock()
这是最直接也最常见的方案。普通 map 本身不支持并发安全,但配合 sync.Mutex 后,可以把读写都包进临界区。它的优点是行为直观、控制明确,尤其适合写操作不少、访问模式较固定的业务逻辑。
使用 sync.Map(Go 1.9+)
var sm sync.Map

// 写操作
sm.Store(key, value)

// 读操作
if value, ok := sm.Load(key); ok {
    // 使用value
}
sync.Map 是 Go 为并发场景提供的现成结构,更适合读多写少、键集合相对稳定、需要减少显式加锁成本的场景。它不是普通 map 的无脑替代品;如果写操作频繁,使用互斥锁保护的普通 map 往往更容易获得稳定性能和更清晰的语义。
实战中该怎么判断和处理
把这件事放回工程实践里,可以得到几个比较明确的结论。
- 不要把 recover 当并发问题补丁。 如果日志里已经出现
fatal error: concurrent map read and map write,说明应该回头查共享状态、goroutine 生命周期和同步边界,而不是继续给外层套recover。 - 先分清错误类型,再决定策略。 普通 panic 可以恢复,但 runtime throw 不能。这个边界不搞清楚,排障方向很容易跑偏。
- 代码审查要重点看共享 map。 只要一个 map 可能被多个 goroutine 读写,就要立刻追问:锁在哪里、访问约束是什么、是否应改成
sync.Map或单线程持有。 - 理解 recover 的边界,比会写 recover 更重要。 它适合做请求级容错、协程边界防护和日志兜底,但不适合掩盖运行时认定的致命并发错误。
除了 map 并发读写,Go 里还有一些错误通常也不属于 recover 能稳妥处理的范畴,比如栈溢出、内存不足以及其他运行时致命错误。它们共同的特点是:一旦触发,程序状态往往已经不再可信。
因此,这个问题的最终结论其实很简单:recover 不能捕获 map 的并发读写错误。原因不是 recover 太弱,而是这类错误本来就不走 panic/recover 机制。对 Go 开发者来说,真正有效的办法始终是控制并发访问路径,明确同步策略,而不是指望在崩溃发生后再把它“救回来”。















