



写 Go 并发时,很多问题并不在“怎么起 goroutine”,而在“什么时候确认这一批任务真的都结束了”。sync.WaitGroup 就是解决这件事的基础工具:它不负责通信,只负责等待。下面按常见业务场景、进阶用法和避坑点展开,你可以据此判断它适合放在任务并行、数据处理、服务初始化还是测试代码里。
WaitGroup 到底解决了什么问题
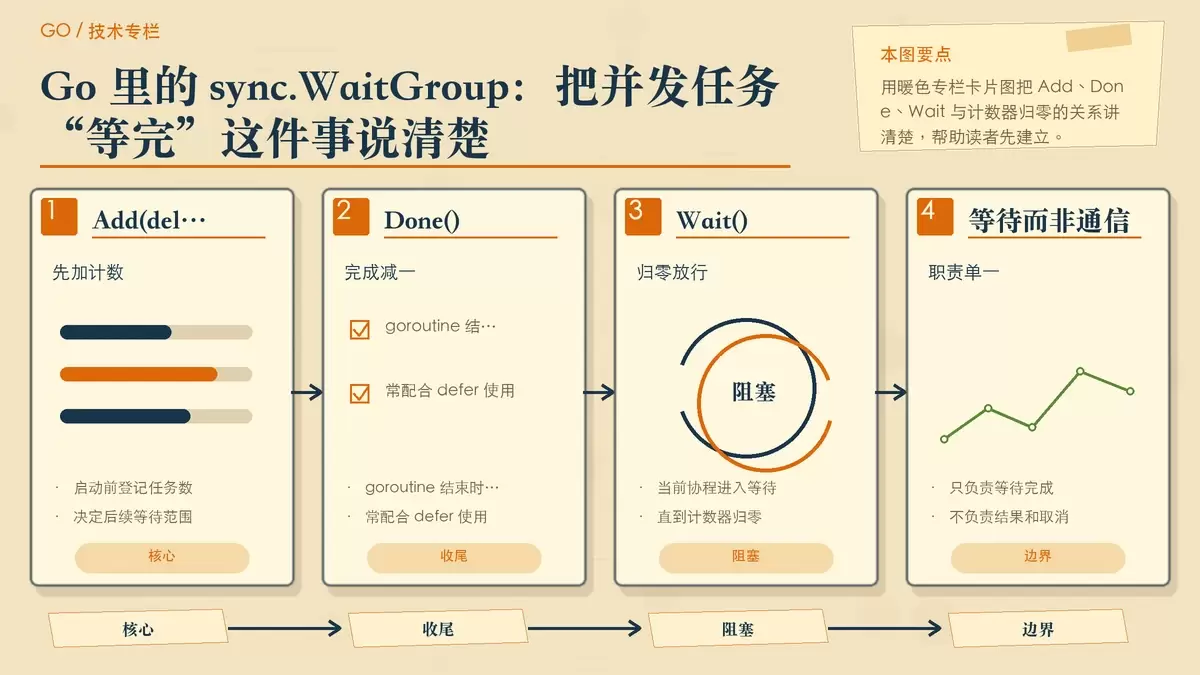
sync.WaitGroup 来自 Go 标准库的 sync 包,用来等待一组 goroutine 执行完成。它的工作方式并不复杂,本质上就是维护一个计数器:有一个任务要等,就把计数器加上去;一个任务做完,就把计数器减下来;当计数器归零时,等待方继续往下执行。
它最核心的三个方法分别是:
Add(delta int):增加计数器,表示后面有多少个 goroutine 需要被等待Done():将计数器减 1,表示一个 goroutine 已完成Wait():阻塞当前 goroutine,直到计数器变为 0
这里有一个很重要的边界:WaitGroup 只解决“等待完成”,不解决“返回结果”“错误汇总”“取消任务”这些问题。如果你的并发流程还涉及结果收集、超时取消、错误传播,往往要和 channel、context 等机制配合使用。
哪些场景最适合用 WaitGroup
并行执行一批独立任务
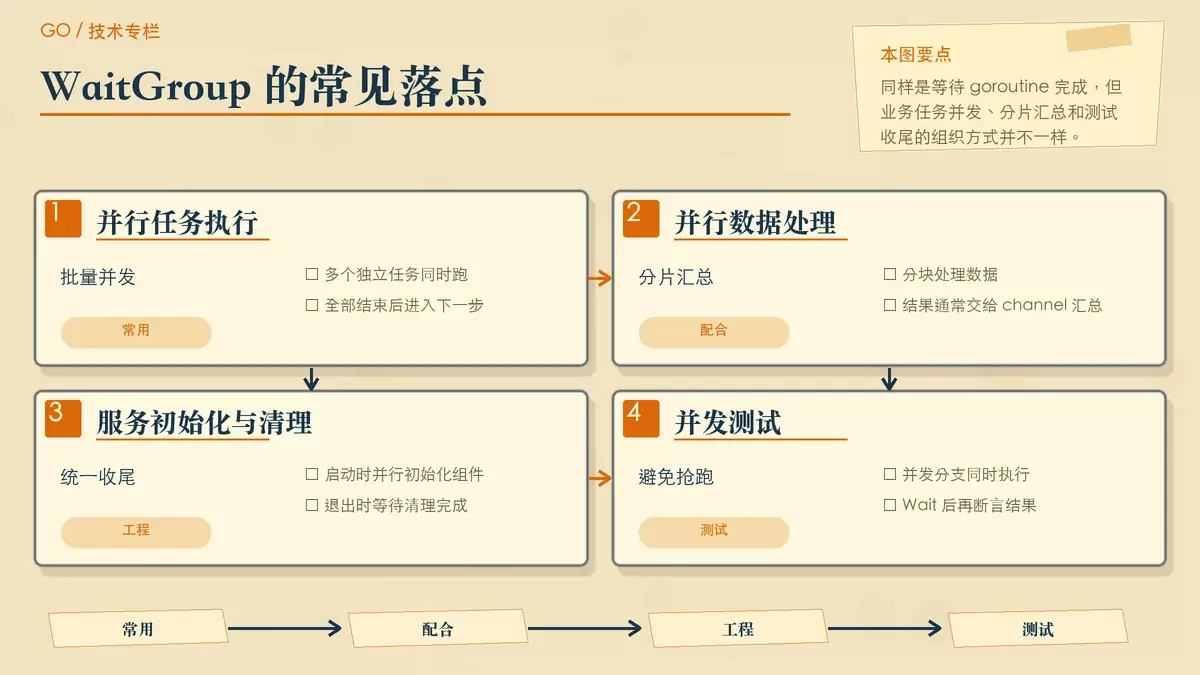
这是最典型的用法。比如批量抓取页面、并发请求多个接口、同时处理多份文件,主流程需要等所有任务结束后再进入下一步,这时候 WaitGroup 很直接。
package main

import (
    "fmt"
    "sync"
    "time"
)

func main() {
    var wg sync.WaitGroup
    urls := []string{"https://example.com", "https://example.org", "https://example.net"}

    for _, url := range urls {
        wg.Add(1)
        go func(u string) {
            defer wg.Done()
            fmt.Printf("Fetching data from %s...n", u)
            time.Sleep(2 * time.Second) // 模拟网络请求
            fmt.Printf("Data from %s fetched.n", u)
        }(url)
    }

    wg.Wait()
    fmt.Println("All data fetched. Proceeding to next step.")
}
这类模式的优势在于结构清晰:启动任务前统一 Add,每个 goroutine 内用 defer wg.Done() 收尾,主 goroutine 最后 Wait()。在爬虫、批量同步、日志归档这类任务型程序里非常常见。
并行处理数据并汇总结果
WaitGroup 也常用于数据分片处理。思路通常是:把一批数据拆成若干块,每个 goroutine 处理一块,结果通过 channel 回传,最后由主流程统一汇总。
package main

import (
    "fmt"
    "sync"
)

func main() {
    var wg sync.WaitGroup
    data := []int{1, 2, 3, 4, 5, 6, 7, 8, 9, 10}
    chunkSize := 2
    resultChan := make(chan int)

    for i := 0; i < len(data); i += chunkSize {
        end := i + chunkSize
        if end > len(data) {
            end = len(data)
        }
        wg.Add(1)
        go func(chunk []int) {
            defer wg.Done()
            sum := 0
            for _, num := range chunk {
                sum += num
            }
            resultChan <- sum
        }(data[i:end])
    }

    go func() {
        wg.Wait()
        close(resultChan)
    }()

    totalSum := 0
    for sum := range resultChan {
        totalSum += sum
    }

    fmt.Printf("Total sum of data: %dn", totalSum)
}这个例子里,WaitGroup 本身并不负责传结果,它只负责确认“所有生产结果的 goroutine 已经结束”。真正的结果汇总由 resultChan 完成,而关闭 channel 的动作放在另一个 goroutine 中,等 wg.Wait() 返回后再执行,这样可以避免主流程提前结束遍历。
服务初始化、资源清理与并发测试
除了业务任务,WaitGroup 还很适合放在应用生命周期管理里。服务启动时,可能要并行初始化缓存、配置中心、数据库连接池、消息消费者;服务退出时,也可能要等多个清理动作全部完成。它在这类“统一起跑、统一收尾”的流程中很好用。
在测试代码里也是同理。并发测试经常需要同时发起一批操作,然后在全部 goroutine 结束后再检查结果,否则测试断言时机可能不稳定。
func TestConcurrentOperations(t *testing.T) {
    var wg sync.WaitGroup
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go func(i int) {
            defer wg.Done()
            // 执行并发操作
        }(i)
    }
    wg.Wait()
    // 检查测试结果
}如果你只是想让测试等所有并发分支结束,WaitGroup 往往比手写轮询或 sleep 更可靠,也更容易读懂。
进阶用法:复杂并发里怎么组合 WaitGroup
多级等待组
当并发逻辑存在层级关系时,代码里可能会出现不止一个 WaitGroup。例如外层 worker 负责派发任务,内层 worker 真正执行细分工作,这时可以用多级等待结构表达不同层次的完成条件。
package main

import (
    "fmt"
    "sync"
    "time"
)

func main() {
    var outerWG sync.WaitGroup
    var innerWG sync.WaitGroup

    for i := 1; i <= 2; i++ {
        outerWG.Add(1)
        go outerWorker(i, &outerWG, &innerWG)
    }

    outerWG.Wait()
    fmt.Println("All outer workers have completed.")
}

func outerWorker(id int, outerWG, innerWG *sync.WaitGroup) {
    defer outerWG.Done()
    fmt.Printf("Outer Worker %d startedn", id)

    for j := 1; j <= 3; j++ {
        innerWG.Add(1)
        go innerWorker(id, j, innerWG)
    }

    innerWG.Wait()
    fmt.Printf("Outer Worker %d completedn", id)
}

func innerWorker(outerID, innerID int, wg *sync.WaitGroup) {
    defer wg.Done()
    fmt.Printf("Inner Worker %d of Outer Worker %d startedn", innerID, outerID)
    time.Sleep(2 * time.Second)
    fmt.Printf("Inner Worker %d of Outer Worker %d completedn", innerID, outerID)
}
这类写法能体现分层同步的思路,但也要格外小心共享同一个内层 WaitGroup 是否会让不同外层任务互相影响。实际项目里,如果每个外层任务都有独立子任务,通常更安全的做法是让每个外层 worker 使用自己的内层等待组,避免同步边界混在一起。
动态添加任务
有些任务不是一开始就全部确定,而是运行过程中才继续扩展,例如消费队列后再派生新任务、扫描目录后再处理新增文件。这时也可以继续调用 Add(1) 把新任务纳入等待范围。
package main

import (
    "fmt"
    "sync"
    "time"
)

func main() {
    var dynamicWG sync.WaitGroup

    // 第一波任务
    for i := 1; i <= 3; i++ {
        dynamicWG.Add(1)
        go dynamicWorker(i, &dynamicWG)
    }

    // 模拟动态添加更多任务
    time.Sleep(1 * time.Second)
    for i := 4; i <= 6; i++ {
        dynamicWG.Add(1)
        go dynamicWorker(i, &dynamicWG)
    }

    dynamicWG.Wait()
    fmt.Println("All dynamic workers have completed.")
}

func dynamicWorker(id int, wg *sync.WaitGroup) {
    defer wg.Done()
    fmt.Printf("Dynamic Worker %d startedn", id)
    time.Sleep(2 * time.Second)
    fmt.Printf("Dynamic Worker %d completedn", id)
}
这种方式能用,但前提是你要非常明确谁负责扩展任务、扩展会持续到什么时候,以及 Wait() 调用时机是否会和新增任务并发冲突。动态添加任务本身不是问题,混乱的任务生命周期才是问题。
给等待过程加上超时控制
WaitGroup 自身没有超时能力,调用 Wait() 后会一直阻塞到计数器归零。如果你希望“最多等多久”,通常要额外包一层 channel,再配合 select 和 time.After 使用。
package main

import (
    "errors"
    "fmt"
    "sync"
    "time"
)

func main() {
    var timeoutWG sync.WaitGroup

    for i := 1; i <= 3; i++ {
        timeoutWG.Add(1)
        go timeoutWorker(i, &timeoutWG)
    }

    // 等待最多5秒,超时则返回错误
    err := waitWithTimeout(&timeoutWG, 5*time.Second)
    if err != nil {
        fmt.Printf("Timeout reached. Not all workers have completed. Error: %vn", err)
    } else {
        fmt.Println("All timeout workers have completed.")
    }
}

func timeoutWorker(id int, wg *sync.WaitGroup) {
    defer wg.Done()
    fmt.Printf("Timeout Worker %d startedn", id)
    time.Sleep(time.Duration(id) * time.Second)
    fmt.Printf("Timeout Worker %d completedn", id)
}

func waitWithTimeout(wg *sync.WaitGroup, timeout time.Duration) error {
    done := make(chan struct{})
    go func() {
        defer close(done)
        wg.Wait()
    }()

    select {
    case <-done:
        return nil
    case <-time.After(timeout):
        return errors.New("timeout reached")
    }
}
需要注意的是,这种“超时返回”并不会自动停止已经启动的 goroutine,它只是让等待方先往下走。如果任务本身还需要取消,仍然要引入 context 或其他中断机制。
最容易踩坑的几个地方
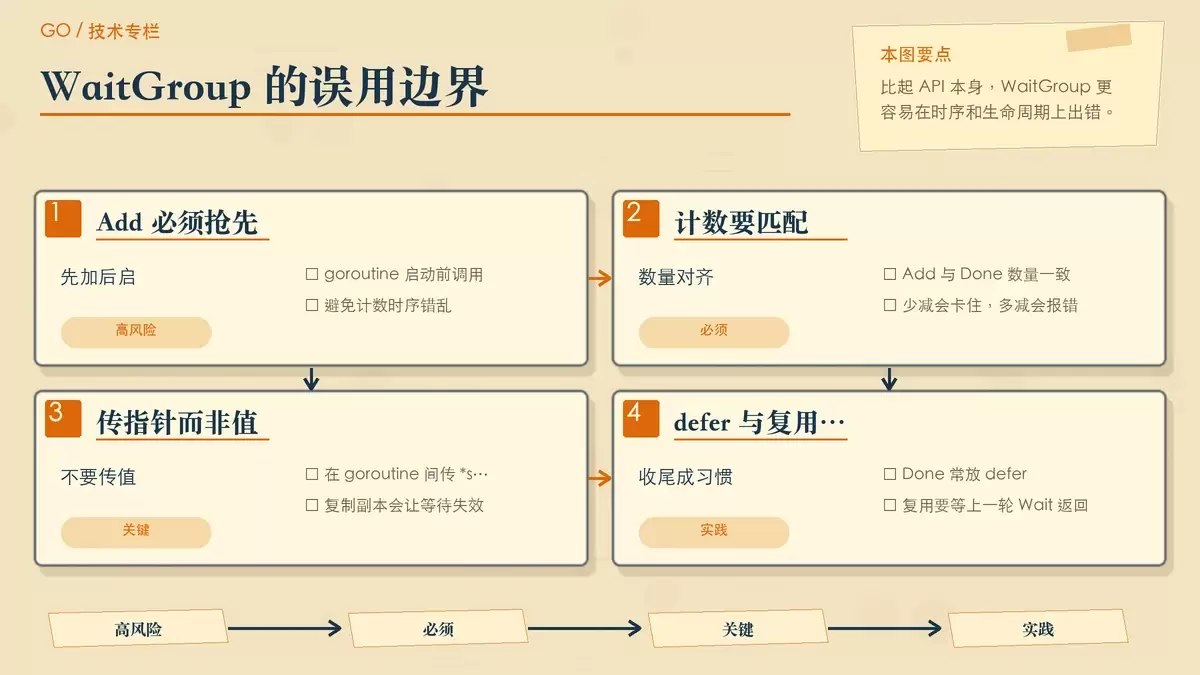
Add要在 goroutine 启动前调用。 如果 goroutine 已经跑起来了,主流程才去Add,计数器时序就可能错乱,严重时会导致死锁或 panic。Done次数必须和Add匹配。 你加了多少,就必须减回多少。少一次,Wait()可能永远不返回;多一次,则可能触发负计数错误。- 传指针,不传值。
WaitGroup必须以指针形式传入 goroutine。若按值传递,相当于复制了一个副本,各自维护不同计数器,等待逻辑会直接失效。 - 尽量把
Done()放进defer。 这样即使 goroutine 中途返回,计数器也能及时减少,代码更稳。原文提到即使发生 panic,使用defer也能帮助维持计数器回收,这个习惯在工程里很重要。 WaitGroup可以复用,但要确保上一轮已经结束。 只有在一次Wait()完整返回后,再开始下一轮Add/Done/Wait,复用才是安全的。混用同一个等待组处理交叉生命周期任务,通常会让代码变得难以判断。
如果把这些约束总结成一句话,就是:WaitGroup 适合描述边界明确的一批任务,而不适合替代完整的任务调度系统。任务数、结束条件、等待方这三件事越清楚,它就越好用。
怎么判断项目里该不该用它
sync.WaitGroup 的价值不在于“高级”,而在于把并发任务的收尾动作明确下来。只要你的需求是“启动一组 goroutine,并在全部完成后再继续”,它通常就是最直接的工具。
如果需求进一步扩展到结果汇总、错误传播、超时取消、分层调度,那么 WaitGroup 往往仍然会保留,但会作为底层等待机制,和 channel、context 甚至更高层的并发控制方式一起使用。理解这一点,比单纯记住 Add、Done、Wait 更重要。















