



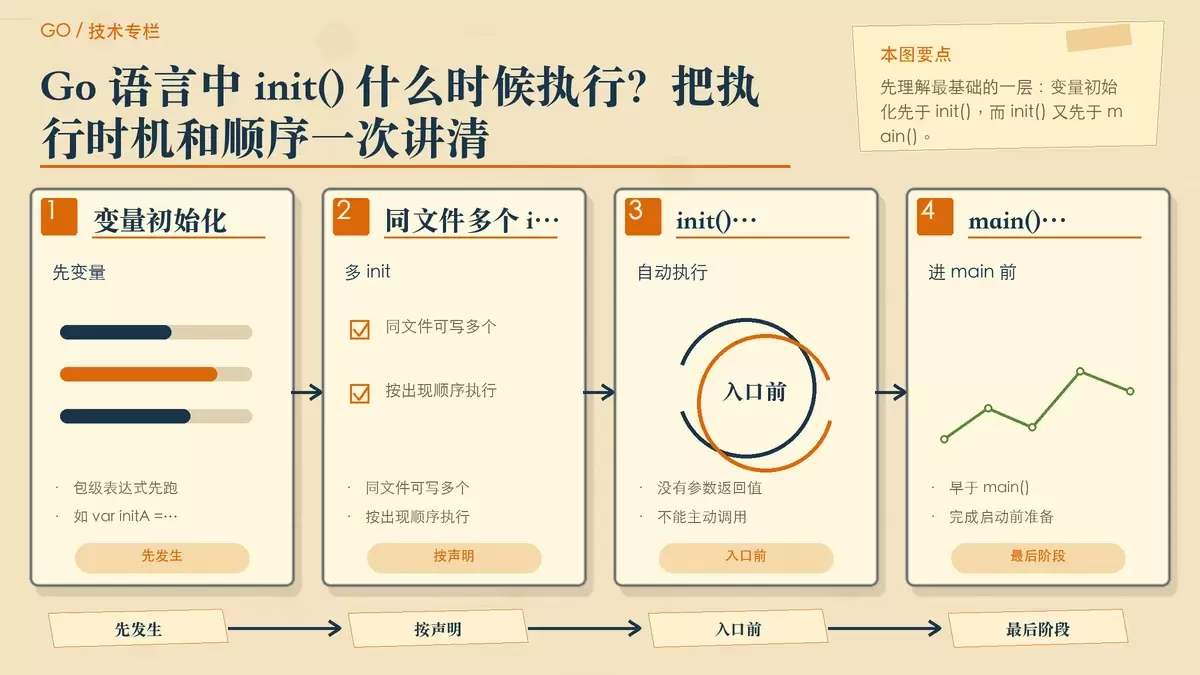
在 Go 项目里,init() 经常被用来做配置加载、数据库初始化和插件注册,但很多人真正困惑的不是“能不能用”,而是“它到底什么时候跑、多个 init() 谁先谁后”。这篇文章就结合几段可复现的代码,把单文件、同包多文件、跨包依赖三种情况拆开说明,帮你建立一套能落地判断执行顺序的规则。
init() 是做什么的,最早在什么时候执行
init 本身就是 initialization 的缩写,作用是执行初始化逻辑。它会在入口函数 main() 之前运行,而且一个包里、甚至同一个文件里,都可以定义多个 init() 函数。需要注意的是,init() 没有参数,也没有返回值。
先看一段最直接的验证代码:
package main

import "fmt"

var initA = printA()

func init() {
    fmt.Println("run init 1")
}

func init() {
        fmt.Println("run init 2")
}

func printA() bool {
    fmt.Println("run a")
    return true
}

func main() {
    fmt.Println("run main")
}
输出:
run a
run init 1
run init 2
run main
这组结果先说明了一件很关键的事:包级变量初始化发生在 init() 之前。也就是说,像 var initA = printA() 这样的初始化表达式会先执行,然后才轮到多个 init(),最后才进入 main()。
从这段代码里,可以直接归纳出几个基础特征:
- 一个文件或一个包中可以有多个
init() init()没有参数,也没有返回值- 不能主动调用
init() - 执行时机在变量初始化之后、
main()之前
在真实项目中,这也是它最常见的用途:初始化配置、建立数据库连接、注册驱动或插件。不过能做,不代表应该滥用,后面讲完顺序后会更容易理解这一点。
同一个包里,多个 init() 按什么顺序执行
当一个包里分散着多个文件、每个文件又可能写了多个 init(),顺序问题就开始变得重要了。下面这个例子假设同一个包中有三个文件:a.go、b.go 和 main.go。
// a.go
package main

import "fmt"

func init() {
    fmt.Println("run init 1 from a.go")
}

func init() {
    fmt.Println("run init 2 from a.go")
}

// b.go
package main

import "fmt"

func init() {
    fmt.Println("run init 1 from b.go")
}

func init() {
    fmt.Println("run init 2 from b.go")
}

// main.go
package main

import "fmt"

func init() {
    fmt.Println("run init 1 from main.go")
}

func init() {
    fmt.Println("run init 2 from main.go")
}

func main() {
    fmt.Println("run main")
}
执行输出如下:
run init 1 from a.go
run init 2 from a.go
run init 1 from b.go
run init 2 from b.go
run init 1 from main.go
run init 2 from main.go
run main
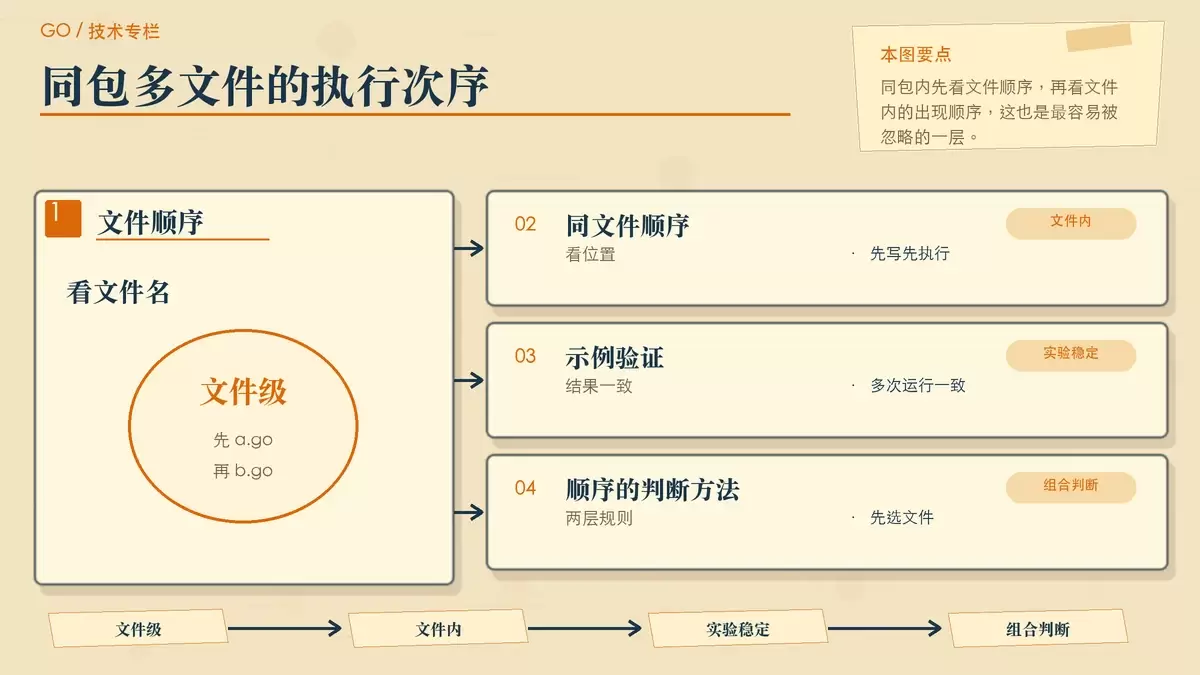
从这个结果可以看出,同一个包中的多个 init(),至少可以拆成两层来理解。
同一文件内
如果多个 init() 出现在同一个源文件里,那么执行顺序就是它们在文件中的出现顺序。也就是先写的先执行,后写的后执行。
同包不同文件
如果这些 init() 分布在不同文件中,那么会先看源文件顺序。按照文中的实验结果,同一个包下多个文件会按源文件名的 ASCII 排序依次执行,因此 a.go 在 b.go 前,b.go 又在 main.go 前。
结合起来就是:
- 包下有多个
init()函数时,先按源文件名的 ASCII 顺序处理文件 - 进入某个文件后,再按该文件中
init()的出现顺序执行
这也是为什么上面的输出会稳定表现为先执行 a.go,再执行 b.go,最后才执行 main.go 中的两个 init()。
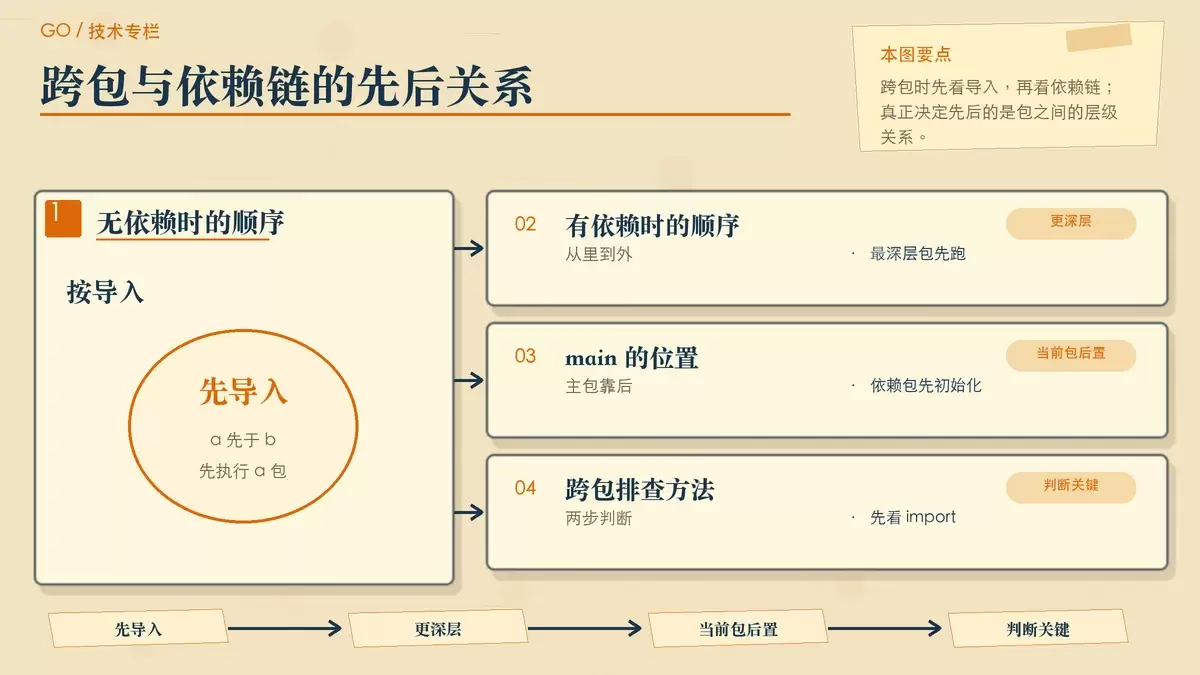
跨包时,init() 的顺序看导入和依赖关系
再往前一步,如果不是一个包内部,而是 main.go 同时导入多个包,那么 init() 的执行顺序就要看包之间的关系了。
这里有 a 和 b 两个包,目录结构如下:
.
├── a
│   └── a.go
├── b
│   └── b.go
├── go.mod
└── main.go
入口文件 main.go 内容如下:
package main

import (
    "fmt"

    _ "github.com/project/demo/a"
    _ "github.com/project/demo/b"
)

func init() {
    fmt.Println("run init 1 from main.go")
}

func init() {
    fmt.Println("run init 2 from main.go")
}

func main() {
    fmt.Println("run main")
}
输出结果如下:
run init 1 from a/a.go
run init 2 from a/a.go
run init 1 from b/b.go
run init 2 from b/b.go
run init 1 from main.go
run init 2 from main.go
run main
从这个例子可以先得出一个直接结论:当多个包都被 main.go 导入,而且彼此没有更深层依赖关系时,init() 会先执行被导入包,再执行当前包;在示例里,a 先于 b 导入,所以 a 的 init() 先执行。
如果多个包之间还存在依赖关系,那么规则会进一步收敛到“先依赖、后上层”。也就是说,执行顺序会按照依赖链条从里到外展开,最深层的包最先执行 init(),依赖它的上层包后执行,最后才轮到最外层的 main 包。
把这部分压缩成一句话就是:跨包时,判断顺序不能只看当前文件写法,还要先看导入关系,再看包之间是否存在依赖链。
项目里该怎么用 init(),哪些顺序最好别依赖
理解了执行机制之后,再回到工程实践就会更清楚。init() 适合放一些启动时必须完成、而且不需要业务方显式调用的初始化动作,例如配置预处理、驱动注册、插件挂载等。
但另一个同样重要的结论是:即便 init() 存在明确顺序,日常编码里也应尽量避免把核心业务逻辑建立在这种顺序之上。原因很简单,文件拆分、包重组、导入调整,都会改变初始化的可读性和维护成本。代码一旦只能靠“记住谁先执行”才能理解,后续排查问题就会非常吃力。
基于本文的实验和结论,可以记住这几条判断规则:
- 包级变量初始化先于
init()执行 - 同一个文件中的多个
init(),按出现顺序执行 - 同一个包中的多个文件,按源文件名的 ASCII 顺序依次执行对应
init() - 多个包存在依赖关系时,按依赖链从里到外执行,最深层包先运行
所以,init() 并不神秘,真正需要掌握的是它背后的初始化层级:先变量、后包内 init()、再上层包、最后 main()。把这个顺序理顺后,看到一个 Go 项目的启动流程,基本就能判断它的初始化代码会在哪里生效,以及哪些写法后期最容易埋坑。















