


通过抓包PC微信接口批量获取公众号文章

本文介绍一种通过抓包PC端微信获取公众号历史文章的方法。无需申请公众号,只需解析mp.weixin.qq.com接口参数(__biz、uin、key等),即可批量获取标题、摘要及链接。提供Python完整代码,支持将数据存入MongoDB数据库或导出为PDF文件,解决历史文章阅读体验不佳的问题。
引言与背景
前言
在浏览微信公众号内容时,用户常面临历史文章查阅不便的问题。
目前常见的抓取方式主要有两种:一是利用搜狗搜索接口,但其限制仅能获取最新的十条推送;二是通过微信公众号后台的素材管理功能,但这要求操作者拥有并申请自己的公众号权限。
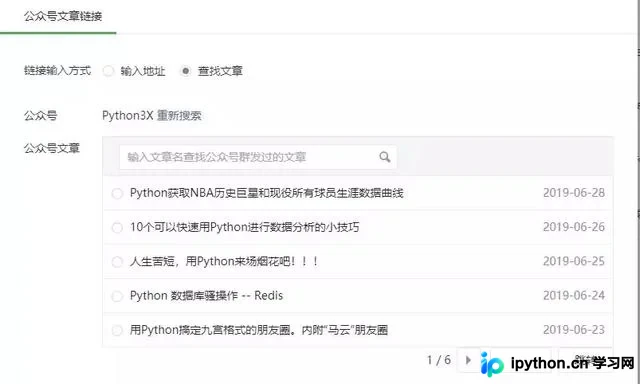
PC微信抓包原理
本文提出一种基于PC端微信网络抓包的技术方案,该方法相比上述方式更为便捷。
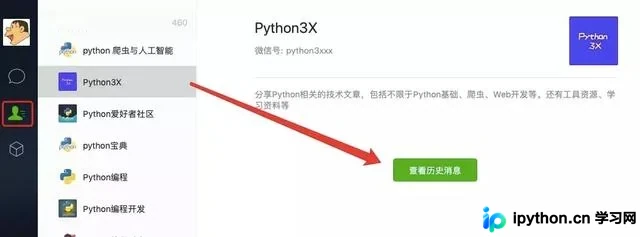
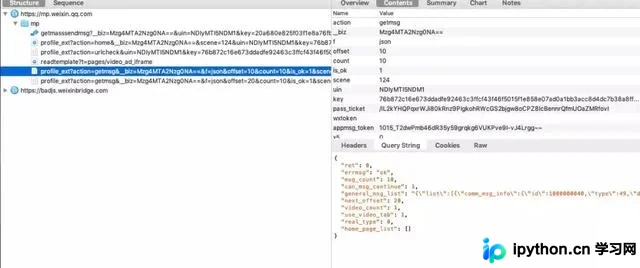
如上图所示,利用抓包工具分析微信的网络请求,可以发现每次下拉刷新文章列表时,系统都会向 mp.weixin.qq.com/mp/xxx 接口发起请求(其中xxx代表profile_ext,因公众号限制无法直接添加主页链接)。
接口参数解析
经过多次测试与分析,该接口主要依赖以下几个关键参数:
- __biz:用户与公众号之间的唯一标识ID。
- uin:用户的私密标识ID。
- key:请求所需的密钥,该密钥具有时效性,一段时间后会自动失效。
- offset:数据偏移量,用于分页获取。
- count:每次请求返回的文章条数。
接口返回的数据结构如下:
{
 "ret": 0,
 "errmsg": "ok", # 请求状态
 "msg_count": 10, # 信息条数
 "can_msg_continue": 1, # 是否还可以继续获取,1代表可以。0代表不可以,也就是最后一页
 "general_msg_list": "{"list":[]}", # 公众号文本信息
 "next_offset": 20,
 "video_count": 1,
 "use_video_tab": 1,
 "real_type": 0,
 "home_page_list": []
}
数据获取代码实现
部分核心代码实现如下:
 params = {
 '__biz': biz,
 'uin': uin,
 'key': key,
 'offset': offset,
 'count': count,
 'action': 'getmsg',
 'f': 'json'
 }
 headers = {
 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.131 Safari/537.36'
 }
 response = requests.get(url=url, params=params, headers=headers)
 resp_json = response.json()
 if resp_json.get('errmsg') == 'ok':
 resp_json = response.json()
 # 是否还有分页数据, 用于判断return的值
 can_msg_continue = resp_json['can_msg_continue']
 # 当前分页文章数
 msg_count = resp_json['msg_count']
 general_msg_list = json.loads(resp_json['general_msg_list'])
 list = general_msg_list.get('list')
 print(list, "**************")
最终打印输出的列表即为公众号文章的详细信息,包含标题(title)、摘要(digest)、文章链接(content_url)、阅读原文地址(source_url)、封面图(cover)、作者(author)等字段。
运行后的输出结果示例如下:
[{
 "comm_msg_info": {
 "id": 1000000038,
 "type": 49,
 "datetime": 1560474000,
 "fakeid": "3881067844",
 "status": 2,
 "content": ""
 },
 "app_msg_ext_info": {
 "title": "入门爬虫,这一篇就够了!!!",
 "digest": "入门爬虫,这一篇就够了!!!",
 "content": "",
 "fileid": 0,
 "content_url": "http:XXXXXX",
 "source_url": "",
 "cover": "I5kME6BVXeLibZDUhsiaEYiaX7zOoibxa9sb4stIwrfuqID5ttmiaoVAFyxKF6IjOCyl22vg8n2NPv98ibow\/0?wx_fmt=jpeg",
 "subtype": 9,
 "is_multi": 0,
 "multi_app_msg_item_list": [],
 "author": "Python3X",
 "copyright_stat": 11,
 "duration": 0,
 "del_flag": 1,
 "item_show_type": 0,
 "audio_fileid": 0,
 "play_url": "",
 "malicious_title_reason_id": 0,
 "malicious_content_type": 0
 }
},{...},{...},{...},{...},{...},{...},{...},{...},{...}]
数据存储与导出方案
获取到数据后,用户可以选择将其保存至数据库,或进一步处理为PDF文档。
1、保存至MongoDB数据库
# Mongo配置
conn = MongoClient('127.0.0.1', 27017)
db = conn.wx #连接wx数据库,没有则自动创建
mongo_wx = db.article #使用article集合,没有则自动创建
for i in list:
 app_msg_ext_info = i['app_msg_ext_info']
 # 标题
 title = app_msg_ext_info['title']
 # 文章地址
 content_url = app_msg_ext_info['content_url']
 # 封面图
 cover = app_msg_ext_info['cover']
 # 发布时间
 datetime = i['comm_msg_info']['datetime']
 datetime = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(datetime))
 mongo_wx.insert({
 'title': title,
 'content_url': content_url,
 'cover': cover,
 'datetime': datetime
 })
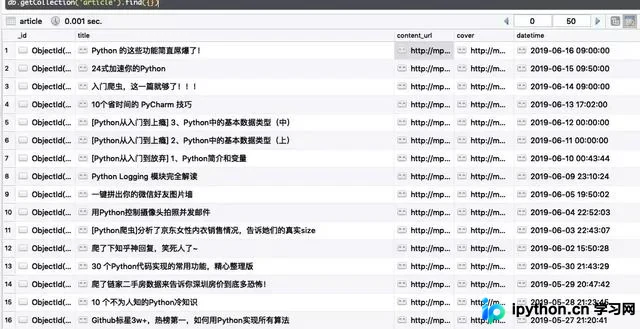
存储后的结果如下:
2、导出为PDF文件
在Python3环境中,常用的PDF操作库包括python-pdf和pdfkit。本文演示使用pdfkit模块进行PDF导出。
pdfkit是对Wkhtmltopdf工具包的封装,因此使用前需先安装Wkhtmltopdf。
可访问 https://wkhtmltopdf.org/downloads.html 下载与操作系统匹配的工具包。
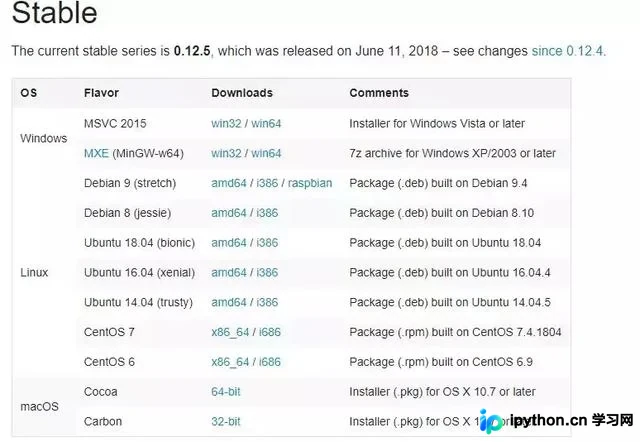
实现过程较为简单,只需传入待导入文件的URL即可生成PDF。
安装pdfkit库的命令如下:
pip3 install pdfkit -i http://pypi.douban.com/simple --trusted-host pypi.douban.com
 import pdfkit
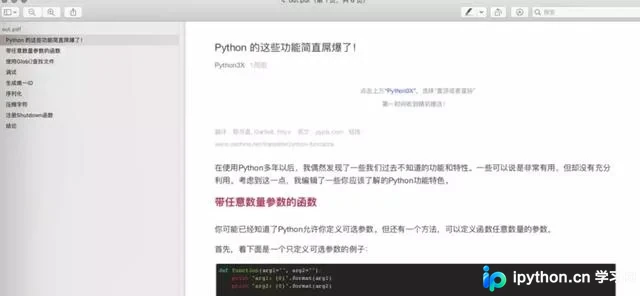
pdfkit.from_url('公众号文章地址', 'out.pdf')
运行程序后,可成功导出PDF文件。
完整代码示例
完整代码示例如下:
import requests
import json
import time
from pymongo import MongoClient
url = 'http://mp.weixin.qq.com/mp/xxx'(公众号不让添加主页链接,xxx表示profile_ext)
# Mongo配置
conn = MongoClient('127.0.0.1', 27017)
db = conn.wx #连接wx数据库,没有则自动创建
mongo_wx = db.article #使用article集合,没有则自动创建
def get_wx_article(biz, uin, key, index=0, count=10):
 offset = (index + 1) * count
 params = {
 '__biz': biz,
 'uin': uin,
 'key': key,
 'offset': offset,
 'count': count,
 'action': 'getmsg',
 'f': 'json'
 }
 headers = {
 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.131 Safari/537.36'
 }
 response = requests.get(url=url, params=params, headers=headers)
 resp_json = response.json()
 if resp_json.get('errmsg') == 'ok':
 resp_json = response.json()
 # 是否还有分页数据, 用于判断return的值
 can_msg_continue = resp_json['can_msg_continue']
 # 当前分页文章数
 msg_count = resp_json['msg_count']
 general_msg_list = json.loads(resp_json['general_msg_list'])
 list = general_msg_list.get('list')
 print(list, "**************")
 for i in list:
 app_msg_ext_info = i['app_msg_ext_info']
 # 标题
 title = app_msg_ext_info['title']
 # 文章地址
 content_url = app_msg_ext_info['content_url']
 # 封面图
 cover = app_msg_ext_info['cover']
 # 发布时间
 datetime = i['comm_msg_info']['datetime']
 datetime = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime(datetime))
 mongo_wx.insert({
 'title': title,
 'content_url': content_url,
 'cover': cover,
 'datetime': datetime
 })
 if can_msg_continue == 1:
 return True
 return False
 else:
 print('获取文章异常...')
 return False
if __name__ == '__main__':
 biz = 'Mzg4MTA2Nzg0NA=='
 uin = 'NDIyMTI5NDM1'
 key = '20a680e825f03f1e7f38f326772e54e7dc0fd02ffba17e92730ba3f0a0329c5ed310b0bd55b3c0b1f122e5896c6261df2eaea4036ab5a5d32dbdbcb0a638f5f3605cf1821decf486bb6eb4d92d36c620'
 index = 0
 while 1:
 print(f'开始抓取公众号第{index + 1} 页文章.')
 flag = get_wx_article(biz, uin, key, index=index)
 # 防止和谐,暂停8秒
 time.sleep(8)
 index += 1
 if not flag:
 print('公众号文章已全部抓取完毕,退出程序.')
 break
 print(f'..........准备抓取公众号第{index + 1} 页文章.')
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















