


Scrapy框架实战:从项目创建到MongoDB数据持久化

本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
Scrapy项目初始化与爬虫创建
首先,需要在命令行中执行命令来初始化Scrapy项目。使用 `scrapy startproject zhaoping` 指令,这会在当前目录下创建一个名为 `zhaoping` 的项目文件夹,并生成默认的项目目录结构。
scrapy startproject zhaoping进入刚刚创建的项目目录后,接着需要创建具体的爬虫文件。执行 `cd zhaoping` 进入项目根目录,然后运行 `scrapy genspider hr zhaopingwang.com` 命令。该命令会生成一个名为 `hr.py` 的爬虫文件,并自动将允许爬取的域名限制为 `zhaopingwang.com`。
cd zhaoping
scrapy genspider hr zhaopingwang.com
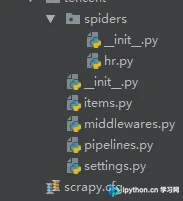
项目创建完成后,其目录结构如下所示,包含了配置文件、爬虫模块、管道模块等标准组件。
定义数据模型与持久化管道
在 `items.py` 文件中,我们需要定义要抓取的数据字段。这里定义了三个字段:`title`(职位名称)、`position`(职位类别或描述)以及 `publish_date`(发布日期)。每个字段都使用 `scrapy.Field()` 进行声明,用于后续数据的结构化存储。
  title = scrapy.Field()
  position = scrapy.Field()
  publish_date = scrapy.Field()
为了实现数据的持久化存储,需要配置 `pipelines.py`。代码中引入了 `pymongo` 库,并初始化了一个连接到 `192.168.226.150` 端口为 `27017` 的MongoDB客户端。接着获取了名为 `zhaoping` 数据库中 `hr` 集合的引用。在 `TencentPipeline` 类的 `process_item` 方法中,接收解析后的 item,将其转换为字典格式,并通过 `collection.insert()` 方法插入到数据库中,最后返回 item 以传递给后续管道。
from pymongo import MongoClient

mongoclient = MongoClient(host='192.168.226.150',port=27017)
collection = mongoclient['zhaoping']['hr']

class TencentPipeline(object):
  def process_item(self, item, spider):
    print(item)
    # 需要转换为 dict
    collection.insert(dict(item))
    return item
编写解析逻辑与分页处理
在 `spiders/hr.py` 中编写核心的解析逻辑。`parse` 方法接收响应对象,首先通过 XPath 表达式 `//table[@class='tablelist']/tr` 定位到数据表格的所有行,并通过切片 `[1:-1]` 排除表头和表尾的无效数据。遍历每一行 `tr`,实例化 `TencentItem`,分别使用 XPath 从第1、2、5列提取标题、职位和发布日期,并赋值给 item。提取完成后使用 `yield item` 输出数据。此外,代码还处理了分页逻辑:通过 XPath 获取“下一页”链接的 `href` 属性,如果链接不是 `javascript:;`,则拼接完整 URL 并发起新的 `scrapy.Request` 请求,回调函数仍为 `parse`,从而实现自动翻页爬取。
def parse(self, response):
    # 不要第一个 和最后一个
    tr_list = response.xpath("//table[@class='tablelist']/tr")[1:-1]
    for tr in tr_list:
      item = TencentItem()
      # xpath 从1 开始数起
      item["title"] = tr.xpath("./td[1]/a/text()").extract_first()
      item["position"] = tr.xpath("./td[2]/text()").extract_first()
      item["publish_date"] = tr.xpath("./td[5]/text()").extract_first()
      yield item

    next_url = response.xpath("//a[@id='next']/@href").extract_first()
    # 构造url
    if next_url != "javascript:;":
      print(next_url)
      next_url = "https://hr.tencent.com/" + next_url
      yield scrapy.Request(url=next_url,callback=self.parse,)
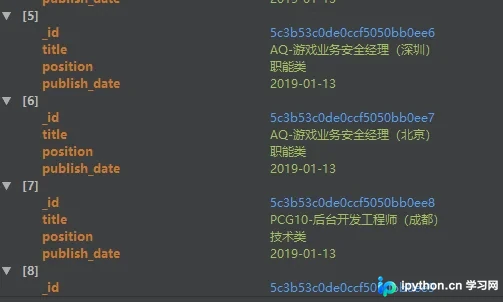
经过上述配置与编码,Scrapy爬虫即可正常运行并成功获取目标网站的数据。整个过程展示了Scrapy框架在数据抓取方面的简洁性与高效性。
本文完整介绍了基于Scrapy框架爬取招聘网站数据并存储至MongoDB的全过程,包括项目创建、爬虫编写、数据定义及管道配置。希望这些内容能为读者提供实际帮助,欢迎继续支持本站获取更多技术资源。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















