


Python机器学习项目实战:8个提升代码质量与效率的实用建议

本文总结了Python机器学习项目中的8个关键实践,涵盖从项目归档、源数据备份、路径配置到代码注释、循环加速、进度可视化、高效调试及异常处理的完整工作流。通过引入Git、Rsync等工具及PySnooper、tqdm等库,帮助开发者规避常见陷阱,提升代码的可维护性与执行效率,适合Python入门及进阶开发者参考。
前言
Python机器学习项目文件管理与备份策略
在进行Python机器学习建模项目时,每个开发者往往都有独特的文件管理习惯。本文分享的是作者基于过往踩坑经验总结出的项目文件管理方法,旨在帮助刚接触Python编程的伙伴少走弯路,提供具有借鉴意义的实践参考。
目录先放出来
- 项目文件事先做好归档
- 永远不要手动修改源数据并且做好备份
- 做好路径的正确配置
- 代码必要的地方做好备注与说明
- 加速你的Python循环代码
- 可视化你的循环代码进度
- 使用高效的异常捕获工具
- 要多考虑代码健壮性
1. 项目文件事先做好归档
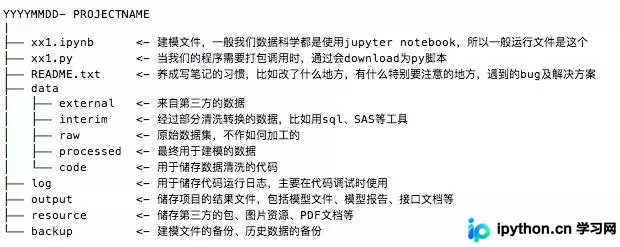
以往开始新项目时,作者常因贪图方便将代码、数据和文档混放在单一文件夹中,导致目录混乱且回溯困难。更严重的是,更换电脑后路径失效需手动修改,带来极大不便。
经过探索,建议将项目划分为若干子文件夹,并将代码文件统一放置在主文件夹内,具体结构可参考如下示例:
2. 永远不要手动修改源数据并且做好备份
必须对源数据进行严格备份,以便后续回溯、执行下一步操作或修改中间步骤。同时,代码及其他相关文件也需做好备份,以防意外丢失导致工作成果受损。
此处参考良许Linux文章推荐的4个备份工具:
- Git版本控制系统
- Rsync文件备份
- Dropbox云存储
- Time Machine时光机器
更多工具的具体介绍与使用细节此处不再展开,读者可自行查阅相关资料。
路径配置与代码注释规范
3. 做好路径的正确配置
许多开发者习惯直接使用绝对路径编写代码,虽然日常运行无碍,但一旦代码共享给他人学习或运行,常因路径差异导致无法直接跑通。
建议采取以下策略:
- 使用相对路径:脚本位于主目录下,其他资源(如数据、第三方包等)在其同级或低级目录下,如 ./data/processed/test1.csv
- 全局路径配置变量:
# 设置主目录
HOME_PATH = r'E:ML90615- PROJECT1'
# 读取数据
data = open(HOME_PATH+'/data/processed/test1.csv')
data = pd.read_csv(data)
data.head()
4. 代码必要的地方做好备注与说明
这一点想必多数开发者深有体会。不妨回顾一个月前自己编写的代码,若未做好备注说明,能否清晰看懂其逻辑?
Python循环加速与进度可视化技巧
5. 加速你的Python循环代码
此处推荐云哥(Python与算法之美)的文章:24式加速你的python
建议收藏并反复阅读,养成良好习惯,从而提升编码速度与效率。
6. 可视化你的循环代码进度
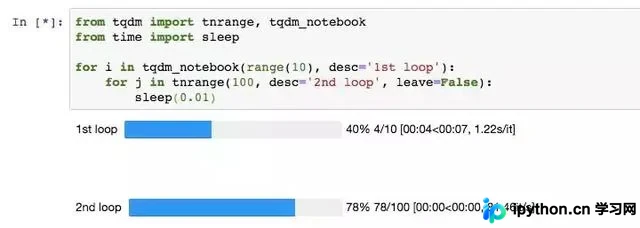
介绍一个Python库:tqdm,请先安装:pip install tqdm
该库用于显示循环进度,使代码执行过程更加可控与透明。
大家可以看下面的例子:
7. 使用高效的异常捕获工具
高效调试工具PySnooper的应用
以往定位异常bug时,作者常依赖print()函数逐行打印,虽可行但效率较低。后来发现PySnooper装饰器,犹如发现新大陆般高效。
常规调试需在疑似问题处打印输出,观察实际结果并思考问题所在,这需要细致修改代码。相比之下,直接添加装饰器更为简便。
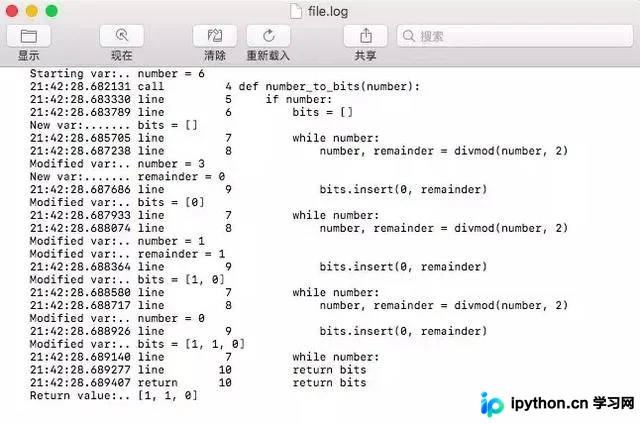
大家可以看看Example:
import pysnooper
@pysnooper.snoop('./file.log')
def number_to_bits(number):
 if number:
 bits = []
 while number:
 number, remainder = divmod(number, 2)
 bits.insert(0, remainder)
 return bits
 else:
 return [0]
number_to_bits(6)
我们将函数每一步的输出保存为file.log,可直接查看具体出错环节。
项目地址:https://github.com/cool-RR/pysnooper
提升代码健壮性的异常处理最佳实践
8. 要多考虑代码健壮性
代码健壮性指代码能抵御各种异常场景测试的能力。异常处理由“捕获”和“抛出”两部分组成。“捕获”指使用 try ... except 包裹特定语句以妥善处理错误流程;恰当使用 raise 主动“抛出”异常,则是优雅代码的必要组成部分。以下总结几点供参考:
1)知道要传入的参数是什么,类型,个数 (异常处理,逻辑判断)
def add(a, b):
 if isinstance(a, int) and isinstance(b, int):
 return a+b
 else:
 return '参数类型错误'
print(add(1, 2))
print(add(1, 'a'))
2)只做最精准的异常捕获
有时为确保脚本运行,开发者可能用大的 try...except 包裹整块代码,但这容易吞噬本应抛出的 AttributeError,增加调试难度。
因此,应仅捕获可能抛出异常的语句块,并尽量指定精确的异常类型,而非模糊的 Exception。
from requests.exceptions import RequestException
def save_website_title(url, filename):
 try:
 resp = requests.get(url)
 except RequestException as e:
 print(f'save failed: unable to get page content: {e}')
 return False
# 这段正则操作本身就是不应该抛出异常的,所以我们没必要使用 try 语句块
# 假如 group 被误打成了 grop 也没关系,程序马上就会通过 AttributeError 来
# 告诉我们。
obj = re.search(r'<title>(.*)</title>', resp.text)
if not obj:
 print('save failed: title tag not found in page content')
 return False
title = obj.group(1)
try: with open(filename, 'w') as fp:
 fp.write(title)
except IOError as e:
 print(f'save failed: unable to write to file {filename}: {e}')
 return False
else:
 return True
3)异常处理不应该喧宾夺主
如前所述,若每个细节都精准捕获,代码中将充斥大量 try...except 语句,干扰核心逻辑,降低整体可读性。
此处可利用上下文管理器改善异常处理流程,简化重复逻辑。
class raise_api_error:
"""captures specified exception and raise ApiErrorCode instead
:raises: AttributeError if code_name is not valid
"""
def __init__(self, captures, code_name):
 self.captures = captures
 self.code = getattr(error_codes, code_name)
def __enter__(self):
 # 该方法将在进入上下文时调用
 return self
def __exit__(self, exc_type, exc_val, exc_tb):
 # 该方法将在退出上下文时调用
 # exc_type, exc_val, exc_tb 分别表示该上下文内抛出的
 # 异常类型、异常值、错误栈
 if exc_type is None:
 return False
 if exc_type == self.captures:
 raise self.code from exc_val
 return False
在上述代码中,我们定义了一个名为 raise_api_error 的上下文管理器,它在进入上下文时不执行操作,但在退出时判断是否抛出类型为 self.captures 的异常,若有,则用 APIErrorCode 异常类替代。
使用上下文管理器后,简洁的代码如下:
def upload_avatar(request):
 """用户上传新头像"""
with raise_api_error(KeyError, 'AVATAR_FILE_NOT_PROVIDED'):
 avatar_file = request.FILES['avatar']
with raise_api_error(ResizeAvatarError, 'AVATAR_FILE_INVALID'),
 raise_api_error(FileTooLargeError, 'AVATAR_FILE_TOO_LARGE'):
 resized_avatar_file = resize_avatar(avatar_file)
with raise_api_error(Exception, 'INTERNAL_SERVER_ERROR'):
 request.user.avatar = resized_avatar_file
 request.user.save()
return HttpResponse({})
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















