



作为 Go 开发中很容易被忽略的一项基础知识,结构体内存对齐其实和性能、内存占用、并发安全都直接相关。很多时候字段类型完全一样,只是换了下声明顺序,结构体大小就会明显变化。下面就从一个最常见的例子切入,拆开看 Go 编译器是怎么补齐 padding 的,以及项目里该怎么据此优化结构体设计。
同样的字段,为什么结构体大小会不一样
先看两个字段完全相同、只是顺序不同的结构体:
type S1 struct {
    x int8 // 1个字节
    y int64 // 8个字节
    z int16 // 2个字节
}

type S2 struct {
    x int8 // 1个字节
    z int16 // 2个字节
    y int64 //  8个字节
}

func main() {
    fmt.Println(unsafe.Sizeof(S1{})) // output: 24
    fmt.Println(unsafe.Sizeof(S2{})) // output: 16
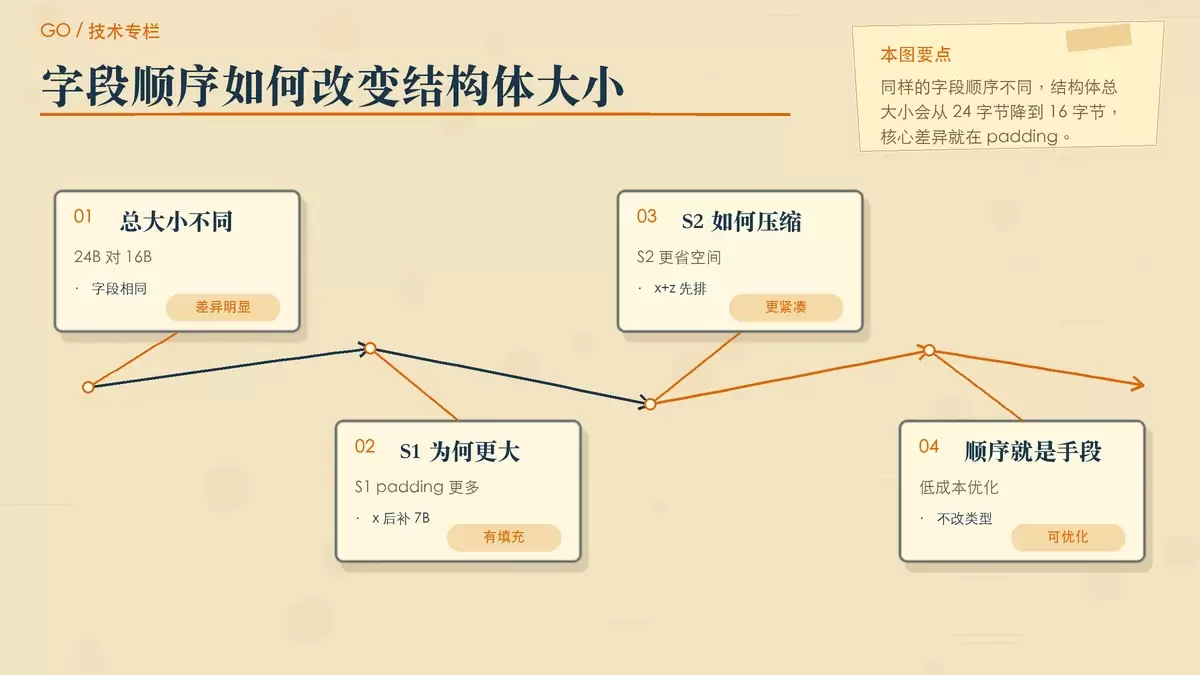
}运行结果很直观:S1 是 24 字节,S2 只有 16 字节。字段没变,差别只在顺序,但内存占用已经拉开了 8 字节。
如果只按字段自身大小来算,int8、int16、int64 的总和明明是 1 + 2 + 8 = 11。可 Go 在计算结构体大小时,并不是简单相加,而是要满足目标平台上的内存对齐要求。
常见类型在 Go 中的尺寸大致如下:
类型种类                  尺寸(字节数)
------                   ------
byte, uint8, int8        1
uint16, int16            2
uint32, int32, float32   4
uint64, int64            8
float64, complex64       8
complex128               16
uint, int                取决于编译器实现。通常在
                         32位架构上为4,在64位
                         架构上为8。
uintptr                  取决于编译器实现。但必须
                         能够存下任一个内存地址。
问题的关键在于:不同类型有不同的对齐要求。为了让字段落在合适的边界上,Go 编译器会自动插入额外的填充字节,也就是 padding。
以 S1 为例,x 是 int8,自身只占 1 个字节,但后面的 y 是 int64,通常希望放在 8 字节对齐的位置上,所以在 x 后面会补 7 个字节。这样 y 就能从偏移量 8 的位置开始。接着 z 占 2 个字节,放完后整个结构体还要满足自身对齐要求,因此尾部继续补齐,最终得到 24 字节。
再看 S2,x 后面先放的是 z,前两个字段合起来是 3 个字节,编译器只需要在它们之后补 5 个字节,就能让 y 按 8 字节边界放下。这样最终总大小就是 16 字节。
这也是 Go 里结构体优化最常见的一条经验:字段类型不变时,调整顺序往往就能直接减少 padding。
为什么内存对齐值得关心
结构体对齐不是编译器的“形式要求”,它本质上服务于 CPU 和运行时的访问效率。
先看最直接的一点:减少 CPU 访问内存的次数。以 64 位平台为例,CPU 通常更适合按 8 字节为单位处理数据。如果一个字段跨越了 8 字节边界,CPU 可能需要分多次读取,才能拿到完整数据;而如果数据天然对齐,读取往往更直接,访问延迟也更低。
第二个收益是缓存友好。CPU 缓存通常按缓存行加载数据,常见是 64 字节。结构体布局更紧凑、字段分布更规整时,更有利于缓存命中,尤其在高频访问对象、批量遍历切片或高并发场景下,差异会更明显。
第三个原因和 Go 运行时本身有关。对齐良好的结构体可以减少无意义的填充空间,让同样的内存容纳更多对象,这会间接降低 GC 压力。对象越紧凑,堆上的总体体积通常越小,扫描和回收成本也更容易控制。
还有一个不能忽视的点是原子操作。Go 的 atomic 包对数据对齐有明确要求,如果相关字段没有按要求对齐,像 AddInt64 这样的操作就可能失败,或者根本无法保证原子性。在涉及计数器、状态位、并发统计值时,这不是性能问题,而是正确性问题。
用 unsafe 看懂大小、对齐值和偏移量
Go 已经通过 unsafe.Sizeof 告诉我们结构体总大小,但如果想继续追踪字段为什么会落在某个位置,就需要看另外两个工具:unsafe.Alignof() 和 unsafe.Offsetof()。
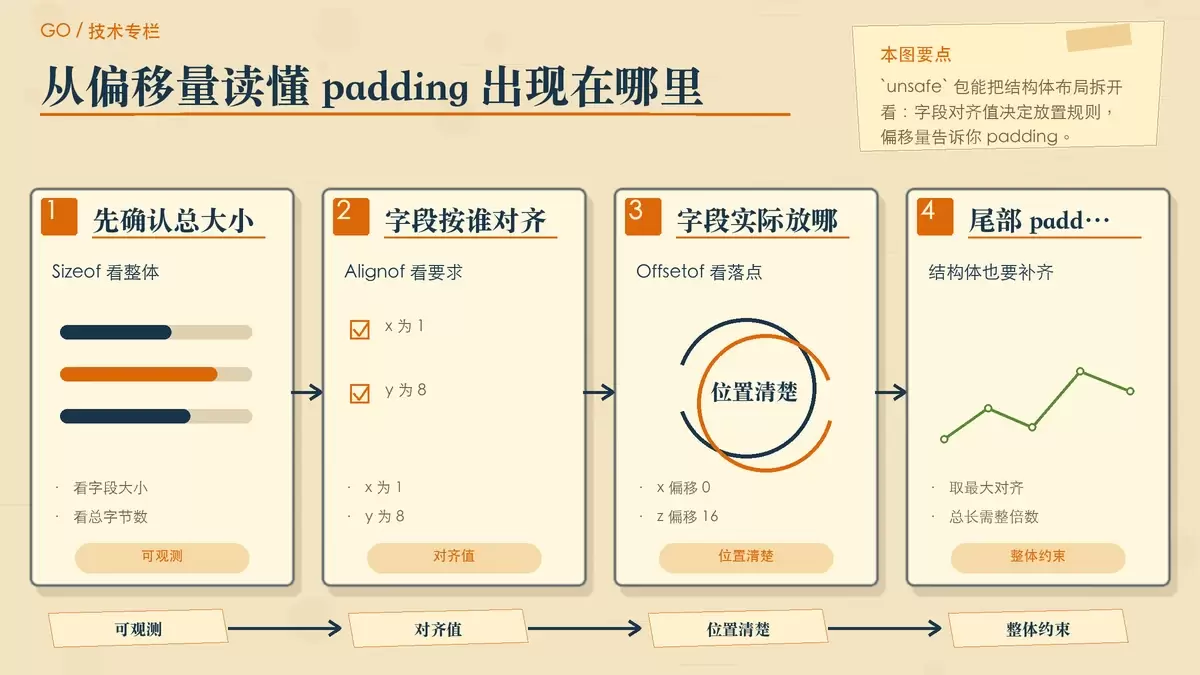
Alignof 用来查看某个类型或字段的对齐值,Offsetof 用来查看字段在结构体中的偏移量。常见平台上,对齐系数通常可以简单理解为:32 位是 4,64 位是 8。
    var s1 S1
    fmt.Println(unsafe.Alignof(s1.x), unsafe.Offsetof(s1.x)) // output: 1 0
    fmt.Println(unsafe.Alignof(s1.y), unsafe.Offsetof(s1.y)) // output: 8 8
    fmt.Println(unsafe.Alignof(s1.z), unsafe.Offsetof(s1.z)) // output: 2 16
从这组结果可以直接读出 S1 的布局:
x的对齐值是1,偏移量是0y的对齐值是8,偏移量是8z的对齐值是2,偏移量是16
也就是说,x 写完后,编译器并没有立刻放入 y,而是先补齐到偏移量 8;y 放完占据 8 个字节后,z 才从偏移量 16 开始。
这里还要注意一点:不只是字段有对齐值,结构体本身也有对齐值。结构体的对齐值通常取决于其内部最大字段的对齐要求,因此整个结构体的总大小,必须是这个对齐值的整数倍。
在 S1 中,最大字段对齐值是 8,所以即使最后一个字段 z 自身只占 2 个字节,结构体尾部仍然要继续补齐,保证整个对象最终大小符合 8 的倍数要求。
原文里给出的判断方式可以概括为:当字段排布后未满足结构体整体对齐要求时,编译器会自动做填充。实际分析时,更稳妥的思路是结合字段对齐值、字段偏移量和结构体总大小一起看,而不是只做字段字节数相加。
常见类型的对齐值怎么理解
为了判断结构体该怎么排布,最有用的信息其实是“字段自身大小”和“平台上的对齐值”两组数据。下面这张表可以直接作为日常判断依据:
| 数据类型 | 自身大小 | 32位平台对齐值 | 64位平台对齐值 |
|---|---|---|---|
| int、uint | 4 or 8 | 4 | 8 |
| int32、uint32 | 4 | 4 | 4 |
| int64、uint64 | 8 | 4 | 8 |
| int8、uint8 | 1 | 1 | 1 |
| int16、uint16 | 2 | 2 | 2 |
| float32 | 4 | 4 | 4 |
| float64 | 8 | 4 | 8 |
| bool | 1 | 1 | 1 |
从表里能看出两个常见规律。
第一,小类型并不总能“省空间”。如果它前后夹着大类型,反而可能因为频繁补齐造成更多浪费。比如把 bool、int8、int16 零散插到多个 int64 字段中间,经常会拉高整体大小。
第二,64 位平台上更要注意 8 字节对齐。很多服务端 Go 程序本来就跑在 64 位环境里,因此 int64、uint64、float64 这类字段的排列方式,对最终结构体尺寸影响尤其明显。
项目里更实用的结构体优化建议
理解规则之后,真正有价值的是把它落实到结构体设计里。下面几条是项目中最常见、也最容易见效的做法。
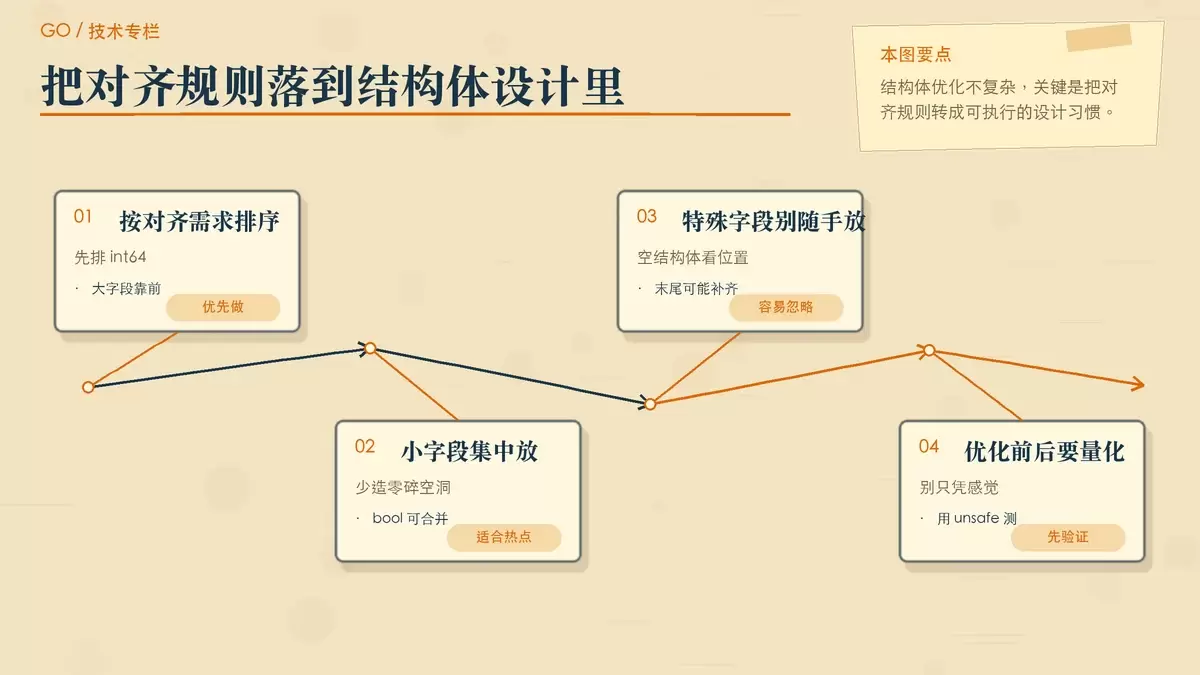
按对齐需求安排字段顺序
优先把对齐值大的字段放前面,通常能减少中间的填充字节。实际写法里,可以粗略按 int64 → int32 → int16 → int8/bool 这样的顺序来组织,而不是把小字段随手插在大字段之间。
把零散小字段尽量收拢
多个小字段分散排布时,很容易在大字段前后制造 padding。把它们集中放在一起,往往比穿插声明更紧凑。如果业务允许,多个布尔状态也可以考虑合并为位标志,用一个 uint8 表示 8 个布尔位,进一步压缩空间。
注意空结构体字段的位置
空结构体本身不占普通字段那样的存储空间,但作为结构体字段参与布局时,位置仍然可能影响对齐结果。原文给出的建议是:空结构体字段放在末尾时可能产生额外填充,更稳妥的做法是放在开头,避免无谓浪费。
优化前先测,不要只凭感觉改
结构体调整的收益是否明显,最好用 unsafe.Sizeof、Alignof、Offsetof 先验证,再决定是否修改。对少量对象来说,节省 8 字节可能意义不大;但如果这个结构体出现在大切片、缓存池、热点请求对象里,累计收益就会很可观。
归根结底,内存对齐既是硬件访问效率的要求,也是 Go 类型系统和运行时行为的一部分。写结构体时多看一眼字段顺序,往往就是一类低成本、可量化的优化。















