



对很多 Java 开发者来说,接入生成式 AI 的难点并不在“能不能调模型”,而在于如何把模型能力稳定地放进现有的 Spring Boot 工程。Spring AI的价值,就在于它用 Spring 熟悉的配置、依赖注入和统一接口,把不同模型提供方的接入方式收拢到一套开发习惯里。本文就用 Ollama 和 deepseek-r1:1.5b 做一遍最小示例,带你看清它的安装路径、代码结构,以及普通返回与流式输出分别该怎么写。
Spring AI 适合解决什么问题
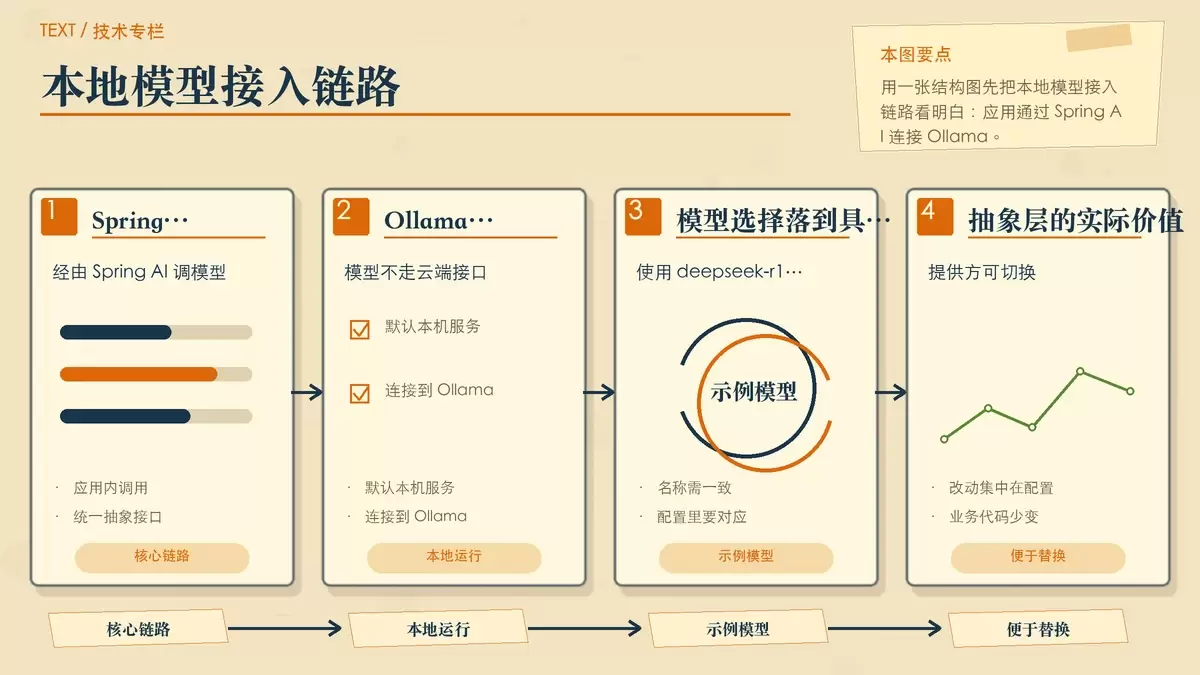
Spring AI 是一个基于 Spring 生态的 AI 接入组件,核心目标是简化人工智能应用的开发流程。它提供了一层抽象接口,作为开发 AI 应用程序的基础,而这些抽象又有多种实现,因此在更换模型或服务提供商时,往往不需要大改业务代码。
对 Java 开发者来说,这意味着你可以继续沿用熟悉的 Spring Boot 项目结构、配置方式和 Bean 注入机制,在应用里接入主流 AI 模型提供商。它目前支持的范围包括 Anthropic、OpenAI、Microsoft、Amazon、Google 和 Ollama 等。
如果你的项目已经是 Spring 技术栈,那么 Spring AI 的优势并不是“功能比别人多”,而是“接入方式更像 Spring 本身”。这也是它更适合放进现有后端服务,而不是只做一次性 Demo 的原因。
开始之前:环境要求与依赖安装
在动手之前,先确认基础环境已经满足。原文给出的要求如下:
Java17 或更高版本Maven3.6/gradle 或更高版本Spring Boot3.2.x and 3.3.x
项目可以先通过 Spring Initializr 初始化,地址为:https://start.spring.io/。
随后需要在 pom.xml 中加入 spring io 仓库配置:
<repositories>
  <repository>
    <id>spring-milestones</id>
    <name>Spring Milestones</name>
    <url>https://repo.spring.io/milestone</url>
    <snapshots>
      <enabled>false</enabled>
    </snapshots>
  </repository>
  <repository>
    <id>spring-snapshots</id>
    <name>Spring Snapshots</name>
    <url>https://repo.spring.io/snapshot</url>
    <releases>
      <enabled>false</enabled>
    </releases>
  </repository>
</repositories>
然后添加依赖管理器,也就是 spring-ai-bom:
<dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-bom</artifactId>
            <version>1.0.0-SNAPSHOT</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>
这一步的作用,是先把 Spring AI 相关依赖的版本管理统一起来,后面你再选择具体模型接入组件时,配置会更清晰。
用 Ollama 跑通本地模型示例
模型提供方可以按你的场景选择。这里沿用原文示例,使用 Ollama 作为本地模型运行环境。做法是先参考 Ollama 官网完成安装,再部署并运行一个模型。示例命令如下:
ollama run deepseek-r1:1.5b这条命令拉起的是 deepseek-r1:1.5b。如果这个模型已经在本地可用,后续 Spring Boot 应用就可以直接通过默认接口去访问它。
接着在 pom.xml 中加入 Ollama 的 Spring Boot Starter:
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-ollama-spring-boot-starter</artifactId>
</dependency>
这一段很关键,因为它决定了 Spring AI 底层实际连的是哪一类模型服务。在本例里,应用不是直接写 HTTP 请求去调用本地模型,而是通过 Spring AI 对 Ollama 的适配层来完成接入。
配置文件怎么写才够用
使用 Ollama 时,可以配置的项目并不少,原文也给出了文档入口:https://docs.spring.io/spring-ai/reference/api/chat/ollama-chat.html。不过对于一个最小可运行示例来说,并不需要一次把所有参数都配满。
在 application.properties 中,先加上最核心的两项即可:
spring.ai.ollama.base-url=http://localhost:11434
spring.ai.ollama.chat.options.model=deepseek-r1:1.5b
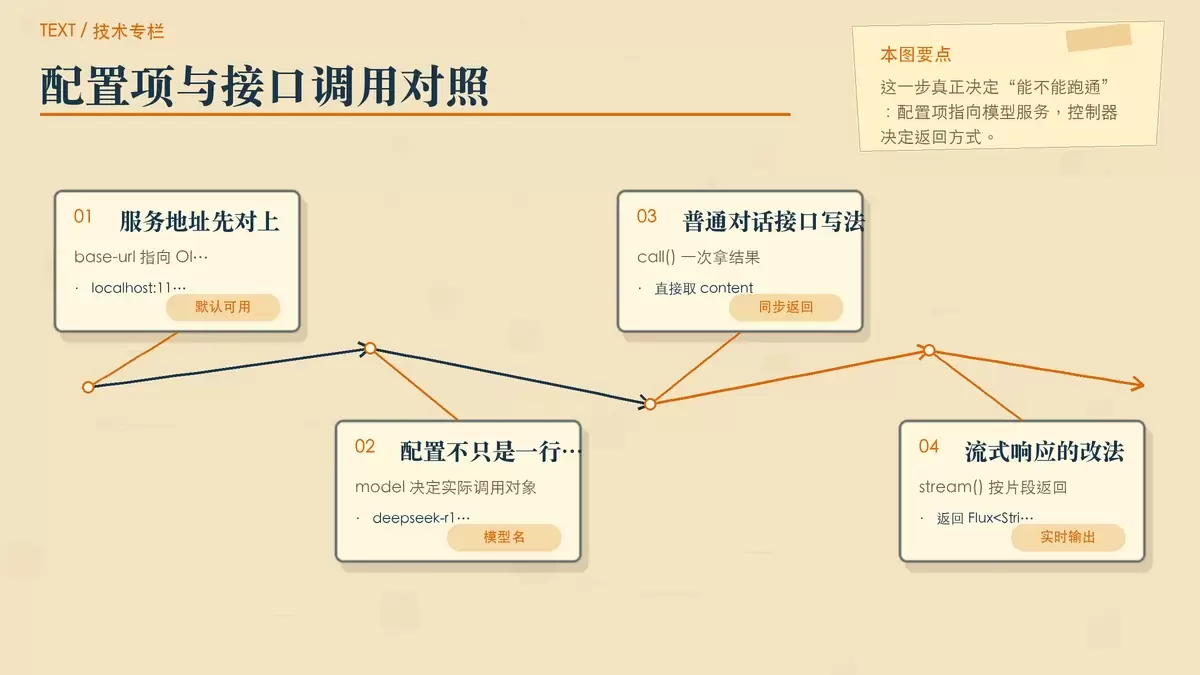
第一项指定 Ollama 服务地址,原文使用的是默认地址和端口 http://localhost:11434;第二项指定实际使用的聊天模型 deepseek-r1:1.5b。
如果你的 Ollama 并不是跑在默认端口,或者模型名称与示例不同,就在这里替换成对应值。也就是说,Spring AI 的接入门槛并不在 Java 代码本身,很多时候只是配置项是否与你的本地服务保持一致。
控制器如何调用模型
配置完成后,就可以在项目里创建一个控制器,对外提供交互接口。原文示例如下:
package com.example.demo.springai.controller;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
class MyController {

    private final ChatClient chatClient;

    public MyController(ChatClient.Builder chatClientBuilder) {
        this.chatClient = chatClientBuilder.build();
    }

    @GetMapping("/ai")
    String generation(String userInput) {
        return this.chatClient.prompt()
            .user(userInput)
            .call()
            .content();
    }
}
这段代码的思路很直接:
- 通过构造器注入
ChatClient.Builder - 在控制器中构建出
ChatClient - 暴露一个
/ai接口 - 接收请求参数
userInput - 把用户输入交给模型,再返回生成内容
其中最核心的一行是:
return this.chatClient.prompt()
    .user(userInput)
    .call()
    .content();
它表达的是一个完整调用链:创建提示词上下文、写入用户输入、发起调用、最后取回模型输出内容。对于只需要同步返回一段文本结果的场景,这种写法已经足够清楚,也足够贴近 Spring 开发者平时写业务接口的习惯。
需要实时返回时,改成流式输出
如果你不是要等模型一次性生成完整结果,而是希望边生成边返回,那么原文建议把 call() 改成 stream()。示例如下:
    @GetMapping("/ai")
    Flux<String> generation(String userInput) throws UnsupportedEncodingException {
        return this.chatClient.prompt()
            .user(userInput)
            .stream()
            .content();
    }
这里返回值从普通字符串变成了 Flux<String>,意味着接口不再是“一次性拿到完整回答”,而是按流式片段持续输出内容。这类写法更适合聊天窗口、逐字显示回复、长文本生成等对实时反馈更敏感的场景。
从使用方式看,Spring AI 在这里的改动也比较克制,开发者主要只是把调用终点从 call() 切换为 stream(),整体控制器结构并没有被打乱。
启动方式与结果验证
完成以上步骤后,直接启动 Spring Boot 项目即可。应用起来之后,可以在浏览器访问下面这个地址进行验证:
http://localhost:8080/ai?userInput=springai如果本地的 Ollama 服务正常运行、模型已经可用、Spring Boot 配置也没有写错,那么你就能在这个接口上看到 AI 返回的内容。
从这个最小示例可以看出,Spring AI 的使用门槛并不高:准备好 Java 与 Spring Boot 环境,选定模型提供方,补上 Starter 依赖和配置,再写一个非常普通的控制器,就能把生成式 AI 接到项目里。
原文最后还提到,除了基础对话能力之外,Spring Boot 还支持主流的矢量数据、向量存储、模型评估等功能。对于准备把 AI 能力继续扩展到检索增强、知识库问答或效果评估的团队来说,这意味着 Spring AI 不只是一个调用模型的小工具,而是能继续往工程化方向延伸的一层基础设施。















