



做 Go 并发开发时,大家最熟悉的通常是 Lock():先把共享资源保护起来,拿不到锁的协程就等着。但项目里并不是所有场景都适合“等到拿到为止”,有些操作更需要快速判断能不能执行,不能执行就立刻退出。本文就围绕 Go 1.18 引入的 TryLock() 来看它和普通加锁的区别、适合放在哪些业务位置,以及什么时候应该优先考虑 channel、context、select 这类更贴近 Go 风格的并发方案。
Lock() 和 TryLock() 到底差在哪
在 Go 里,常见的锁主要是互斥锁 sync.Mutex{} 和读写锁 sync.RWMutex{}。它们都实现了 sync.Locker 接口:
// A Locker represents an object that can be locked and unlocked.
type Locker interface {
    Lock()
    Unlock()
}
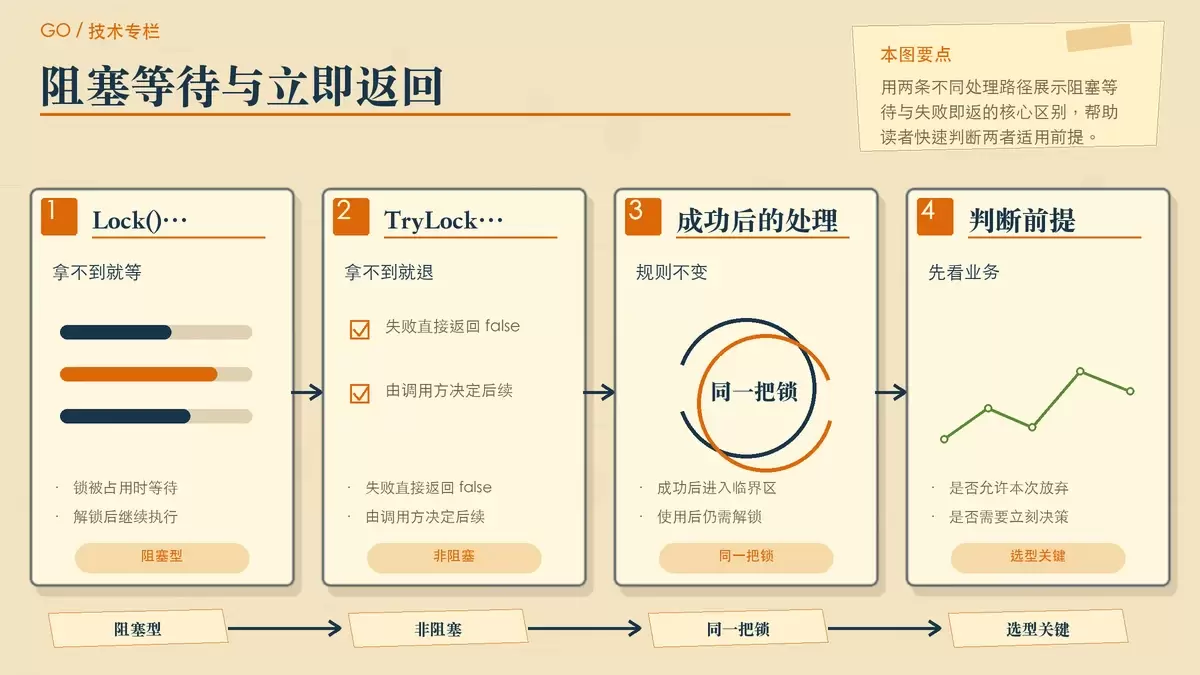
调用 Lock() 之后,如果锁已经被别的协程持有,那么当前协程会被阻塞,直到前一个持锁者释放锁。这种方式适合“这段逻辑必须执行完,资源也必须拿到”的场景,因为它会一直等到成功为止。
问题在于,真实业务里并不总是需要这种等待。有些任务本来就是可跳过的、可丢弃的,或者只允许一个请求先进入,后来的请求没必要排队。对于这类场景,阻塞等待反而会拉长处理链路,甚至让协程堆积。
Go 早期标准库里没有现成的非阻塞加锁方案,这也是为什么过去会出现不少第三方实现。到了 Go 1.18,官方在 sync.Mutex{} 和 sync.RWMutex{} 中加入了 TryLock(),开发者终于可以直接使用标准库提供的尝试加锁能力。
Go 1.18 的 TryLock() 是怎么工作的
TryLock() 的语义很直接:尝试加锁,成功返回 true,失败返回 false。和 Lock() 最大的区别,不在于加锁目标变了,而在于失败后的行为变了。
它不会在失败时继续等待,而是把“拿不到锁怎么办”这个决定权交还给调用方。业务代码可以据此选择直接返回、跳过当前任务、记录状态,或者走一条降级路径。
// TryLock tries to lock m and reports whether it succeeded.
//
// See package [sync.Mutex] documentation.
func (m *Mutex) TryLock() bool {
    old := m.state
    if old&(mutexLocked|mutexStarving) != 0 {
        return false
    }

    // There may be a goroutine waiting for the mutex, but we are
    // running now and can try to grab the mutex before that
    // goroutine wakes up.
    if !atomic.CompareAndSwapInt32(&m.state, old, old|mutexLocked) {
        return false
    }

    if race.Enabled {
        race.Acquire(unsafe.Pointer(m))
    }
    return true
}从这段实现也能看出来,TryLock() 本质上还是在尝试获得同一把锁,只是没有阻塞等待这一步。成功时照常进入临界区,失败时立刻结束本次尝试。
这里有一个很容易被忽略的点:TryLock() 一旦成功,后续的使用规则和 Lock() 没有区别,最终仍然必须调用 Unlock() 释放锁。它只是“尝试进入”的方式变了,不代表锁的生命周期管理可以放松。
哪些场景更适合用 TryLock()
Go 官方虽然加入了 TryLock(),但并没有给出一套固定的“推荐场景清单”。这很正常,因为它不是并发编程里的通用主角,而是一个针对特定问题的工具。关键不在于它新不新,而在于你的业务是不是恰好需要“失败后立即返回”。
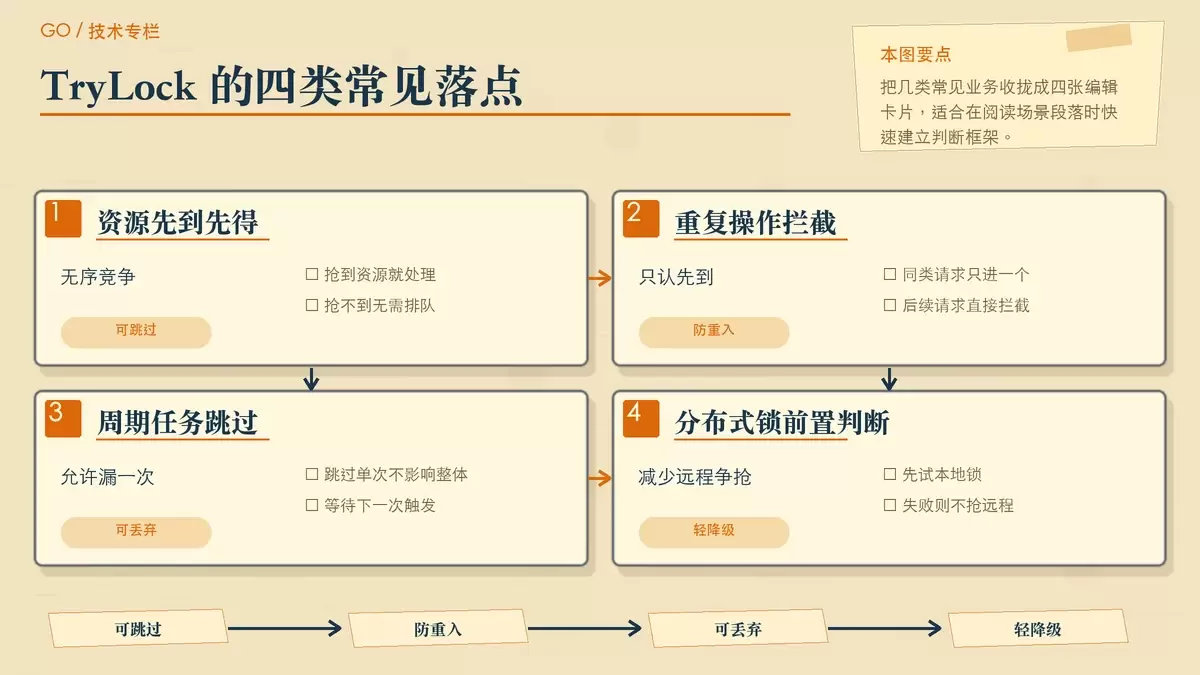
1. 无序资源竞争
如果一类任务的特点是“谁先拿到资源谁就处理,没拿到也不用排队”,那么 TryLock() 很合适。比如多个协程竞争同一份临时资源,当前协程没抢到就直接退出,把机会留给下一轮。
2. 拦截重复并发操作
有些逻辑只允许一个请求进入,比如某个刷新动作、批量处理任务、定时触发的同步流程。在上一次还没执行完之前,后来的同类请求不需要等待,也不应该再开一条并发处理链路,这时可以通过 TryLock() 直接拦截重复进入。
3. 允许丢弃单次操作
如果业务能容忍偶尔跳过一次处理,例如高频触发的状态刷新、指标采样、周期性更新任务,那么加锁失败时直接放弃本次执行,往往比堆积等待更划算。下一次触发到了,再重新尝试即可。
4. 作为更重锁方案前的一层降级
在一些需要分布式锁的场景里,也可以先尝试本地 TryLock()。如果本地已经说明当前节点正在处理同类任务,就没有必要继续去抢远程锁。这样能减少不必要的远程竞争,把系统开销控制在更低水平。
这些场景有一个共同点:拿不到锁并不会破坏业务正确性,最多只是放弃本次机会。只要这个前提不成立,TryLock() 就不该被优先考虑。
使用 TryLock() 时要注意什么
TryLock() 不是“更高级的 Lock()”,也不是加上就能优化并发性能的快捷开关。它真正带来的,是一种不同的控制流:从“等待直到成功”改成“失败立即决策”。
这也意味着,使用它之前要先想清楚失败分支如何处理。是直接返回、静默丢弃、提示稍后重试,还是走降级逻辑?如果这条失败路径设计不清楚,TryLock() 只会把阻塞问题换成状态不一致、任务遗漏或行为不透明的问题。
另外,不论是阻塞锁还是非阻塞锁,都要谨慎处理临界区范围和解锁时机,避免死锁、协程泄露等风险。尤其当代码分支变多后,更要确认成功加锁后的每条路径最终都能正确 Unlock()。
最后也要看到,锁并不是 Go 并发控制的唯一答案。很多时候,使用 channel、context、select 来组织任务协作、取消和超时,会比单纯围绕锁做设计更自然,也更符合 Go 的并发哲学。
所以,判断 TryLock() 值不值得用,可以抓住一个简单标准:如果“拿不到锁就立即退出”本身就是业务允许且合理的结果,它就是可选项;如果业务必须完成,只是你不想等,那问题通常不在锁类型,而在整体并发设计。















