


Django数据库索引详解:从原理到Django 2.0特性

本文深入解析Django数据库索引的工作原理,涵盖全表扫描与随机访问的区别,详细讲解B-Tree、GinIndex和BrinIndex的实现机制。重点介绍Django 1.11引入的通用索引API,以及Django 2.0中展望的功能索引、GiSTIndex支持及db_index重构方案,帮助开发者优化数据库查询性能。
Django数据库索引详解:从原理到Django 2.0特性
前言
随着数据库每天存储的数据量日益增长,它们已成为每个Django项目中至关重要的组成部分。因此,深入理解数据库的工作机制显得尤为重要。
当然,本文无法也不打算详尽解释Django支持的所有数据库的全部细节。这不仅因为相关知识浩如烟海,更因为全面展开讨论可能会引发过于冗长的对话,甚至演变成一场漫长的研讨会。
关于数据库的理论背景,这里仅提及“关系代数”这一概念。理论上,任何SELECT语句都可以用关系代数来表达,这有着坚实的数学证明作为支撑。
数据库查找机制:从全表扫描到随机访问
数据库查找如何工作
相反,让我们从数据库查找的工作机制开始讲起,因为这是我们在日常开发中花费时间最多的环节。
假设我们有一个存储人名及其开始编程时年龄的数据库表。
现在,我们的目标是筛选出所有在19岁开始编程的人。
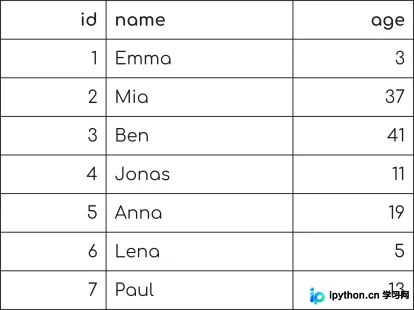
我们可以使用以下SQL查询来表达这一需求:
SELECT * FROM people WHERE age = 19那么,数据库如何找到符合该查询的每一行数据呢?
表扫描查找
方法很简单:我们只需遍历表中的每一行,检查其是否满足条件,如果满足则返回该行数据。
这种方法被称为“全表扫描”。
目前看来还不错。假设表中只有7行数据,我们只需检查7行,查询速度会很快。
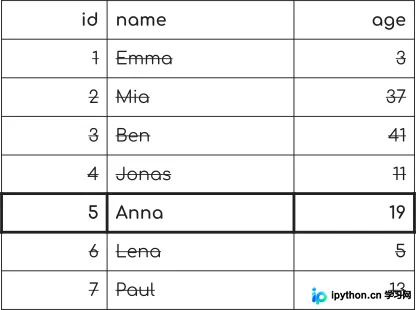
但是,如果数据量达到10万、1亿甚至100亿行呢?遍历每一行将变得极其耗时。这不是我们期望或能够承受的结果。我们需要一种与行数无关、能提供保证查询时间的机制。
这时,索引便登场了。
索引类型:B-Tree、GinIndex与BrinIndex
什么是索引?
对于不断增长的数据量,索引能够快速访问单个(或多个)项目,而不会显著降低速度。这也被称为“随机访问”。你很快就会明白为何如此称呼。首先,让我们看看现代数据库系统中最常见的索引类型。
B-Trees / B +树
目前最常见的索引类型是B-Tree索引,更准确地说,是B+树索引。
它们以发明者之一Rudolf Bayer命名,或者因为它们是自平衡的。具体命名来源并不清楚,但这并不重要。自平衡意味着树具有特定的时间保证:对于B树而言,最关键的是索引的大小不影响查询时间,无论索引规模如何,相同大小的索引查询耗时相同。你接下来会看到这一点。
就像所有的树(无论是计算机科学还是自然界中)一样,你以一个根节点开始。计算机科学与自然界的区别在于,在计算机科学中,我们将树的根部置于顶部。
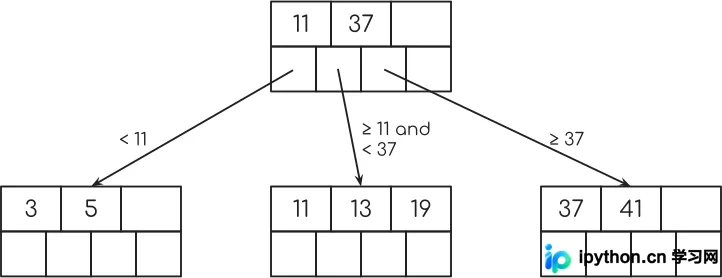
随意摆放。这是一个3级B+树的根节点示意图。
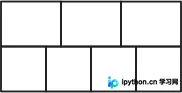
等级3意味着该节点可以包含3个键。这就是节点顶部的3个方框的用途。下方的4个方框保存指向另一个节点的指针,或者指向数据库表中的一行数据。
现在,假设你在此节点中拥有密钥11和37,但没有第三个密钥。
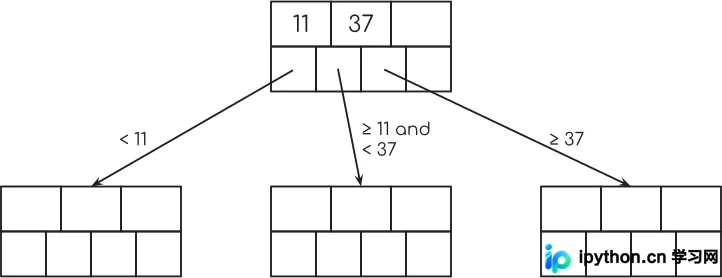
那么,最左边的指针指向一个节点,其键小于11;第二个指针指向一个节点,其键大于或等于11且小于37;第三个指针指向一个节点,其键大于或等于37。
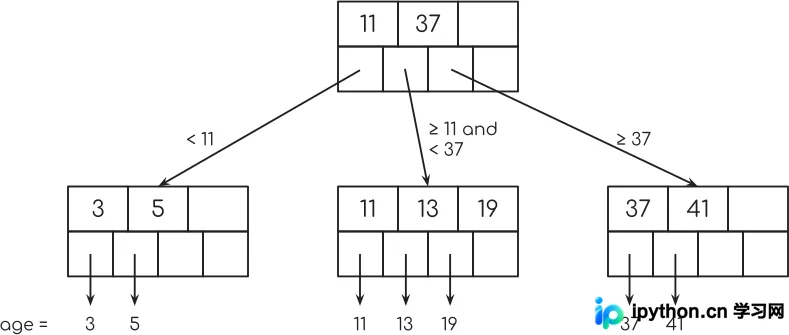
从我在开头展示的表格年龄列索引来看,结构可能如下所示。
接下来的关键之处在于第二行节点中的指针。每一个指针都指向表中具有特定键值的单个行,在我们的示例中,这个键值是年龄。
但不仅如此。
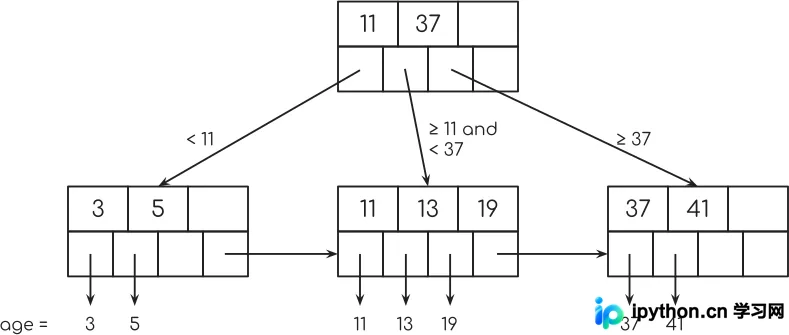
你会注意到每个底层节点中的最后一个指针指向下一个节点。这用于“索引扫描”,我稍后会回来详细解释。
让我们更详细地查看第二排节点。
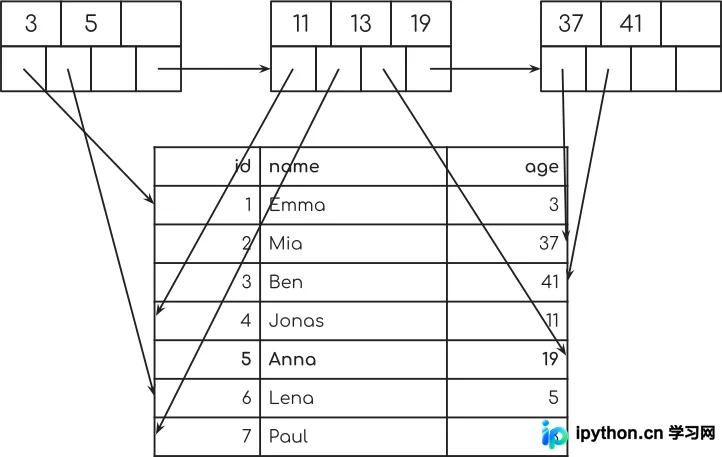
你现在可以看到,来自其中一个树节点的每个指针如何指向表中的单个行。
你还可以看到,来自树节点的这些指针如何随机地指向表中的某些行。这就是为什么这被称为“随机访问”。数据库在数据库表中随机跳转。
随机访问查找
让我们用之前的SQL查询来刷新一下记忆。
SELECT * FROM people WHERE age = 19那么,索引如何帮助更快地找到相应的行呢?
让我们来看看这棵树:
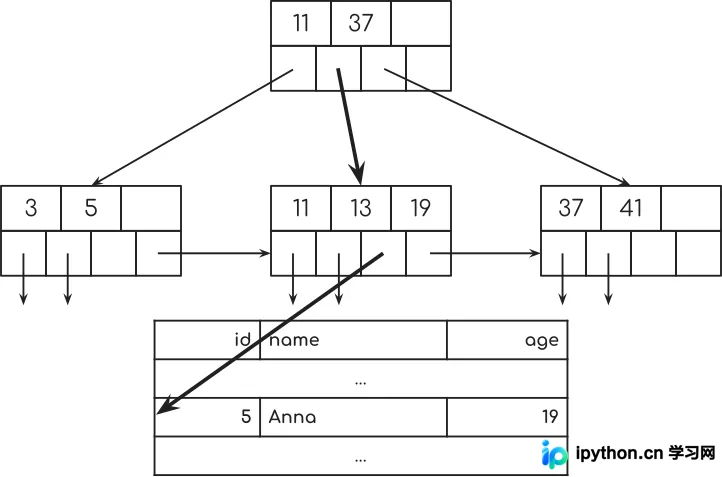
它需要1步从第一个节点到第二个节点,以及从第二个节点到数据库表中的行只需1秒(此处原文意指极短时间或单步操作,结合上下文应理解为步骤少)。
请记住,如果不使用索引,我们必须查看所有7行以查看它们是否与数据库查询匹配。
而且由于19这个指数中没有更多的关键节点,我们就完成了查找。
索引扫描
现在,回到“索引扫描”。假设你想要计算从5岁到13岁开始编码的人数。
SELECT COUNT(*) FROM people WHERE age BETWEEN 5 AND 19;
SELECT COUNT(*) FROM people WHERE age >= 5 AND age <= 19;
数据库将查找密钥5,然后使用指向下一个节点的指针查找更多密钥。
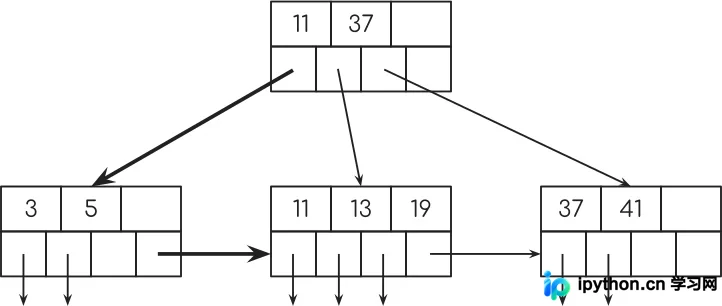
而且因为数据库所需的所有查询信息都在索引中,所以数据库根本不会查看表。
Django中的索引实现与GSoC贡献
索引非常棒
让我们看看如何在Django中使用它们。
实际上,我们已经做到了。
有几种方式:
- db_index = True,你可以在模型字段上设置
- index_together = (('name', 'age'),),你可以在模型的Meta类中设置
- ForeignKey() / OneToOneField()使用索引快速查找相关表中的数据
- primary_key = True,Django自动使用AutoField表示每个模型上的id列。
这已经很棒了。但是这个功能集有点限制。那里不仅有B+树索引。还有一吨多
2016
我们来看看2016年。
马克·坦林和我有索引的想法。实际上,Marc在他的contrib.postgres工作中已经有了一些想法。我们有关于API的想法。我们希望在Django中拥有的东西。像,让我们让Django支持所有的索引。
但是我们没有时间去实现我们的想法!
但我们很幸运。事实上,Django项目很幸运。
Google Summer of Code 2016
Django再次被接受为Google Summer of Code的组织。谢谢Google!
对于那些不知道这是什么的人:谷歌支付学生3个月的时间在开源项目上工作,同时由项目贡献者进行指导。
大多数情况下,Tim Graham,还有Marc和我辅导学生Akshesh Doshi在Django中处理更通用的索引支持。从写下API等提议,直到最终合并到Django中。
GSoC 2016的主要成果是django.db.models.indexes.Index(fields,name)(docs)
它定义了所有索引的基类。您可以通过模型的Meta类中的索引选项使用它们。
例如像这样:
from django.db import models

class Person(models.Model):
 name = models.CharField(max_length=200)

 class Meta:
  indexes = [
   models.Index(
    fields=['name'],
    name='name_idx',
   ),
  ]
这将在数据库表的名称列上创建一个B+树索引。
当然,这并不是什么新鲜事。这就是在名称字段中使用db_index = True时可以执行的操作。
您当然也可以在多列上定义索引:
from django.db import models

class Person(models.Model):
 name = models.CharField(max_length=200)
 age = models.PositiveSmallIntegerField()

 class Meta:
  indexes = [
   models.Index(
    fields=['name', 'age'],
    name='name_age_idx',
   ),
  ]
当然,这也不是什么新东西。你可以用index_together来完成。
但你现在也可以这样做:
from django.contrib.postgres.fields import JSONField
from django.contrib.postgres.indexes import GinIndex
from django.db import models

class Doc(models.Model):
 data = JSONField()

 class Meta:
  indexes = [
   GinIndex(
    fields=['data'],
    name='data_gin',
   ),
  ]
定义一个GinIndex。这是PostgreSQL特有的。但这是你以前无法做到的事情。至少不可靠,没有太多的痛苦。
GinIndex可用于索引JSON blob中的键值。因此,您可以筛选表中JSONB字段中的键映射到特定值的表中的行。这就像“NoSQL 1-0-1”。
Django 1.11附带的另一种内置索引类型是BrinIndex,简单地说,它可以允许更快地计算聚合。比如,找出每篇文章最后一次购买的时间。
而且由于索引是数据库模式的一部分,显然通过迁移来追踪索引。因此,当您运行python manage.py migrate时会创建索引:
BEGIN;
--
-- Create model Doc
--
CREATE TABLE "someapp_doc" (
 "id" serial NOT NULL PRIMARY KEY,
 "data" jsonb NOT NULL);
--
-- Create index data_gin on field(s) data of model doc
--
CREATE INDEX "data_gin" ON "someapp_doc" USING gin ("data");
COMMIT;
Django 2.0展望:功能索引与重构计划
特色创意
大。
这就是昨天发布的Django 1.11。
但是Django 2.0有什么用?
什么在地平线上?
我们最终想要什么?
功能索引
它们在各种情况下都很有用,在这种情况下,您不希望对原始值进行索引,但可以对其进行变化,例如字符串的小写。我已经在为此工作。我还没到。我很想从理解表达式API的人那里获得帮助。
from django.db import models

class Author(models.Model):
 name = models.CharField(max_length=200)

 class Meta:
  indexes = [
   FuncIndex(
    expression=Lower('name'),
    name='name_lower_idx',
   ),
  ]
db_index = <IndexClass>
如前所述,对单个列使用索引可能非常麻烦。因此,让我们支持Index类作为db_index的一个属性。
from django.db import models

class Author(models.Model):
 name = models.CharField(
  max_length=200,
  db_index=HashIndex
 )
对某些领域有一个B+树是没有意义的。如前所示,GinIndex对于JSONField来说非常完美。为什么不在db_index = True时使用每个字段类的default_index_class?
from django.contrib.postgres.fields import JSONField
from django.contrib.postgres.indexes import GinIndex
from django.db import models

# Somewhere in Django's JSONField implementation:
# JSONField.default_index_class = GinIndex

class Document(models.Model):
 data = JSONField(db_index=True)
重构index_together和db_index
这个比面向用户更引人注目:
我可以想象,db_index和index_together在内部使用Model._meta.indexes可能是有意义的。这是要调查的东西。
GiSTIndex
PostgreSQL中有一个GiSTIndex,可用于地理空间查询,例如“给我所有与给定点最大距离为10的点”。这不是在Django 1.11中。我不知道为什么,但我猜是因为没有人添加它。
请注意,Django 2.0不再支持Python 2了!
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















